
m-a-p/PIN-14M
收藏官方服务:
资源简介:
PIN-14M数据集是一个包含14M样本的多模态文档数据集,涵盖了8个子集,如PIN-PMC、DocLayNet、Linux-CN等。每个样本包含文本内容、内容图像和整体图像,并以JSONL格式存储。数据集主要用于多模态文档处理,支持中英文语言。
PIN-14M数据集是一个包含14M样本的多模态文档数据集,涵盖了8个子集,如PIN-PMC、DocLayNet、Linux-CN等。每个样本包含文本内容、内容图像和整体图像,并以JSONL格式存储。数据集主要用于多模态文档处理,支持中英文语言。
提供机构:
m-a-p原始信息汇总
PIN-14M 数据集概述
数据集简介
PIN-14M 是 "PIN: A Knowledge-Intensive Dataset for Paired and Interleaved Multimodal Documents" 的一个迷你版本,包含 1400 万个样本,采用 PIN 格式。
数据集统计
数据集包含多个子集,每个子集的文档数量、图片数量和存储空间如下:
| 子集 | 文档数量 (#) | 总体图片数量 (#) | 内容图片数量 (#) | 文档大小 (GB) | 总体图片大小 (GB) | 内容图片大小 (GB) |
|---|---|---|---|---|---|---|
| pg19 | 2,612,285 | 2,608,029 | 0 | 12.3 | 1,418.1 | 0.0 |
| OBELICS | 5,795,198 | 5,770,432 | 5,840,658 | 13.0 | 3,141.4 | 3,305.3 |
| mmc4-core-ff | 5,351,628 | 5,277,983 | 9,014,579 | 33.7 | 3,232.0 | 5,605.0 |
| chinese-markdown | 168,323 | 167,989 | 106,768 | 1.3 | 773.2 | 15.0 |
| leetcode | 2,360 | 2,360 | 0 | 0.016 | 1.3 | 0.0 |
| linux-cn | 9,564 | 9,564 | 38,960 | 0.082 | 11.9 | 1.8 |
| DocLayNet | 68,757 | 69,375 | 90,259 | 0.18 | 25.9 | 1.6 |
| PIN-PMC | 99,157 | 1,074,799 | 454,482 | 2.8 | 724.2 | 29.5 |
| 总计 | 14,107,272 | 14,980,531 | 15,545,706 | 63.4 | 9,328.0 | 8,958.3 |
存储空间统计可能存在误差,仅供参考。
数据结构
子集
数据集包含 8 个子集,包括 PIN-PMC、DocLayNet、Linux-CN、chinese-markdown、OBELICS、MMC4、leetcode 和 PG19。
文件夹结构
数据集的文件夹结构如下:
content_image文件夹:包含 markdown 文件中提到的所有内容图片。overall_image文件夹:包含每个样本的总体图片。JSONL文件:包含文本内容及相关数据细节。
示例子集结构:
example_dataset/ │ ├── content_image/ ├── overall_image/ └── example_dataset.jsonl
JSON Lines 格式
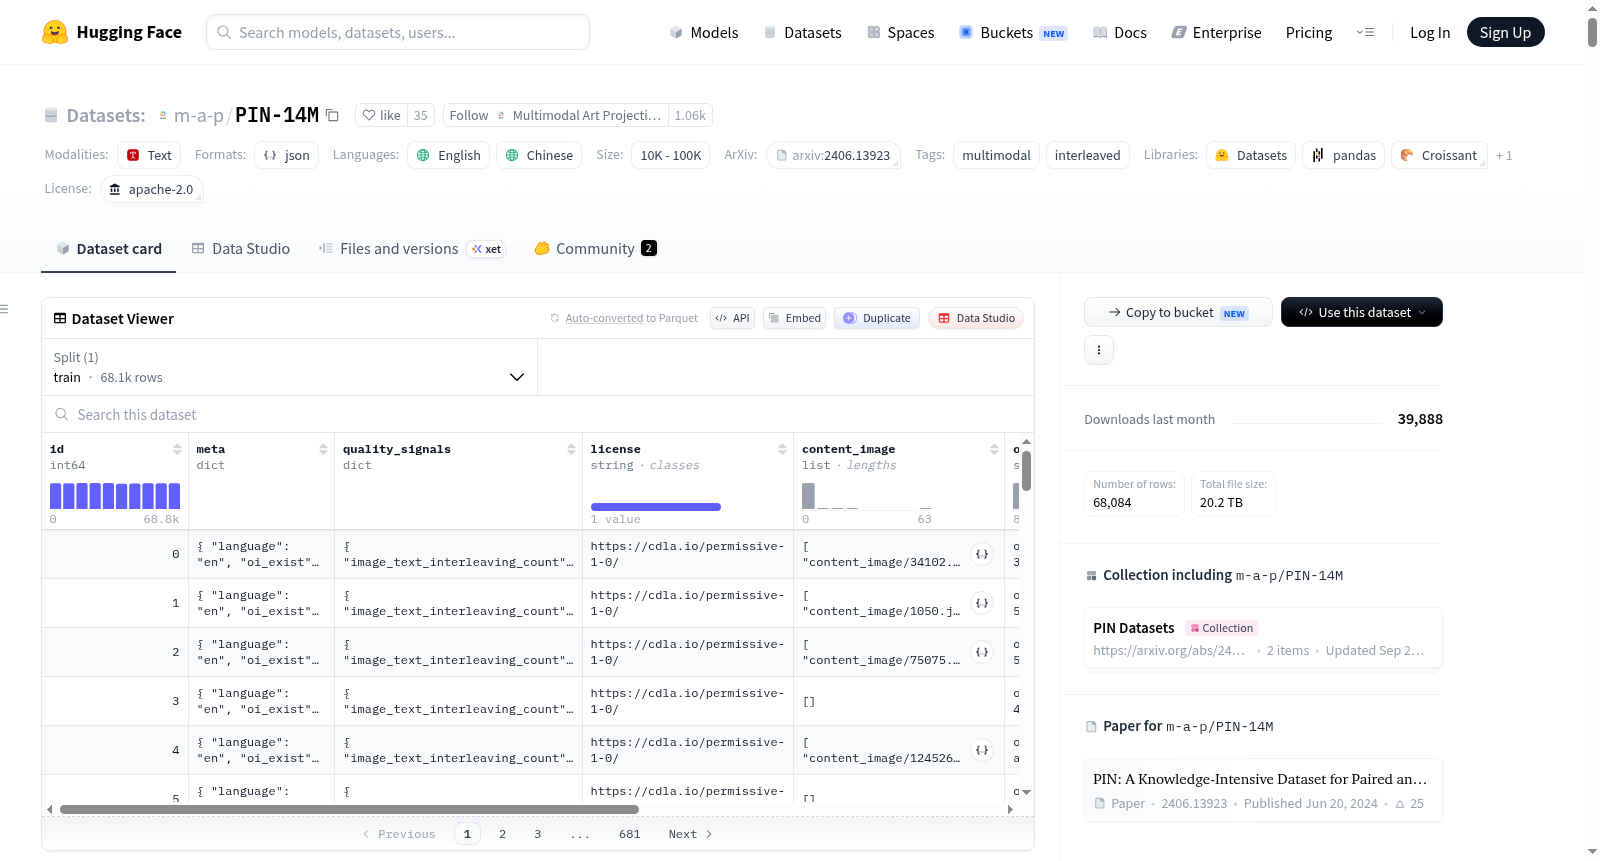
每个数据条目包含以下字段:
- id:唯一标识符。
- meta:元数据,包括语言、文档来源、文档ID、页面ID、下载日期等。
- quality_signals:质量指标。
- content_image:内容图片列表。
- overall_image:总体图片路径。
- md:markdown 内容。
- license:许可证信息。
示例
数据集提供了多个子集的示例,包括 DocLynet、OBELICS、chinese-markdown、leetcode 和 linux-cn 等。每个示例展示了 JSONL 文件的结构和内容。
搜集汇总
数据集介绍
构建方式
PIN-14M数据集是基于知识密集型多模态文档理解需求而构建的大规模语料库,其构建过程融合了九个异构子集的系统性整合。这些子集涵盖英文与中文资源,包括PG19、OBELICS、MMC4-core-ff、Chinese-Markdown、LeetCode、Linux-CN、DocLayNet、PIN-PMC以及PIN-Arxiv。数据以统一格式组织,每个样本包含Markdown格式的文本主体、内容级图像列表以及文档级整体图像,并辅以丰富的元数据和质量信号。图像均转换为PNG格式,以确保兼容性。数据集采用JSON Lines格式存储,便于高效解析与处理,整体规模达1400万样本,存储空间约18.79 TB。
特点
该数据集的核心特点在于其多模态交错结构,每个样本不仅包含文本与图像的对齐关系,还提供了整体图像以呈现文档的全局视觉布局。数据集内置了全面的质量信号体系,涵盖文本块数量、图文交错频率、令牌总数、标记统计等指标,支持用户快速评估样本质量并进行精细筛选。此外,数据集覆盖了学术论文、技术文档、编程题解、新闻文章等多种领域,语言支持英文与中文,展现了极强的领域多样性与知识密度。每个样本还保留原始来源元数据,便于溯源与进一步研究。
使用方法
使用PIN-14M数据集时,推荐通过Hugging Face CLI工具进行下载,可选择下载全部文件或仅获取JSON Lines文件以节省带宽。下载后需合并并解压分卷压缩包以恢复完整目录结构。数据集以子集为单位组织,每个子集包含content_image、overall_image文件夹及对应的JSONL文件。用户可依据quality_signals字段中的指标(如doc_length、total_token_count)进行数据过滤,以适配不同下游任务需求。数据加载时,需解析JSONL文件中的md字段获取文本,并关联content_image与overall_image路径以获取图像数据,从而构建多模态输入样本。
背景与挑战
背景概述
PIN-14M数据集由多模态研究团队于2024年发布,旨在应对多模态文档理解中知识密集型任务的迫切需求。该数据集整合了来自DocLayNet、OBELICS、MMC4等九个子集的逾1400万样本,涵盖学术论文、技术文档、编程题解及中英文网页等多种类型。其核心研究问题聚焦于如何构建图文交错且富含语义关联的高质量多模态数据,以支撑大语言模型在文档级理解、跨模态推理等前沿领域的训练与评测。作为PIN项目的精简版本,该数据集提供了约18.79TB的存储规模,并创新性地引入了质量信号字段,为后续多模态文档研究提供了标准化基准,显著推动了领域内数据构建与模型评估的规范化进程。
当前挑战
当前主要挑战包括:其一,领域问题层面,多模态文档理解面临图文语义对齐的深层困境,现有模型难以精准捕捉文本与图像间的互指关系及逻辑递进,尤其在高知识密度的学术文献和技术手册中表现欠佳。其二,数据构建层面,海量异构来源的整合带来质量控制的艰巨任务,如不同子集的图像格式、元数据字段及许可协议的规范化处理,以及内容图像与整体图像在视觉呈现上的一致性维护。此外,部分子集(如中文Markdown)存在标注噪声和图像缺失问题,需依赖复杂的质量信号过滤机制进行修正,而跨语言场景下的语义保真度与数据平衡性亦构成持续优化的难点。
常用场景
经典使用场景
PIN-14M数据集是面向多模态交错文档理解与生成任务的大规模知识密集型语料库,其经典使用场景聚焦于训练能够同时处理文本与图像交错排列的通用多模态大语言模型。该数据集整合了来自PG19、OBELICS、MMC4、DocLayNet等九个高质量子集的逾1400万样本,涵盖学术论文、技术博客、编程题解及中文技术文档等多元体裁。研究者可借助其统一的PIN格式,利用包含文本块与内嵌图像的Markdown结构,以及全局页面截图与内容截图的双重视觉表征,训练模型理解文档的视觉布局与语义逻辑的耦合关系。这种设计使得模型在图文交错场景下的零样本推理能力得到显著提升,成为多模态预训练与指令微调任务中的基准数据源。
解决学术问题
该数据集系统性地解决了多模态大模型研究中知识密集型文档的语义对齐与跨模态表征学习难题。传统数据集往往侧重单一图像-文本对,难以捕捉真实文档中图像与文字交替出现的复杂逻辑关系。PIN-14M通过提供丰富的质量信号(如图文交错频次、文本块长度分布、标题层级统计等),使得研究者能够量化评估样本的语义密度与结构复杂度,进而探究不同交错模式对模型理解能力的影响。这一设计推动了多模态因果推理、文档级视觉问答、以及长文本与图像联合生成等前沿课题的进展,为评估模型在学术论文、技术手册等知识密集型场景下的表现提供了标准化的实验平台。
衍生相关工作
该数据集衍生了多项具有影响力的学术工作,其中最具代表性的是其原始论文《PIN: A Knowledge-Intensive Dataset for Paired and Interleaved Multimodal Documents》,该研究首次提出了PIN格式并系统论证了交错图文数据对模型性能的提升效果。后续工作包括基于PIN-14M进行多模态大模型的指令微调优化,以及利用其质量信号设计自适应样本筛选策略的研究。此外,该数据集被广泛应用于多模态检索增强生成(RAG)任务的基准测试中,推动了文档级跨模态检索与生成一体化模型的发展,并催生了针对中文技术文档的专用多模态预训练模型。
以上内容由遇见数据集搜集并总结生成


