遇见数据集

sileod/probability_words_nli

收藏
Hugging Face2023-09-06 更新2024-03-04 收录
官方服务:

资源简介:

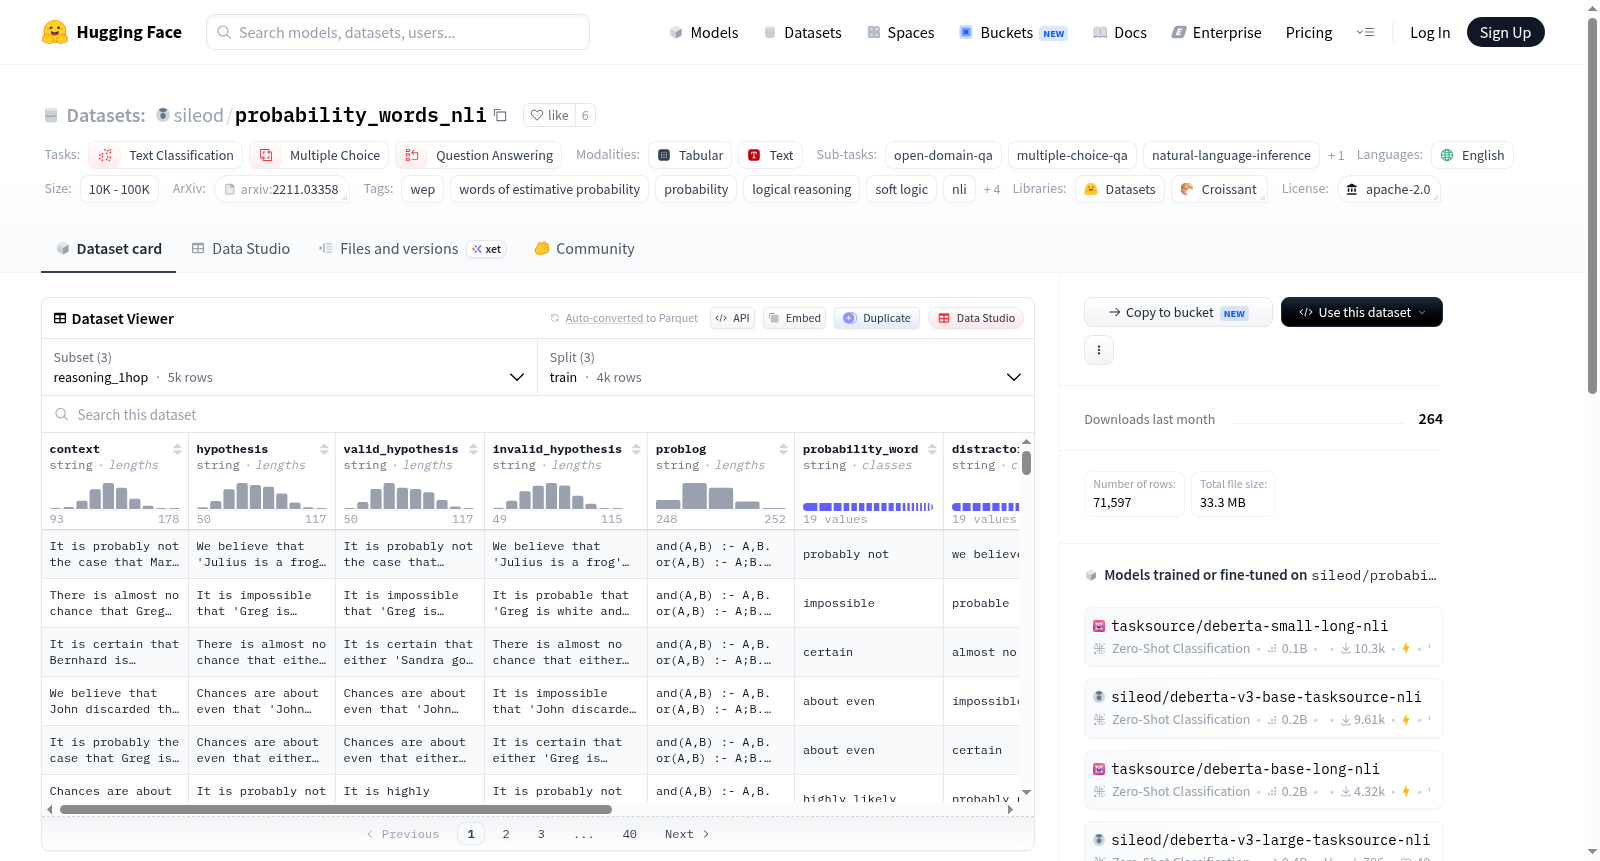
该数据集用于测试语言模型在正确捕捉表示概率的词汇(WEP,也称为口头概率)含义方面的能力,例如probably、maybe、surely、impossible等词汇。我们使用概率软逻辑结合了用WEP表达的概率陈述(WEP-Reasoning),并使用了UNLI数据集直接检查模型是否能检测到与人类标注概率匹配的WEP。数据集可用作自然语言推理数据(上下文、前提、标签)或多选题回答(上下文、有效假设、无效假设)。

This dataset is designed to evaluate the capability of language models to correctly comprehend the meanings of probability-expressing words (WEP, also referred to as verbal probability), such as probably, maybe, surely, impossible, and similar terms. We employ Probabilistic Soft Logic to integrate probabilistic statements expressed via WEP (WEP-Reasoning), and utilize the UNLI dataset to directly verify whether models can detect WEP that aligns with human-annotated probabilities. This dataset can serve as either natural language inference data (context, premise, label) or for multiple-choice question answering tasks, with the format of (context, valid hypothesis, invalid hypothesis).

提供机构:
sileod
原始信息汇总

数据集概述

基本信息

  • 名称: probability_words_nli
  • 语言: 英语 (en)
  • 许可证: Apache-2.0
  • 多语言性: 单语种
  • 数据集大小: 1K<n<10K
  • 数据来源: 原始数据

任务与应用

  • 任务类别:
    • 文本分类
    • 多选题
    • 问答
  • 具体任务:
    • 开放领域问答 (open-domain-qa)
    • 多选题问答 (multiple-choice-qa)
    • 自然语言推理 (natural-language-inference)
    • 多输入文本分类 (multi-input-text-classification)

数据集结构

  • 训练与评估配置:
    • 配置: usnli, reasoning-1hop, reasoning-2hop
    • 任务: 文本分类
    • 任务ID: 多类分类 (multi-class-classification)
    • 数据分割:
      • 训练集: train
      • 评估集: validation
    • 列映射:
      • sentence1: context
      • sentence2: hypothesis
      • label: label
    • 评估指标:
      • 准确率 (Accuracy)
      • F1 二分类 (F1 binary)

数据集用途

  • 测试语言模型对表示概率的词汇(如“可能”、“也许”、“肯定”、“不可能”)的理解能力。
  • 使用概率软逻辑结合概率陈述,以及使用UNLI数据集直接检查模型是否能检测到与人类注释概率匹配的WEP。
  • 可用作自然语言推理数据或多选题问答。
搜集汇总
数据集介绍
sileod/probability_words_nli 数据集图片
构建方式
在自然语言处理领域,概率词汇(Words of Estimative Probability, WEP)如“probably”、“maybe”等,在人类沟通中承载着微妙的不确定性表达。该数据集sileod/probability_words_nli的构建融合了专家生成与众包标注的双重智慧。其核心方法基于概率软逻辑(Probabilistic Soft Logic),将包含WEP的概率性陈述进行逻辑组合,形成推理样本。同时,数据集借鉴了UNLI数据集(https://nlp.jhu.edu/unli/)的架构,直接检验模型能否将WEP与Fagen-Ulmschneider(2018)提供的人类标注概率相匹配。最终,数据以自然语言推理(NLI)格式呈现,包含前提、假设和标签三元组,并衍生出多选问答形式,为评估语言模型对概率词汇的理解提供了严谨的测试基准。
特点
该数据集的核心特色在于其精巧的层次化推理设计,专门用于探测语言模型对概率词汇的语义捕获能力。它包含三种配置:usnli(基于UNLI的直接匹配)、reasoning-1hop(单跳推理)和reasoning-2hop(双跳推理),从而由浅入深地评估模型从简单概率对应到复杂逻辑演绎的全面能力。所有样本均基于专家验证的WEP概率映射,确保了标签的可靠性。此外,数据集规模虽小(1K至10K样本),但高度聚焦,避免了冗余噪声,使其成为评估概率推理这一精细认知任务的理想工具。其多任务兼容性(文本分类、多选问答)进一步增强了实用性。
使用方法
该数据集的使用灵活多样,可轻松集成到主流NLP框架中。用户可通过HuggingFace Datasets库直接加载,并指定配置(如‘usnli’、‘reasoning-1hop’)以适配不同评估目标。对于文本分类任务,可将‘sentence1’作为上下文、‘sentence2’作为假设,利用标签进行多类分类训练或评估。对于多选问答,则通过‘valid_hypothesis’和‘invalid_hypothesis’字段构建候选答案。官方提供了Colab示例代码(https://colab.research.google.com/drive/10ILEWY2-J6Q1hT97cCB3eoHJwGSflKHp?usp=sharing),详细展示了数据加载、模型微调及指标计算(准确率、F1分数)的完整流程,便于研究者快速上手并复现论文实验。
背景与挑战
背景概述
在自然语言处理领域,语言模型对不确定性表达的精确理解是衡量其语义推理能力的关键维度。概率性词汇(Words of Estimative Probability, WEP),如“probably”、“maybe”、“surely”等,在人类交流中承载着微妙的概率判断,然而语言模型对此类词汇的掌握程度长期缺乏系统的评估基准。由Damien Sileo与Marie-francine Moens于2023年构建的probability_words_nli数据集,旨在填补这一空白。该数据集源自对神经语言模型进行概率性词汇理解的探测研究,联合了概率软逻辑推理与UNLI数据集中的专家标注,通过自然语言推理与多项选择问答任务,系统性地检验模型在概率语义上的认知边界。其发布为评估语言模型在不确定性推理、软逻辑与常识概率判断上的表现提供了标准化测试平台,对推动可解释性与鲁棒性语言模型的发展具有重要影响力。
当前挑战
该数据集所解决的领域核心挑战在于,语言模型往往难以区分语境中概率性词汇的细微语义差异,例如“likely”与“probably”在人类认知中的概率赋值可能相近但不等同,而模型常将其混为一谈。此外,概率推理涉及多跳逻辑组合,例如从“A很可能导致B”与“B几乎不可能发生”中推断A的概率,这对模型的因果与概率链式推理能力提出了严峻考验。在构建过程中,挑战同样显著:一方面,需要将连续的数值概率精确映射到离散的WEP标签上,这依赖专家注释与统计校准,以避免主观偏差;另一方面,合成推理数据时如何确保逻辑一致性与语言自然性并存,避免生成脱离真实语境的伪例,也是设计中的关键难点。
常用场景
经典使用场景
在自然语言推理与多选问答的交叉领域中,sileod/probability_words_nli数据集被设计用于评估语言模型对概率词汇(如“probably”“maybe”“surely”)语义理解的精细程度。该数据集以概率软逻辑为理论框架,将包含概率词的自然语言陈述转化为可推理的软逻辑表达式,从而构建出兼具语义精确性与逻辑一致性的评测基准。经典使用场景包括:通过上下文与假设之间的蕴含关系分类任务,检验模型能否区分“likely”与“unlikely”等近义概率词在逻辑强度上的微妙差异;同时,以多选问答形式考察模型在给定语境下对有效与无效概率假设的判别能力,为语言模型在不确定性表达上的鲁棒性评估提供了标准化工具。
实际应用
在实际应用层面,该数据集所评测的能力直接关乎高风险场景中语言模型的可靠性。例如,在医疗诊断辅助系统中,模型需准确区分“该症状很可能提示疾病A”与“该症状可能提示疾病A”之间的置信度差异,以避免过度诊断或漏诊;在金融风险评估报告自动生成时,对“市场有较小概率出现波动”与“市场几乎必然出现波动”的语义误判可能导致投资策略的严重偏差。此外,在智能客服的情感分析、法律文书的义务程度判定以及气象灾害预警的措辞选择中,概率词汇的精确理解均构成人机信任的基础。因此,该数据集为部署于不确定性环境的NLP应用提供了关键的验证手段,确保模型输出的概率性表达与人类认知一致。
衍生相关工作
该数据集衍生了一系列具有代表性的研究工作。Sileo与Moens在2023年发表于*SEM的论文中,基于该数据集首次系统性地探针了BERT、RoBERTa等预训练模型对概率词汇的理解深度,发现模型虽能捕捉大致语义方向,但在细粒度概率等级排序上仍显著弱于人类。后续工作进一步扩展了该范式:例如,有研究将概率软逻辑框架引入对比学习,构建了面向概率推理的增强训练数据;另有团队基于此数据集开发了针对概率词的多任务学习模型,融合NLI与问答目标以提升推理一致性。此外,该数据集也被用作评估大语言模型(如GPT-4)在不确定性表达上校准能力的基准,推动了关于模型置信度与语言概率之间映射关系的研究,成为连接计算语言学与概率推理领域的重要桥梁。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务