
zlab-princeton/i1-gptedit-tfrecord
收藏官方服务:
资源简介:
该数据集用于训练准备,将图像-标题对存储为TFRecords格式。这个HuggingFace数据集包含了对应于gptedit数据集的TFRecords,它作为一个示例,展示了按照我们的数据处理流程处理后数据集的样子。
To prepare the dataset for training, we store the image-caption pairs as TFRecords. This HuggingFace dataset contains the TFRecords corresponding to the `gptedit` dataset. It serves as an example to showcase what a processed dataset would look like following our data processing pipeline.
提供机构:
zlab-princeton搜集汇总
数据集介绍
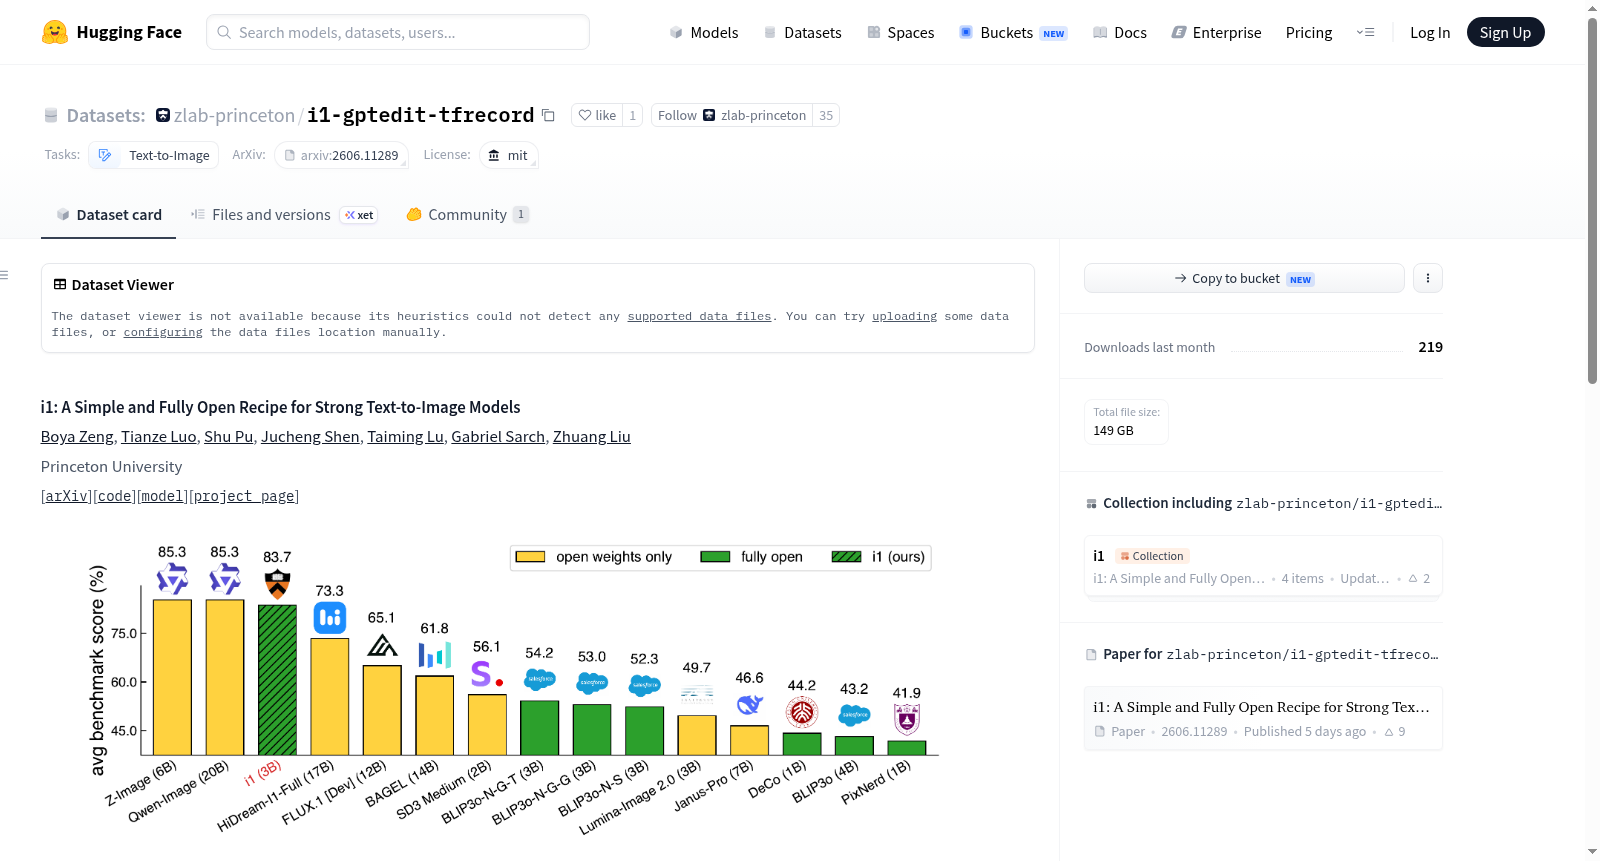
构建方式
i1-gptedit-tfrecord数据集源自一项旨在构建强大文生图模型的开放研究。为满足高效训练需求,团队将图像与文本描述配对,并存储为TFRecord格式。该数据集作为处理后的示例,遵循其数据预处理流水线,将原始语料统一编码为128个分片文件,并辅以TFDS元数据文件,确保后续加载与解码的标准化与便捷性。
使用方法
用户可通过HuggingFace Hub便捷下载该数据集。具体操作需先安装huggingface_hub库,然后使用hf download命令将数据集指定至本地目录。下载完成后,即可利用TensorFlow Datasets (TFDS) API读取TFRecord文件,配合i1项目的代码库与模型权重,直接开展文生图模型的训练或微调实验。
背景与挑战
背景概述
i1-gptedit-tfrecord 数据集由普林斯顿大学的研究团队于2026年发布,核心研究人员包括 Boya Zeng、Tianze Luo 等人。该数据集源于 i1 项目,旨在构建一个完全开源且性能卓越的文本到图像生成模型。作为 i1 模型训练流程的关键组成部分,该数据集存储了经过 GPT 编辑的图像-文本对,并以 TFRecord 格式封装,便于高效加载与训练。i1 项目通过提供可复现的数据处理流水线,推动了文本到图像生成领域的开放性与可访问性,为后续研究提供了标准化基准,显著降低了数据预处理的门槛,对相关领域产生了积极影响。
当前挑战
该数据集在构建过程中面临多重挑战:首先,文本到图像生成模型对图像-文本对的质量要求极高,如何从海量数据中筛选出语义对齐、细节丰富的配对,并利用 GPT 进行自动化编辑以提升描述准确性,是核心技术难题。其次,数据格式统一与存储效率的平衡至关重要,TFRecord 格式虽能加速 I/O 操作,但需要精心设计分片策略与元数据文件,确保数据在分布式训练场景下可靠加载与解码。此外,开放数据集的版权与伦理合规问题亦需审慎处理,以避免潜在的法律风险与偏见传播。
常用场景
经典使用场景
在文本到图像生成领域,预训练数据的质量与规模直接决定了模型能否精准捕获图文语义关联。i1-gptedit-tfrecord数据集以TFRecord格式封装了经由GPT编辑增强的高质量图像-文本对,为训练新一代扩散模型提供了标准化的数据基石。其经典使用场景在于作为i1系列文生图模型的训练数据源,利用该数据集可复现从零开始的完整训练流程,通过128个分片的高效并行读取机制,显著加速大规模分布式训练进程。
解决学术问题
该数据集直面当前文生图领域两大核心困境:一是公开数据集普遍存在标注噪声与图文对齐不足的问题,二是缺乏可复现的全开放训练管线。i1-gptedit-tfrecord通过引入GPT驱动的自动化文本重写策略,在不依赖人工标注的前提下系统性地提升了图文匹配质量。这一方案为后续研究者提供了可量化的数据增强范式,有效消解了数据版权与清洗门槛对学术探索的制约,推动了可复现、可验证的文生图研究生态建设。
实际应用
在实际应用中,该数据集可直接服务于高精度文生图模型的开发迭代。企业级创意设计工具可利用该数据训练的模型,根据用户输入的自然语言描述生成写实或风格化图像,降低专业设计门槛。广告与营销领域可基于此数据集微调模型,实现批量化的定制化视觉内容生成。科研机构则能将其作为基准测试集,评估不同文本编码器或去噪架构在统一数据条件下的生成性能差异。
数据集最近研究
最新研究方向
在文本到图像生成模型领域,i1-gptedit-tfrecord数据集代表了向完全开源、可复现的高质量模型训练配方迈出的关键一步。该数据集由普林斯顿大学研究团队构建,将经过GPT编辑优化的图文对存储为TFRecord格式,与i1文本到图像模型协同发布,旨在解决当前主流文生图模型在数据集处理与训练流程上不够透明的问题。此研究方向紧扣生成式人工智能开放科学的前沿热点,通过提供标准化的数据预处理流水线和可复用的TFRecord数据格式,推动社区在统一基准下进行模型能力对比与迭代。其影响在于降低了研究门槛,使小型实验室和独立开发者也能基于公开数据与配方训练出具有竞争力的模型,从而加速多模态生成技术在创意设计、虚拟内容制作等领域的实际落地。
以上内容由遇见数据集搜集并总结生成


