
遇见数据集

GSMA/Telco-Common-Corpus

收藏
Hugging Face2026-06-25 更新2026-07-22 收录
官方服务:

资源简介:

Telco Common Corpus (TCC) 是一个包含约100亿标记的完全开放、免费许可的电信知识集合,涵盖科学文献、专利、开放数据和开放网络项目,每个文档都经过许可证和来源验证。该数据集源于GSMA为电信行业推动AI发展的努力,旨在解决当前模型在真实电信任务(如网络管理)中的不足。数据来源多样,包括3GPP预备文档、RFC规范、IEEE开放获取论文、美国及欧盟专利、维基百科等,总计10,034,365,675个标记。数据处理使用内部管道进行高级解析,并主要针对英语文档。

Telco Common Corpus (TCC) is a ten billion tokens collection of fully open, free licensed telecommunications knowledge (scientific literature, patents, open data, and open-web projects) with licence and provenance verified at a document-level. It stems from GSMAs effort to make AI work for the telecom sector, addressing shortcomings in current models for real telecom tasks. The dataset features diverse sources including 3GPP preparatory documents, RFC specifications, IEEE open access papers, US and EU patents, Wikipedia, and more, totaling 10,034,365,675 tokens. Processing involves advanced parsing of documents and is primarily in English.
提供机构:
GSMA
搜集汇总
数据集介绍
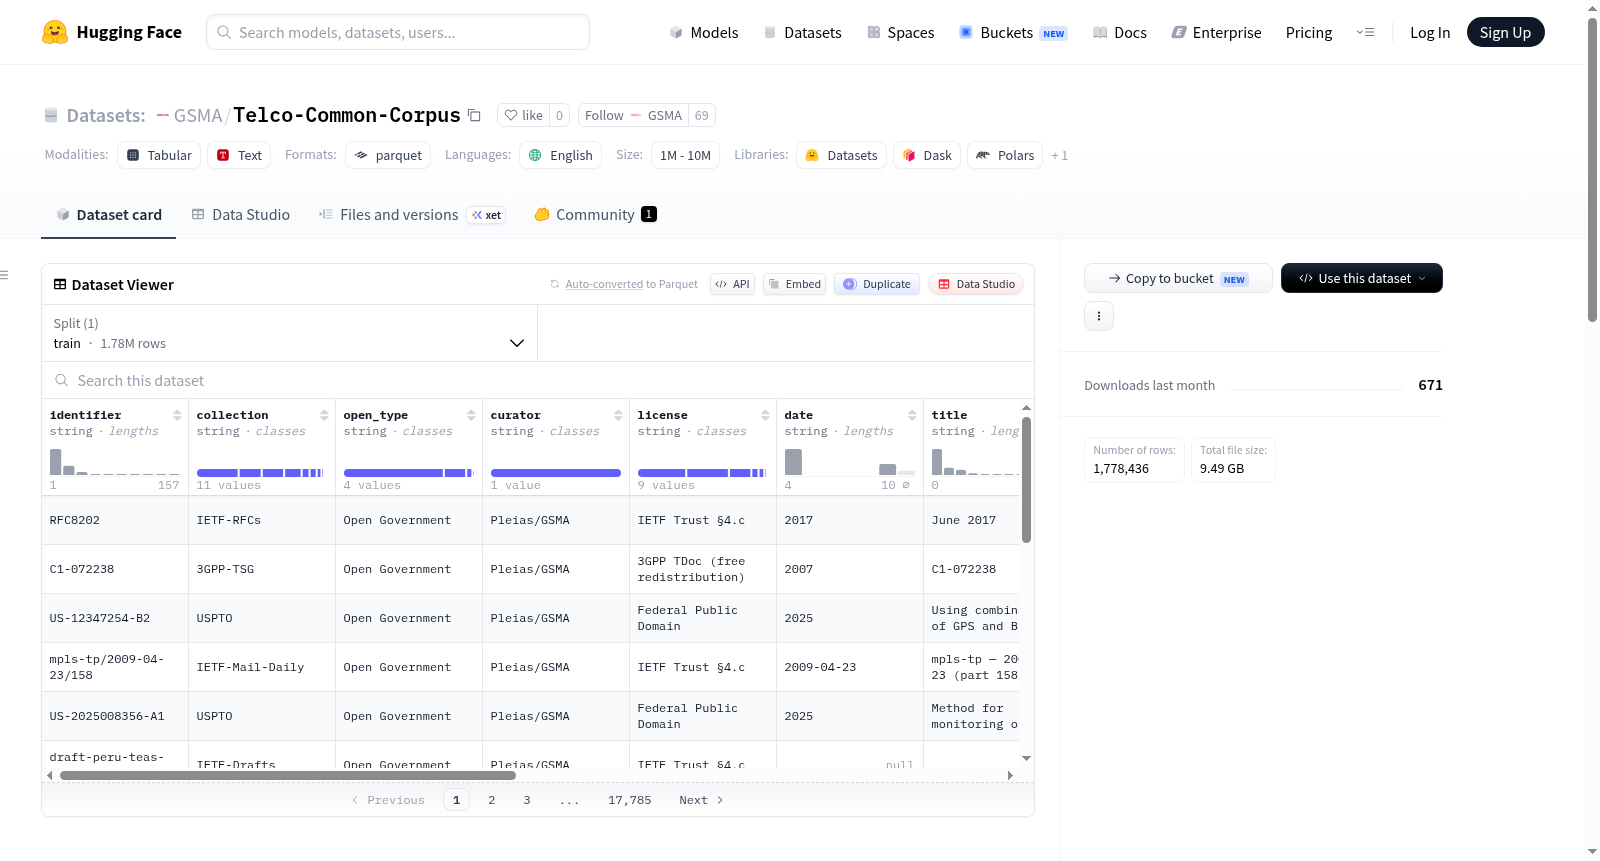
GSMA/Telco-Common-Corpus 数据集图片
构建方式
Telco-Common-Corpus(TCC)是一个包含一百亿词符的开源电信知识语料库,由GSMA主导构建,旨在推动人工智能在电信领域的应用。该数据集以文档级别严格验证许可和来源,整合了来自3GPP预备文件、RFC规范及草案、IEEE开放获取论文、OpenAlex中的开放获取文献、美国和欧盟专利、以及维基百科和维基数据中与电信相关的内容。语料来源涵盖同行评议文章、技术报告、标准项目成果、专利及公共领域政府研究,确保了丰富性与多样性。在数据处理上,TCC采用Pleias内部的Stratum流水线,借助开放权重的视觉语言模型(如dots.ocr)对PDF和DOC文档进行段落级解析,并保留表格等重要结构。最终,语料几乎全部为英文,少量多语言文档通过CommonLingua语言检测工具识别。
特点
TCC的核心特点在于其来源的多样性与全面的开放性。数据集整合了超过十亿词符的电信领域知识,涵盖3GPP标准文件、IETF RFC规范、IEEE开放获取期刊、以及美国和欧盟专利等,每项来源均具有明确的许可标识(如公共领域、CC-BY、CC0等),确保合法可用。此外,TCC的构建背景源于GSMA发起的一项评估,该评估发现现有模型在电信任务(如网络管理)上表现不足且近年无明显进步,因此TCC专门针对电信领域设计,以填补该垂直领域的高质量语料空白。其文档级别的许可验证和精细的解析流程,使得该语料在科学研究和工业应用中具有高度可靠性与实用性。
使用方法
TCC适用于电信领域的多种自然语言处理任务,包括但不限于大型语言模型的预训练与微调、电信标准文本的分析与生成、以及专利和学术文献的语义理解。用户可以直接从HuggingFace数据集页面下载完整的百亿词符语料,或根据具体需求选择特定来源子集(如仅3GPP文件或IEEE论文)。数据集以英文为主,采用标准格式存储,可轻松集成到现有的深度学习框架(如Transformers、PyTorch)中。建议在使用前通过CommonLingua工具过滤可能包含的多语言内容,以确保输入的一致性。同时,由于语料中包含大量结构化表格和标准文档,推荐利用视觉语言模型进行进一步的特征提取,以充分发挥其在电信专业任务中的潜力。
背景与挑战
背景概述
Telco Common Corpus(TCC)是由GSMA主导,联合Pleias等机构于近年创建的十亿级Token电信领域语料库,旨在解决通用大语言模型在电信专业任务中表现不佳的痛点。该数据集收录了3GPP标准文档、IETF RFC规范、IEEE开放论文、美国及欧洲专利、维基百科等多样化来源,所有内容均经过文档级许可与来源验证。TCC的出现填补了电信领域高质量开放语料的空白,为构建领域专用模型提供了关键数据基础,并推动了Open Telco AI倡议的发展,显著提升了电信知识在人工智能研究中的可及性与规范性。
当前挑战
当前电信大语言模型面临的核心挑战在于通用模型对网络管理、频谱分析等专业任务的理解深度不足,且近两年性能进步缓慢。TCC的构建过程中面临多重困难:首先,多数来源为PDF或DOC格式的非结构化文档,需借助先进的视觉语言模型(如dots.ocr)进行段落级解析以保留表格等复杂结构;其次,需要严格验证每份文档的版权与许可状态,确保数据合法性;最后,在去重与多语言处理方面,采用SOTA语言检测工具CommonLingua进行精准过滤,以维持语料的英语主导性与纯度。
常用场景
经典使用场景
Telco-Common-Corpus(TCC)作为电信领域首个十亿级开放语料库,其经典使用场景在于为大规模预训练语言模型提供专业化的电信知识训练数据。研究人员可利用该数据集对通用大语言模型进行领域微调,使其掌握从3GPP标准文档、IETF规范到IEEE开放论文中的技术术语、协议逻辑与网络架构知识,从而构建能够理解并生成电信领域专业文本的基础模型。
衍生相关工作
TCC的问世已催生多项衍生性研究脉络:一方面,GSMA基于该语料库构建了Open-Telco LLM Benchmarks评测体系,用于量化模型在基站配置、干扰管理等任务上的表现;另一方面,Pleias团队利用分层视觉语言模型解析文档结构的预处理方法,为PDF类型学术资料的自动化清洗提供了可迁移的技术范式。此外,该数据集也激发了关于电信领域小样本学习与持续预训练策略的后续探索。
数据集最近研究
最新研究方向
Telco-Common-Corpus的发布标志着电信领域专用大语言模型训练数据的重大突破,该数据集汇聚了千亿级别的高质量、开源许可的电信知识资源,涵盖3GPP标准文档、IETF规范、IEEE开放论文及美欧专利等多元来源。当前研究前沿聚焦于利用该语料库克服通用大模型在电信任务上的表现瓶颈——已有基准测试揭示现有模型在网络管理与运维等真实场景中能力停滞,TCC的精细文档级授权验证与结构化处理(如表格保留)为构建领域专用模型提供了可靠基石,有望推动电信AI从通用能力向专业深度跃迁,助力下一代智能网络自动化和标准化演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

