faroese-eysturkommuna-fo
收藏资源简介:
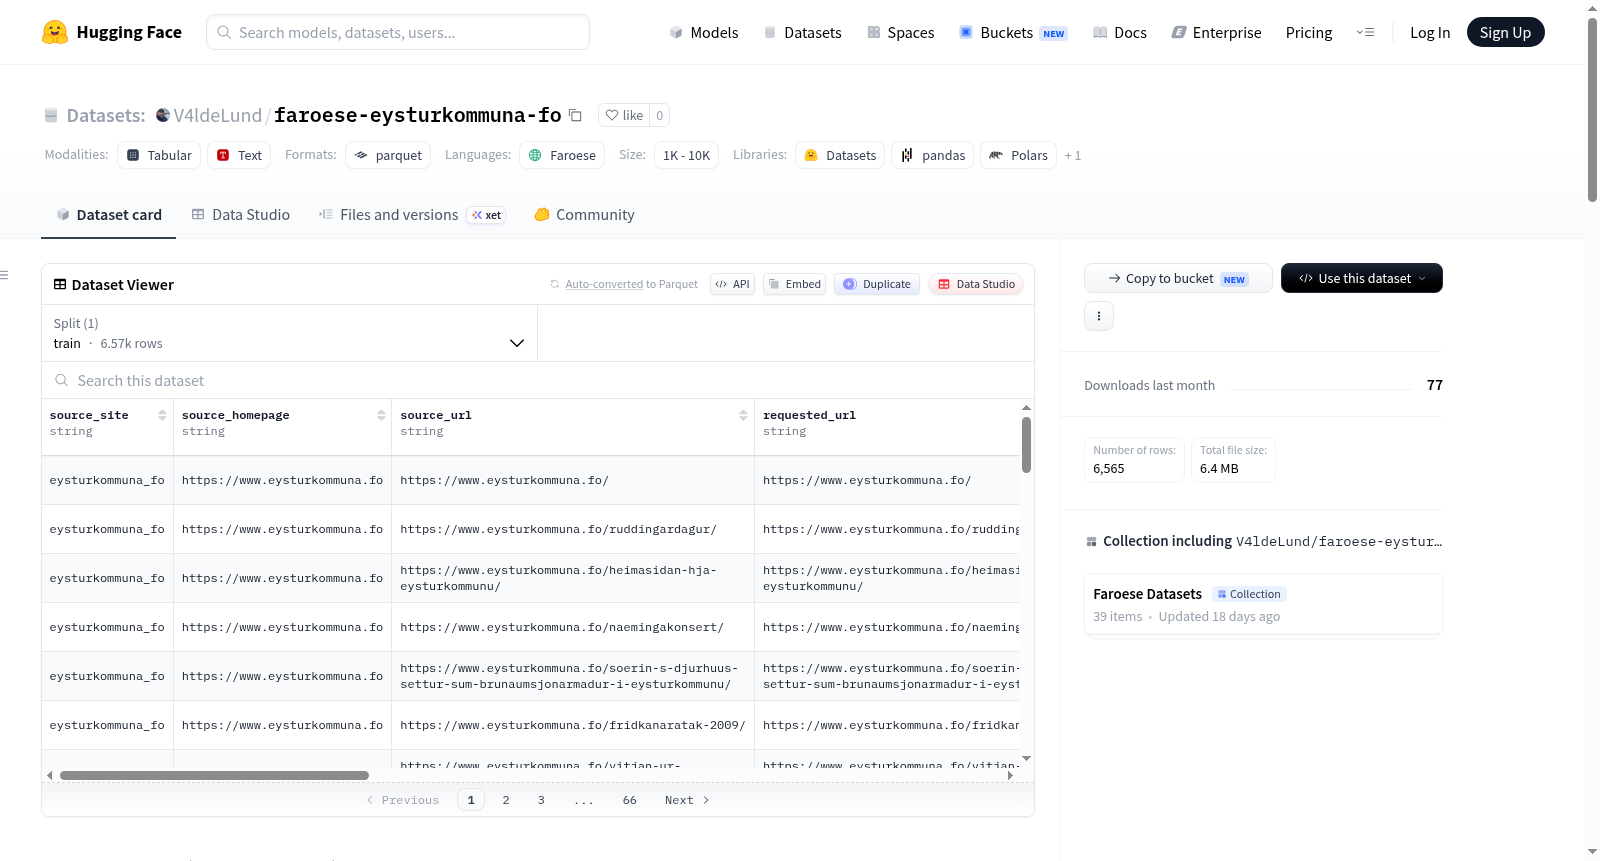
Eysturkommuna 数据集(eysturkommuna_fo)是一个从法罗群岛 Eysturkommuna 市政网站收集的档案数据集。该数据集包含 HTML 页面、理事会材料、PDF、DOCX 文件、新闻、计划和服务内容,旨在提供法罗语公共文档的语料。数据规模为 6,565 个文档,共计约 22,104,698 个字符和 10,719,723 个 token(使用 Llama-3-8B-instruct 分词器计算)。其中 HTML 文档 5,921 个,PDF 文档 640 个,DOCX 文档 4 个,可能包含 157 个官方文档(486,132 个 token)。数据以 rows.parquet 文件存储,包含以下字段:source_site(来源网站名称)、source_homepage(首页)、source_url(最终 URL)、requested_url(初始请求 URL)、title(文档标题)、text(提取的文本)、content_type(文件类型)、retrieved_at(下载时间)、text_sha256(文本哈希)、text_characters(字符数)、rights_status(自动权利标签)、rights_basis(依据)、extraction_source_url(额外来源链接)、source_page_url(源页面链接)。爬取于 2026-08-15 至 2026-08-16,使用公共 sitemap 和链接,并遵守 robots.txt。文本提取自网页、文本 PDF、Word 文件和 CSV 文件,但未对扫描 PDF 和图像进行 OCR。短页面和重复文本被排除。权利方面,部分法律、决定、通知等公共文档可能不受法罗版权法第 9 条保护,但 'likely_official_document' 标签仅基于标题或 URL 关键词匹配,并非法律分类。已知限制:爬取可能未覆盖所有页面或旧文档;文本未经人工审核或语言过滤;菜单、页眉等重复网站文本可能保留;PDF 文本可能顺序错误;扫描 PDF 和图像文本缺失;可能包含个人信息。该数据集适用于法罗语自然语言处理、文档分类、公共档案研究、多模态文档分析等任务。
The Eysturkommuna dataset (eysturkommuna_fo) is an archival dataset collected from the municipal website of Eysturkommuna in the Faroe Islands. It contains HTML pages, council materials, PDFs, DOCX files, news, plans, and service content, aiming to provide a corpus of Faroese public documents.
数据集概述:Eysturkommuna(eysturkommuna_fo)
状态: 独立网站采集数据集,不属于 Faroese Dynaword 项目。
数据内容
该数据集包含一个大型市政档案,涵盖 HTML 页面、议会材料、PDF、DOCX 文件、新闻、规划及服务内容。数据来源为 Eysturkommuna 官方网站。
数据规模
| 指标 | 数值 |
|---|---|
| 文档总数 | 6,565 |
| 字符总数 | 22,104,698 |
| Token 总数 | 10,719,723 |
| 可能官方文档数 | 157 |
| 可能官方文档 Token 数 | 486,132 |
| 文件类型 | 文档数 |
|---|---|
| HTML | 5,921 |
| 640 | |
| DOCX | 4 |
| CSV | 0 |
| 纯文本 | 0 |
Token 计数使用 AI-Sweden-Models/Llama-3-8B-instruct 分词器,统计所有采集文本(包含其他语言及重复网站文本)。
文件结构
rows.parquet:包含采集到的文档。parser/:包含爬虫、站点设置及 Python 依赖。
爬取详情
- 爬取开始时间:2026-08-15
- 爬取完成时间:2026-08-16
- 爬虫使用公开 sitemap 和网站内链接,严格限制在
parser/sites.csv中列出的站点及文件主机,并遵守robots.txt。 - 文本提取自网页、文本型 PDF、Word 文件和 CSV 文件;扫描版 PDF 和图片未进行 OCR 识别。
- 过短页面及完全重复的文本已被去除。
数据列说明
| 列名 | 含义 |
|---|---|
source_site, source_homepage |
网站名称和主页 |
source_url, requested_url |
最终 URL 和最初请求的 URL |
title, text, content_type |
文档标题、提取文本和文件类型 |
retrieved_at |
文档下载时间 |
text_sha256, text_characters |
文本哈希和字符计数 |
rights_status, rights_basis |
自动版权标签及其分配依据 |
extraction_source_url, source_page_url |
可用的额外来源链接 |
版权说明
部分法律、决定、通知等公共文档可能依据法罗群岛版权法第 9 条不受版权保护。likely_official_document 标记仅表示标题或 URL 匹配特定词汇列表,并非法律分类。
针对本站的特别说明: 议会记录和市政规章是最明确的候选对象;新闻、报告、公众提交材料及外部附件仍可能受版权保护。文件类型错误的文件已被排除。
已知限制
- 爬取可能未覆盖所有页面或旧文档。
- 文本未经人工核查,也未按语言过滤。
- 菜单、页眉等重复网站文本可能残留。
- PDF 文本可能出现顺序错乱。
- 扫描版 PDF 和图片中的文字缺失。
- 部分页面可能包含个人敏感信息。
使用方式
数据集包含爬虫代码,可通过以下命令运行(需在 parser 目录下):
bash cd parser python -m pip install -r requirements.txt python scrape.py --site eysturkommuna_fo