遇见数据集

joey234/mmlu-high_school_world_history-rule-neg

收藏
Hugging Face2023-04-28 更新2024-03-04 收录
官方服务:

资源简介:

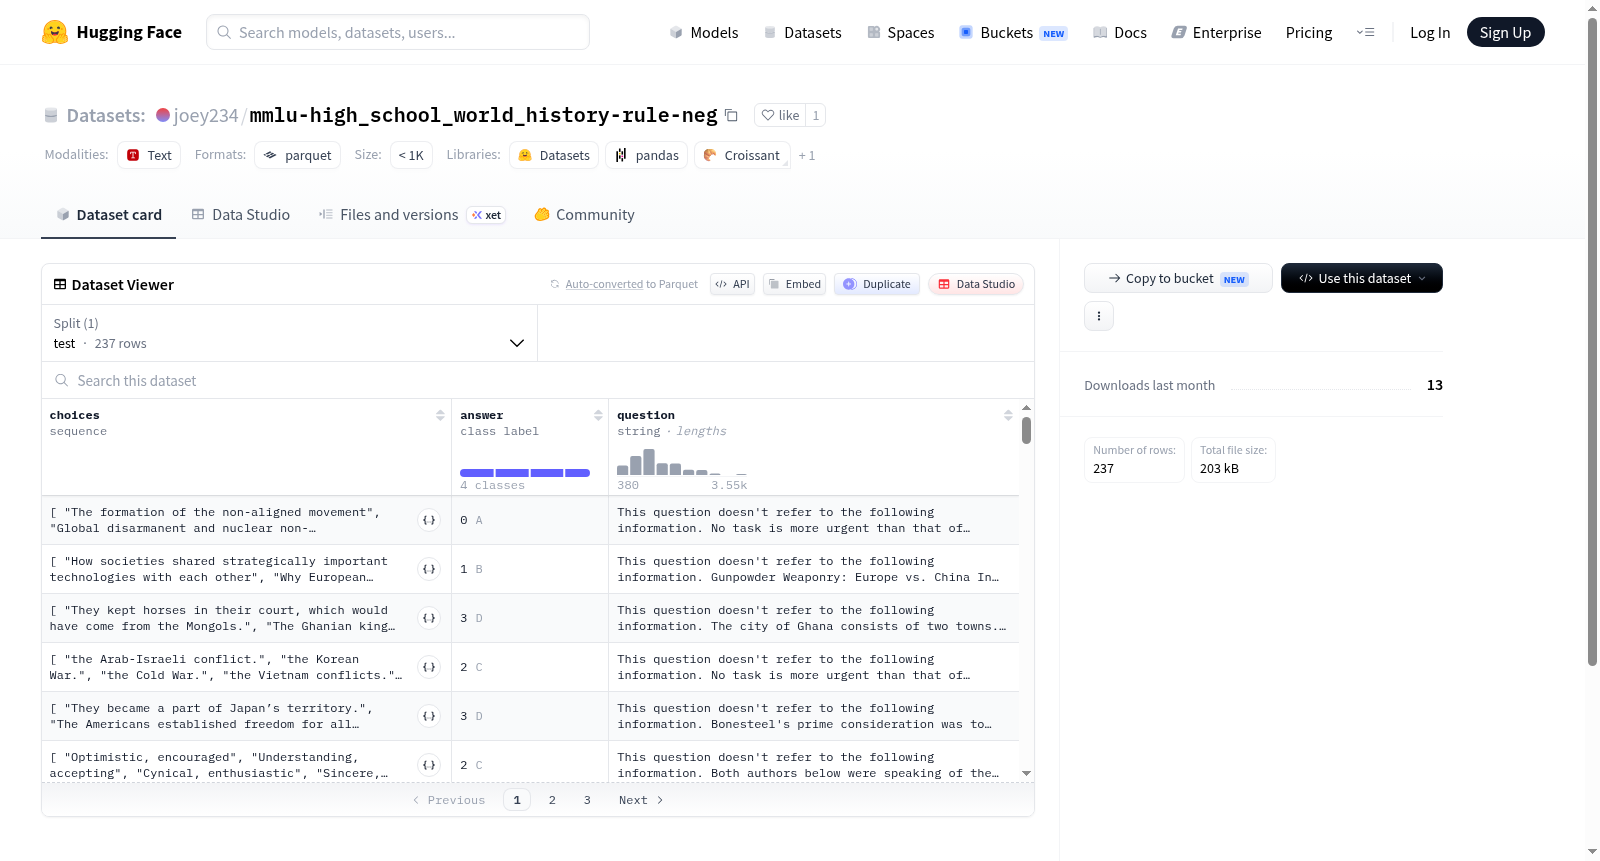
--- dataset_info: features: - name: choices sequence: string - name: answer dtype: class_label: names: '0': A '1': B '2': C '3': D - name: question dtype: string splits: - name: test num_bytes: 380246 num_examples: 237 download_size: 200389 dataset_size: 380246 --- # Dataset Card for "mmlu-high_school_world_history-rule-neg" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

### 数据集信息 特征项: - 名称:选项(choices),类型:字符串序列 - 名称:答案(answer),数据类型(dtype)为类别标签(class_label),类别映射关系为:'0'对应A,'1'对应B,'2'对应C,'3'对应D - 名称:问题(question),数据类型(dtype):字符串 数据划分: - 划分名称:测试集(test),字节数:380246,样本量:237 下载大小:200389 字节 数据集总大小:380246 字节 --- # 「mmlu-high_school_world_history-rule-neg」数据集卡片(Dataset Card) [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards) ## 你的回答是:

提供机构:
joey234
原始信息汇总

数据集概述

数据集特征

  • choices:字符串序列。
  • answer:分类标签,具体为:
    • 0: A
    • 1: B
    • 2: C
    • 3: D
  • question:字符串类型。

数据集划分

  • test:
    • 数据大小:380246字节
    • 示例数量:237

数据集大小

  • 下载大小:200389字节
  • 数据集总大小:380246字节
搜集汇总
数据集介绍
joey234/mmlu-high_school_world_history-rule-neg 数据集图片
构建方式
该数据集是基于MMLU(Massive Multitask Language Understanding)基准中高中世界历史子集构建的衍生版本,通过应用特定的规则否定(rule-neg)策略生成。原始MMLU数据集包含多项选择题,每个问题有四个选项(A、B、C、D)及一个正确答案。构建过程中,研究者可能通过反转或扰动原始问题的逻辑关系,生成否定形式的问题,旨在评估模型在对抗性样本或逻辑反转条件下的推理能力。数据集仅包含测试集,共237个样本,每个样本包含问题(question)、选项列表(choices)及标签化的答案(answer),其中答案以分类标签形式编码为0至3,对应A至D。
使用方法
该数据集可直接通过HuggingFace Datasets库加载,使用`load_dataset('joey234/mmlu-high_school_world_history-rule-neg')`命令获取。加载后,用户可访问包含'question'、'choices'和'answer'字段的测试集,其中'choices'为字符串列表,'answer'为整数标签(0-3)。典型使用场景包括零样本或少样本评估,研究者可将问题与选项输入语言模型,比较模型输出与标签的一致性,以衡量模型在否定语境下的历史知识推理能力。建议结合原始MMLU标准版本进行对比分析,以揭示规则否定带来的性能差异。
背景与挑战
背景概述
大规模多任务语言理解(MMLU)基准测试自2020年由加州大学伯克利分校等机构的研究人员提出以来,已成为评估语言模型知识与推理能力的重要标杆。该数据集覆盖了从人文科学到自然科学的57个学科领域,其中高中世界历史子集专注于考察模型对历史事件、文化演进及全球脉络的掌握程度。joey234/mmlu-high_school_world_history-rule-neg作为该子集的一个变体,通过引入规则性负样本构建策略,旨在挑战模型在特定历史语境下的抗干扰能力与判别性理解水平,为研究语言模型在细粒度知识记忆与逻辑推理间的平衡提供了独特的测试平台。
当前挑战
该数据集面临的首要挑战在于领域问题层面:高中世界历史知识跨度极广,涉及不同文明的时间线、因果关系及术语辨析,模型需在缺乏常识推理支撑的情况下精准识别细微差异,避免被规则性负样本中的表面相似性误导。构建过程中的挑战则包括如何设计有效的负样本生成规则,确保其既能模拟真实错误模式,又不引入人工痕迹导致评估偏差;同时需平衡样本数量与领域覆盖度,避免因过度聚焦特定规则而削弱测试的泛化意义。
常用场景
经典使用场景
该数据集聚焦于高中世界历史领域,通过引入规则负采样策略,构建了针对多项选择题的评估基准。在自然语言处理与教育测评的交汇处,该数据集常用于检验大语言模型在历史知识推理与反事实理解方面的能力。研究者可通过考察模型在干扰项增强后的题目上的表现,探究其对历史事件时序、因果关系及文化背景的深层把握,从而推动知识密集型问答系统的鲁棒性提升。
解决学术问题
该数据集有效解决了传统多选题评估中干扰项设计单一、难以反映模型真实推理缺陷的问题。通过规则化的负样本生成,学术研究得以系统性地分析模型在历史知识迁移、逻辑矛盾识别以及错误信息干扰下的脆弱性。其意义在于为模型的知识边界探测提供了可控的挑战环境,促进了对抗性评估方法在学科知识检验中的规范化应用,进而助力构建更可信的智能教育评估体系。
实际应用
在实际教育科技场景中,该数据集可被用于开发自适应历史学习辅助系统。通过分析模型在负采样题目上的错误模式,能够智能识别学生对历史概念的混淆点或理解盲区,从而生成针对性的纠错练习与个性化学习路径。此外,该数据集还可服务于智能题库的难度校准与干扰项质量优化,提升在线评估工具的测评精度与反馈有效性。
数据集最近研究
最新研究方向
当前,大规模多任务语言理解基准(MMLU)的子集——高中世界历史领域,正成为评估语言模型在长尾知识与推理能力上表现的关键试金石。该数据集通过引入规则性负样本(rule-neg)设计,聚焦于模型对历史事件因果链条、时空错位及逻辑悖论的判别能力,这一方向紧密关联学界对模型事实性幻觉与对抗鲁棒性的前沿探讨。在热点事件方面,随着GPT-4、Claude等模型在历史问答中暴露出的时代错误与地域混淆问题,该数据集被广泛用于检验模型是否真正理解历史发展的内在逻辑,而非依赖表面模式匹配。其意义在于推动了从单纯知识记忆到因果推理评估的范式转变,为构建更可靠的教育辅助系统与知识密集型AI提供了关键验证工具。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务