
遇见数据集

BGLab/BioTrove-Train

收藏
Hugging Face2025-05-13 更新2024-12-14 收录
官方服务:

资源简介:

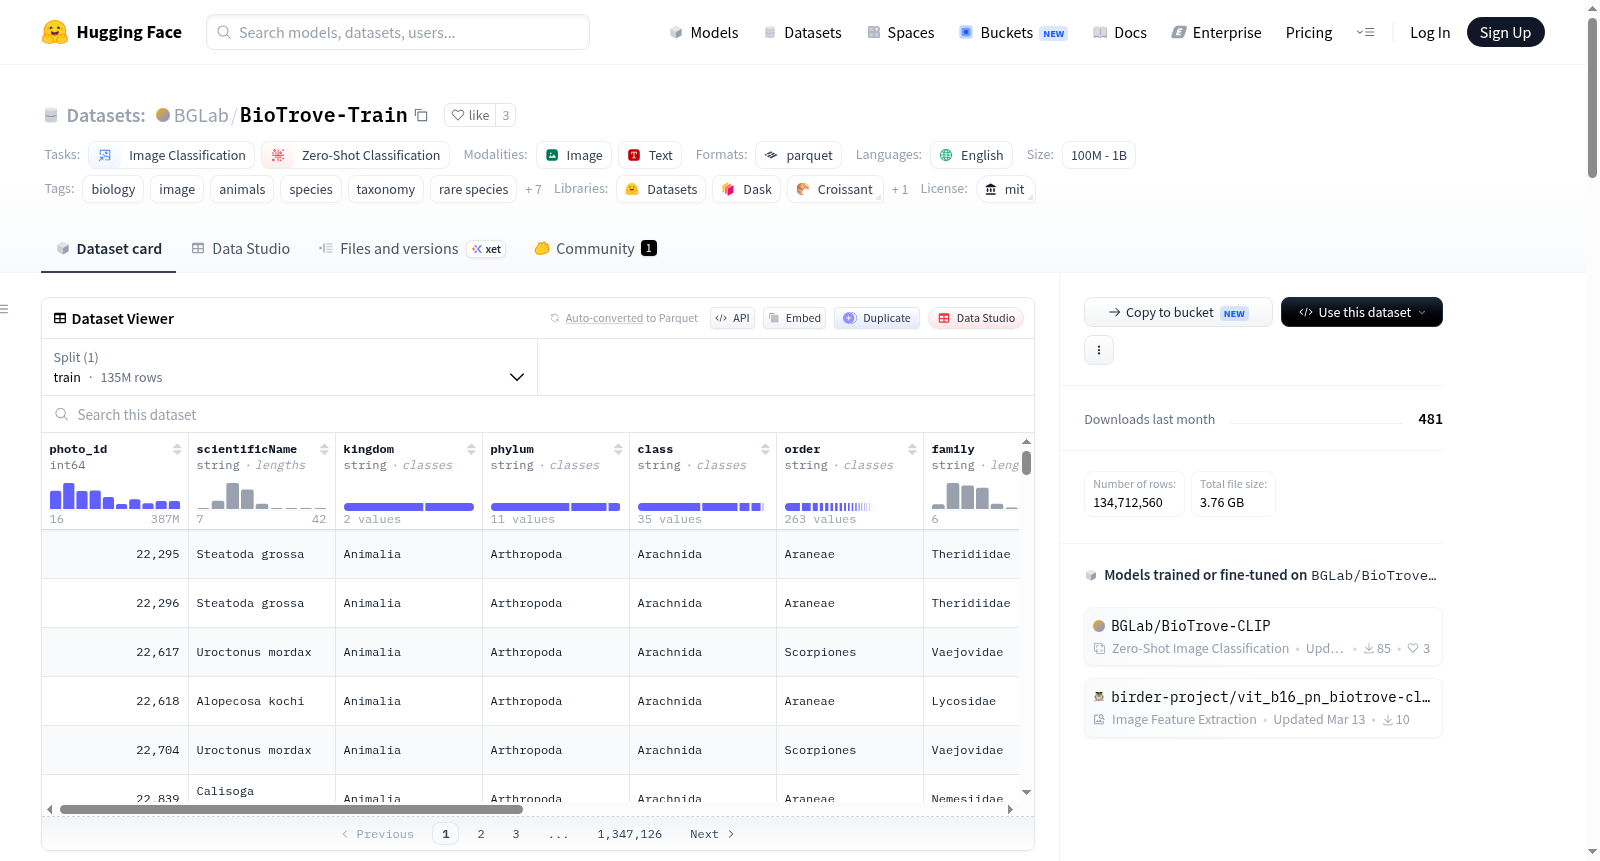
BioTrove是一个大型图像数据集,旨在通过人工智能技术促进生物多样性研究。该数据集包含大量经过处理的图像和元数据,支持图像分类和零样本分类任务。数据集分为多个子集,如BioTrove-Train(包含40M图像样本和33K物种)、BioTrove-Balanced(平衡物种分布)、BioTrove-Unseen(评估模型对未见物种的泛化能力)和BioTrove-LifeStages(评估模型对昆虫不同发育阶段的识别能力)。此外,数据集还提供了详细的元数据信息和软件工具,方便用户下载、访问和操作数据。

BioTrove is a large curated image dataset designed to enable AI for biodiversity research. The dataset includes detailed metadata and image URLs, covering multiple taxonomic groups such as Aves, Arachnida, Insecta, Plantae, Fungi, Mollusca, and Reptilia. Additionally, several sub-datasets are provided, such as BioTrove-Balanced, BioTrove-Unseen, and BioTrove-LifeStages, for various research purposes, including balanced species distribution, evaluating model generalization capability on unseen species, and recognizing species across different developmental stages. The dataset also offers related software tools and models, such as the BioTrove-CLIP model, for image classification and zero-shot classification tasks.
提供机构:
BGLab
搜集汇总
数据集介绍
BGLab/BioTrove-Train 数据集图片
构建方式
在生物多样性领域,大规模、高质量图像数据集的匮乏长期制约着人工智能在物种识别与生态保护中的深度应用。BioTrove-Train 数据集应运而生,其构建过程严谨而系统,整合了来自 iNaturalist 等平台的图像资源,经过精细的元数据清洗与分类学信息标注,最终汇聚成涵盖逾4000万图像样本、横跨7个关键生物类群(包括鸟类、蛛形纲、昆虫、植物、真菌、软体动物和爬行动物)的庞大数据集。该数据集不仅提供了完整的分类层级信息与图像链接,还通过分块存储的元数据文件(如 Parquet 格式)实现了高效的检索与过滤,为生态学与计算机视觉交叉研究奠定了坚实的数据基础。
特点
BioTrove-Train 数据集的核心特点在于其规模与多样性的卓越平衡。相较于当前最先进的 TREEOFLIFE-10M 数据集,其在物种多样性上几乎持平,而数据规模则实现了近四倍的超越,共收录超过3.3万个物种。该数据集特别聚焦于对生物多样性与农业生态系统具有重大影响、但在传统图像识别模型中相对被忽视的类群,从而有效弥补了现有数据集的偏差。此外,研究者还基于该数据集构建了三个新型基准测试子集:BioTrove-Balanced 确保类别均衡,BioTrove-Unseen 评估模型对未见物种的泛化能力,BioTrove-LifeStages 则专注于昆虫不同生命阶段的识别,展现了数据集在细粒度分类与跨阶段识别中的独特价值。
使用方法
使用 BioTrove-Train 数据集时,研究者可首先从 HuggingFace 仓库下载分块的元数据文件(如 CSV 或 Parquet 格式),随后利用官方提供的 biotrove_process 软件工具库进行数据预处理与图像下载。该工具库支持灵活的过滤与可视化操作,允许用户根据分类群组、物种丰度等条件自定义子集,从而有效管理数据不平衡问题。对于模型训练,数据集可直接与标准深度学习框架(如 PyTorch)结合,并已预训练了基于 CLIP 架构的 BioTrove-CLIP 模型系列(包括初始化自 OpenCLIP、BioCLIP 和 MetaCLIP 的版本),为下游任务提供了强大的基线。详细的数据准备步骤与代码示例均可在项目的 GitHub 仓库中找到,确保用户能够快速上手并复现研究成果。
背景与挑战
背景概述
在生物多样性保护与生态监测领域,基于视觉的物种识别技术正逐渐成为研究热点,然而现有图像数据集在物种覆盖广度、类别平衡性以及细粒度分类能力上存在显著局限。BGLab团队于2024年推出的BioTrove数据集,由纽约大学、爱荷华州立大学等机构的研究人员共同构建,旨在为人工智能赋能生物多样性研究提供大规模、高质量的训练资源。该数据集包含超过1.61亿张图像,覆盖七大关键分类群(鸟类、蛛形纲、昆虫、植物、真菌、软体动物和爬行动物),其规模较同期最先进的TREEOFLIFE-10M数据集提升近四倍,并配套发布了面向平衡分布、未知物种及不同生命阶段的基准测试集。这一开创性工作发表于NeurIPS 2024数据集与基准轨道,为细粒度图像分类、零样本学习及多模态模型在生态学领域的应用奠定了重要基础。
当前挑战
BioTrove数据集所面临的挑战首先体现在领域问题层面:物种识别需应对类间高度相似性与类内形态多样性,例如昆虫在不同生命阶段(卵、幼虫、蛹、成虫)呈现显著视觉差异,而传统模型对此泛化能力不足。为此,数据集专门构建了LifeStages基准以评估跨发育阶段识别性能。在构建过程中,团队遭遇了数据不平衡与稀有物种覆盖的难题——iNaturalist等众包平台中常见物种图像数量远超濒危或罕见物种,导致模型偏向高频类别。为解决此问题,研究团队设计了平衡子集(每类最多500物种、每物种50张图像)及Unseen基准(含少于30张实例的物种),以检验模型在数据稀缺场景下的鲁棒性。此外,元数据的标准化处理、跨来源图像质量的控制以及高效下载工具的研发,也是确保数据集可用性的关键挑战。
常用场景
经典使用场景
在生物多样性智能计算领域,BioTrove-Train数据集以其宏大的规模和精细的物种分类体系,成为细粒度图像分类任务中的标杆性资源。该数据集囊括逾四千万张图像样本,覆盖鸟类、昆虫、植物等七个关键生物类群中的三万三千余个物种,为训练高精度视觉模型提供了近乎无偏的物种分布。研究者常利用其内置的BioTrove-Balanced基准,在平衡类别条件下评估模型对物种层级结构的辨识能力,亦可通过BioTrove-Unseen子集检验模型对未见物种的零样本泛化性能。这些特性使其成为推动生态影像智能解析算法发展的核心平台。
实际应用
在实际生态保护与农业精准管理中,BioTrove-Train驱动的视觉模型已展现出广泛的应用潜力。基于该数据集训练的BioTrove-CLIP系列模型,能够自动识别入侵物种、监测传粉昆虫种群动态,并在作物病虫害早期预警系统中实现跨物种的零样本迁移。其配套的元数据过滤工具与开源软件库,更使生态学家无需深厚计算背景即可完成数据清洗、类别筛选与分布可视化,大幅降低了AI技术在野外观测站、自然保护区等场景的部署门槛,加速了从影像到生态决策的闭环。
衍生相关工作
围绕BioTrove-Train衍生出的经典工作深刻重塑了生物多模态学习的范式。研究者基于其元数据体系提出了知识引导的对比学习框架,将分类学层级树嵌入CLIP训练过程,显著提升了物种细粒度表征的判别力。此外,该数据集催生了面向生命阶段不变性表征的时序对比学习模型,以及针对开放世界物种识别的自适应负采样策略。这些工作不仅被NeurIPS等顶级会议收录,更带动了TREEOFLIFE-10M等同类数据集的标准化建设,形成了以分类学先验驱动视觉智能的学术脉络。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

