WildClawBench-Trajectories
收藏资源简介:
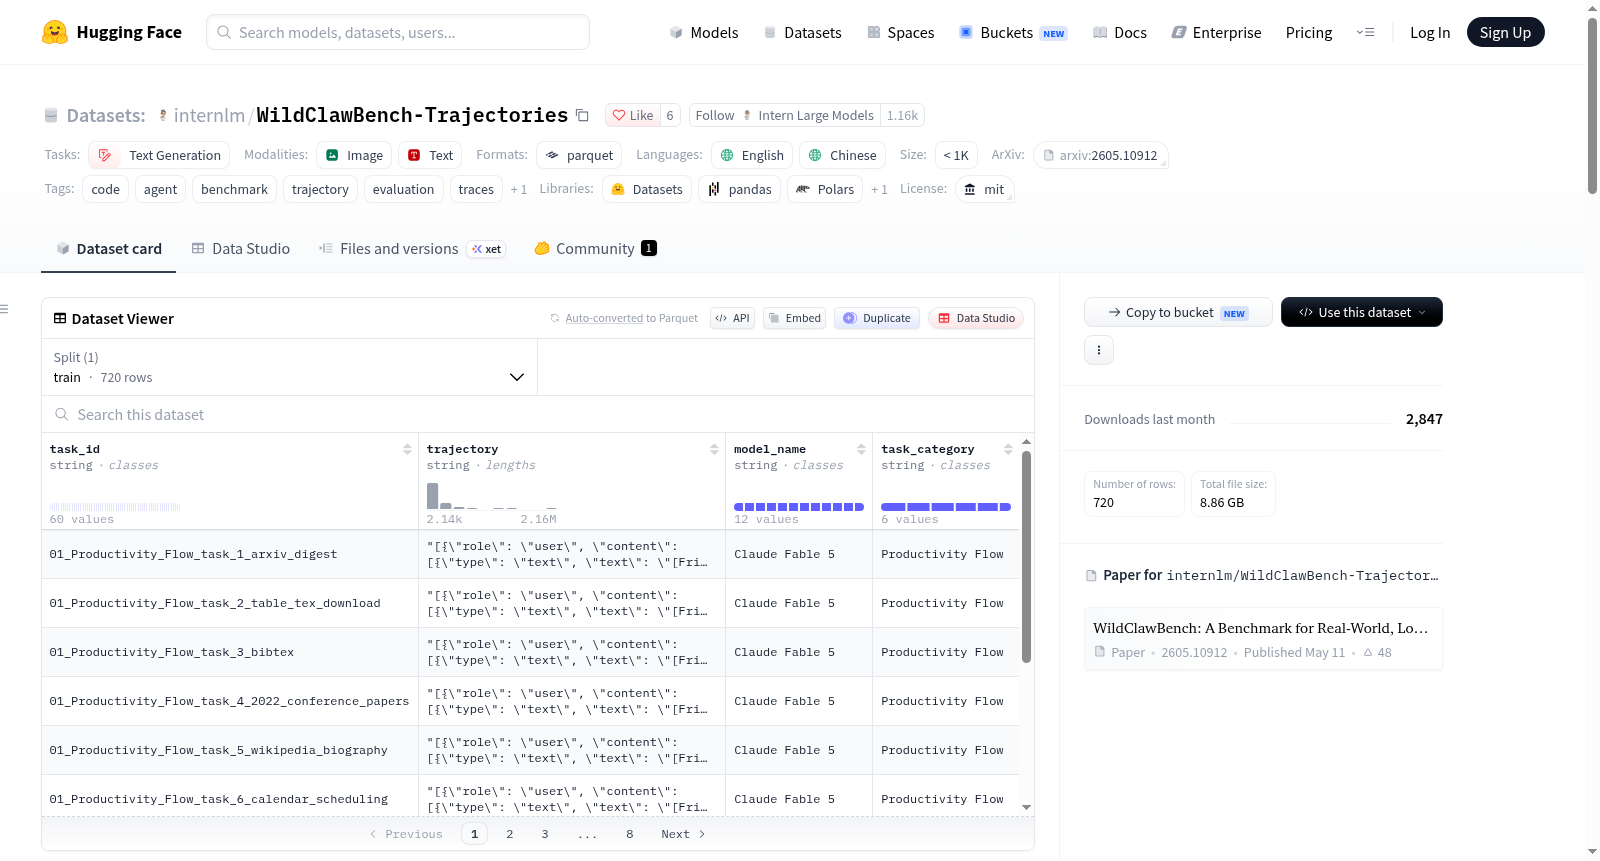
WildClawBench Trajectories 数据集包含从 WildClawBench 评估中收集的完整 OpenClaw agent 轨迹。该数据集旨在支持 agent 轨迹的基准测试与评估,共包含 600 条轨迹,覆盖 60 个基准任务和 10 个模型。数据以 train.parquet 文件形式提供,包含以下字段:task_id(任务标识符)、trajectory(完整消息序列的 JSON 数组)、model_name(评估模型名称)和 task_category(任务类别,属于 WildClawBench 的六种类别之一)。为保持数据集查看器稳定加载,轨迹中的内联 base64 图像被替换为包含原始载荷长度和 SHA-256 摘要的占位符,但消息顺序、图像位置、MIME 类型、文本、推理、工具调用和工具结果均被保留。原始图像和任务工件可在对应的源档案中获取。此外,sessions/ 目录下提供了每个模型和任务的 Pi session v3 JSONL 文件,可用于 Hugging Face Agent Trace Viewer 查看完整会话时间线、推理块、模型响应、令牌使用、工具调用和结果。每个会话头部包含 trace_status 字段,标识状态为 completed(567 条)、error(7 条)或 interrupted(26 条)。error 和 interrupted 会话在 Trace Viewer 中会显示最终警告块。数据集许可证为 Apache-2.0,支持英语和中文,适用于文本生成任务,标签包括代码、agent、基准、评估等。
The WildClawBench Trajectories dataset contains complete OpenClaw agent trajectories collected from the WildClawBench evaluation. This dataset aims to support benchmarking and evaluation of agent trajectories, comprising 600 trajectories across 60 benchmark tasks and 10 models. The data is provided as a train.parquet file with the following fields: task_id (task identifier), trajectory (JSON array of complete message sequences), model_name (evaluated model name), and task_category (one of the six categories in WildClawBench). To ensure stable loading of the dataset viewer, inline base64 images in trajectories are replaced with placeholders containing the original payload length and SHA-256 hash, while preserving message order, image positions, MIME types, text, reasoning, tool calls, and tool results. Original images and task artifacts can be obtained from the corresponding source archives. Additionally, the sessions/ directory provides Pi session v3 JSONL files for each model and task, which can be used with the Hugging Face Agent Trace Viewer to view the complete session timeline, reasoning blocks, model responses, token usage, tool calls, and results. Each session header includes a trace_status field indicating whether the status is completed (567), error (7), or interrupted (26). Error and interrupted sessions will display a final warning block in the Trace Viewer. The dataset is licensed under Apache-2.0, supports English and Chinese, is suitable for text generation tasks, and is tagged with code, agent, benchmark, evaluation, etc.
WildClawBench Trajectories 数据集概述
基本信息
- 许可证:Apache-2.0
- 任务类型:文本生成
- 语言:英语、中文
- 标签:代码、智能体、基准测试、轨迹、评估、追踪、OpenClaw
- 数据规模:少于1K条(n<1K)
数据集内容
该数据集包含从WildClawBench评估中收集的完整OpenClaw智能体轨迹。当前版本包含600条轨迹,涵盖60个基准任务和10个评估模型。
数据集中包含完整的消息序列、模型名称和任务类别等信息。
数据结构
数据文件为train.parquet,主要字段包括:
| 字段 | 说明 |
|---|---|
task_id |
WildClawBench任务标识符 |
trajectory |
完整消息序列,以JSON数组形式序列化 |
model_name |
评估模型的显示名称 |
task_category |
WildClawBench六大任务类别之一 |
为保证Dataset Viewer行数据量可控,内联的base64图像载荷被替换为包含原始载荷长度和SHA-256摘要的占位符。消息顺序、图像位置、MIME类型、文本、推理、工具调用和工具结果均被保留。原始图像载荷和所有任务工件可在对应的源归档中获取。
会话追踪文件
sessions/目录包含每个模型和任务的Pi会话v3格式JSONL文件,路径结构为:
sessions/<模型名称>/<任务ID>.jsonl
这些追踪文件保留了原始的内联图像数据,可用于查看完整时间线、推理块、模型响应、令牌使用、工具调用、工具参数和工具结果。
追踪状态说明
每个会话头部包含trace_status字段,状态分为三类:
completed:执行干净结束error:模型返回明确错误interrupted:一个或多个工具调用没有记录结果
当前版本包含:567个已完成、7个错误、26个中断的追踪。
使用示例
python from datasets import load_dataset
dataset = load_dataset("internlm/WildClawBench-Trajectories") sample = dataset["train"][0]