
遇见数据集

adsgpt/marketing-benchmark-of-more-than-10-ai-models

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

这是一个包含5000个问题的基准数据集,用于评估大型语言模型在现代营销的六个维度上的表现:Meta广告、Google广告、SEO与有机营销、电子邮件与生命周期营销、批判性思维以及基于场景的行动问题。每个问题都通过10个不同的营销人员角色视角进行评分,问题由AdsGPT营销基准团队独立编写,知识性多选题基于2026年平台文档手工编写,开放性和行动性问题则基于手工编写的模板和评分标准,通过参数化扩展覆盖不同角色、行业、预算和地理区域。

A 5,000-question benchmark for evaluating LLMs across six dimensions of modern marketing — Meta Ads, Google Ads, SEO & Organic, Email & Lifecycle, Critical Thinking, and Action-Based scenarios — graded through 10 distinct marketer personas. Every question is independently authored by the AdsGPT Marketing Bench team. Knowledge MCQs are hand-authored against 2026 platform documentation; open-ended and action-based scenarios are built from hand-authored templates and rubrics, then parametrically expanded across personas, industries, budgets, and geographies.

提供机构:
adsgpt
搜集汇总
数据集介绍
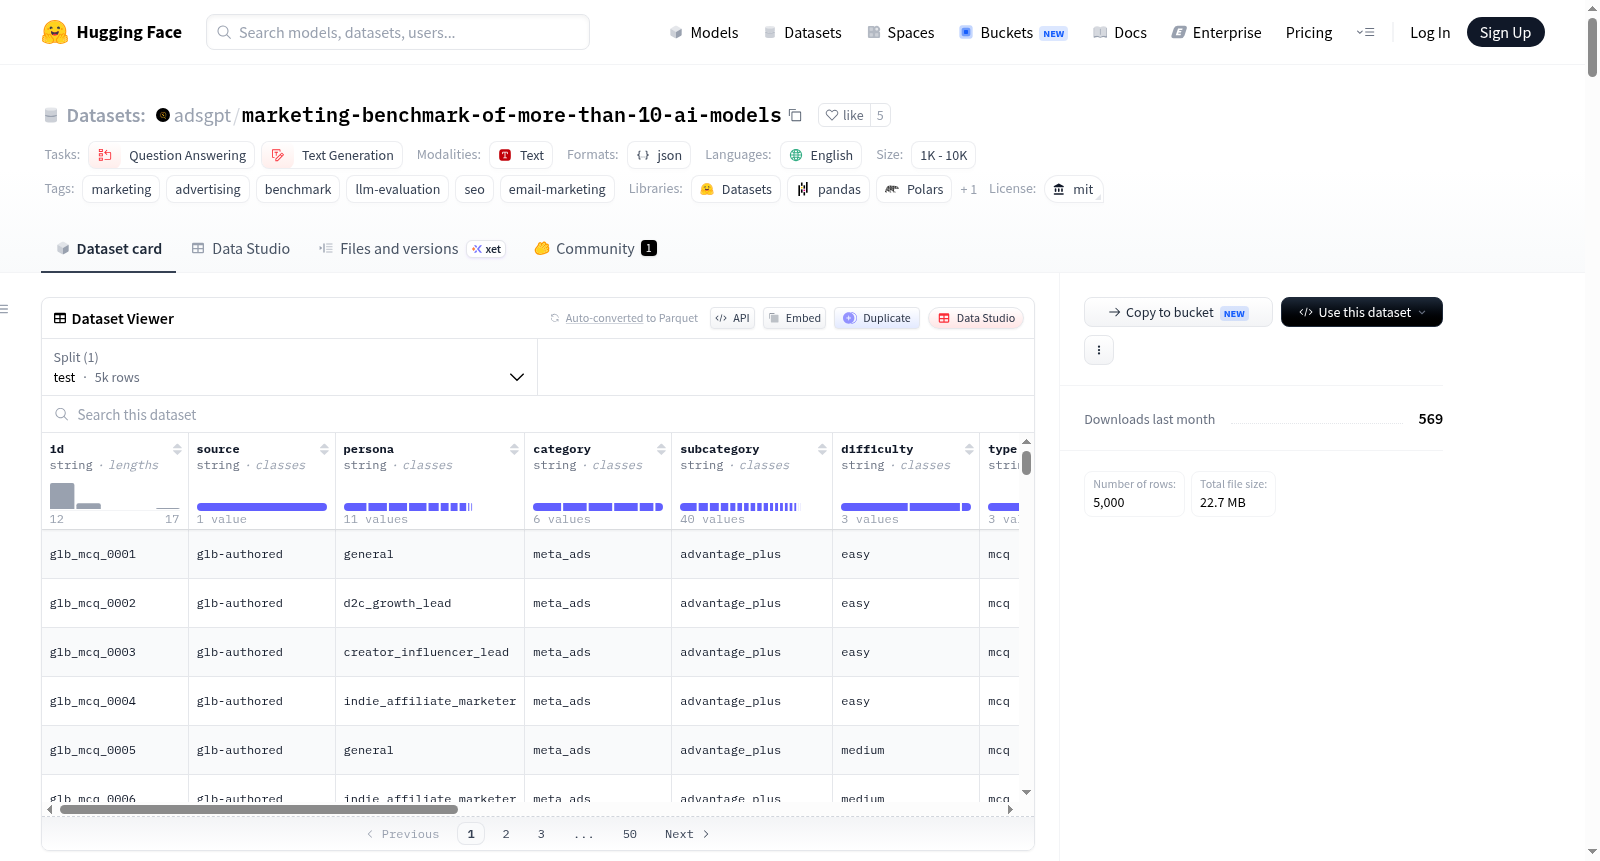
adsgpt/marketing-benchmark-of-more-than-10-ai-models 数据集图片
构建方式
在数字营销日新月异的时代背景下,精准评估大语言模型(LLM)在营销领域的专业能力显得尤为重要。该数据集由AdsGPT营销基准团队独立构建,共包含5000道涵盖现代营销六大维度的评测问题,分别涉及Meta广告、Google广告、SEO与自然流量、电子邮件与生命周期、批判性思维以及基于行动的场景。每道知识类多选题均依据2026年平台官方文档手工编撰,而开放式与行动型场景问题则基于手工撰写的模板与评分准则,通过参数化扩展方式,覆盖了10种不同营销从业者角色、多种行业、预算规模及地域特征,从而确保了评测的广度与深度。
特点
该数据集最显著的特点在于其多维度的评测架构与精细化的角色视角。它不仅覆盖了Meta广告、Google广告等六大营销核心领域,还通过10种不同的营销人员角色透镜对每个答案进行独立评分,包括DTC增长负责人、B2B SaaS需求生成经理、绩效代理策略师等,从而能够揭示不同模型在面向不同营销角色时的表现差异。数据集中的问题类型丰富多样,包含选择题(MCQ)、开放式问题(Open-ended)和基于行动的问题(Action-based),分别采用精确匹配和LLM作为评分员依据评分准则进行0到1区间的打分。总体评分采用六类别的宏平均加权法,确保了每个营销类别在最终得分中的平等权重。
使用方法
该数据集的使用流程设计得简洁而高效。用户首先需通过`pip install -r requirements.txt`安装依赖,并可通过`python scripts/build_dataset.py`以确定性方式(随机种子为42)重新生成数据集。评估时,可采用`evaluate.py`脚本对单个模型进行测试,支持通过`--category`和`--persona`参数筛选特定类别或角色视角。对于批量模型评测,数据集提供了串行运行的`run.py`与并行运行的`run_resume_parallel.py`脚本,后者支持断点续跑,自动跳过已在`results/`目录下生成成功结果文件的模型。评估结果以JSON格式输出,包含按类别、难度、问题类型及角色视角的详细分析,并可通过`scripts/make_charts.py`脚本自动生成可视化图表,便于直观对比分析。
背景与挑战
背景概述
该数据集由AdsGPT Marketing Bench团队于2024年创建,旨在填补大语言模型在垂直营销领域评估的空白。随着生成式AI在广告投放、搜索引擎优化、邮件营销等场景中的广泛渗透,现有通用型基准如MMLU或HellaSwag难以衡量模型在真实营销决策中的表现。该数据集围绕六大核心维度——Meta广告、Google广告、SEO、邮件生命周期、批判性思维与行动推理——构建了5000道手写题目,并引入10种具有差异化的营销角色视角进行评估。通过参数化扩充与手工标注的题目种子,数据集覆盖了不同行业、预算与地域背景,为评估模型在策略规划、归因分析与平台实操中的综合能力提供了标准化工具。其发布迅速引发了学术界与产业界的关注,尤其在LLM-as-Judge评估范式的应用上具有示范意义。
当前挑战
该数据集旨在解决两大核心挑战。领域方面,现有多数基准集中于通用知识问答或代码生成,缺乏对营销决策中跨平台策略、归因模型理解与动态竞价逻辑等专业能力的系统性评估。营销场景往往要求模型同时具备知识记忆、逻辑推理与行动生成能力,其复杂性远超单一任务。构建方面,团队面临数据时效性与角色差异化的平衡难题:题目需基于2026年平台文档,确保内容前沿,同时通过参数化扩展生成覆盖10种角色、多变量条件的变体,避免简单模板化。此外,推理模型在生成行动型题目时因思考令牌限制导致输出截断的问题,成为评估流程中的关键瓶颈,需动态调整令牌预算以保证评分公平性。
常用场景
经典使用场景
在数字营销领域,该数据集被广泛用于评估大语言模型在广告投放、搜索引擎优化、邮件营销、批判性思维及行动导向任务等六维营销场景中的综合表现。研究者通过向模型投喂覆盖Meta与Google广告策略、SEO与生命周期管理、以及创作者经济等真实营销情境的5000道手写题目,借助十种典型营销人设(如独立站增长主管、B2B SaaS需求生成经理、本地小企业主)进行角色化评估,精准衡量模型在多渠道、多预算及多地域条件下的专业推理与决策能力。这一框架为营销科技公司、广告代理商及电商平台提供了标准化、可重复的模型选型与优化方案,尤其适用于需要兼顾广告文案创作、受众定向分析及ROI测算等复合型营销任务的应用场景。
实际应用
在实际产业应用中,该数据集为广告技术企业、电商平台与营销分析机构提供了关键的模型选型指南。平台运营方可根据数据集产出的多维排行榜,按业务需求精准匹配最适配的模型——例如在需要高精度广告投放建议时优先选择Google Ads与Meta Ads板块得分优异的模型,而在处理开放型营销咨询任务时则侧重行动推理分数突出的模型。同时,数据集内置的十种营销人设评估机制使得中小企业主、自由职业营销者及大型CMO皆可获得定制化的模型能力画像,从而指导自动化广告文案生成、邮件营销流优化、SEO策略制定及预算分配等实际工作流中的AI部署决策,显著降低试错成本。
衍生相关工作
该数据集催生了一系列富有影响力的衍生研究工作,包括针对推理模型思考令牌截断问题的专项修正研究,研究者通过调整评估脚本中的输出预算策略,揭示了令牌长度限制对模型分数产生的巨大影响(部分模型分数波动幅度达17至91个百分点),推动了评估方法论的重要改进。此外,围绕数据集涌现的模型能力分化现象,学界衍生出细粒度营销专业知识蒸馏研究,旨在将大型模型在特定营销亚领域的优势能力迁移至轻量化模型;同时,基于十种人设评估结果,业界发展出角色感知模型微调技术,通过针对性优化使得模型在不同营销岗位下的回复风格与专业度更加契合真实工作场景,进一步拓展了营销领域人机协作的研究边界。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

