
MAPS-research/GEMRec-Roster
收藏官方服务:
资源简介:
`GEMRec-18K`是一个包含18K张图像的提示-模型交互数据集,这些图像由200个公开可用的生成模型生成,并与90个不同的文本提示配对。数据集中的模型是从Civitai上根据流行度分布随机抽样的,并添加了来自HuggingFace的3个原始Stable Diffusion检查点。所有模型检查点都已转换为Diffusers格式。文本提示来自三个来源:60个提示来自Parti Prompts,10个提示来自Civitai,另外10个提示是根据DreamStudio的提示指南手工制作的,并通过创建简化版本扩展到20个。文本提示被分类为12个类别:抽象、动物、建筑、艺术、文物、食品、插图、人物、产品与植物、风景、车辆和世界知识。
提供机构:
MAPS-research原始信息汇总
数据集概述
数据集名称
GEMRec-18K
数据集描述
GEMRec-18K 是一个包含18,000张图像的数据集,这些图像由200个公开可用的生成模型生成,并配以90个多样化的文本提示。数据集中的模型是从Civitai网站上根据流行度(下载次数)随机抽样的197个模型,以及来自HuggingFace的3个原始Stable Diffusion检查点(v1.4, v1.5, v2.1)。所有模型检查点已转换为Diffusers格式。文本提示来自三个来源:60个来自Parti Prompts,10个根据流行度从Civitai抽样,以及10个手工制作的提示,这些提示根据DreamStudio的提示指南制作,并根据Midjourney的提示扩展到20个。文本提示分为12个类别。
数据集特征
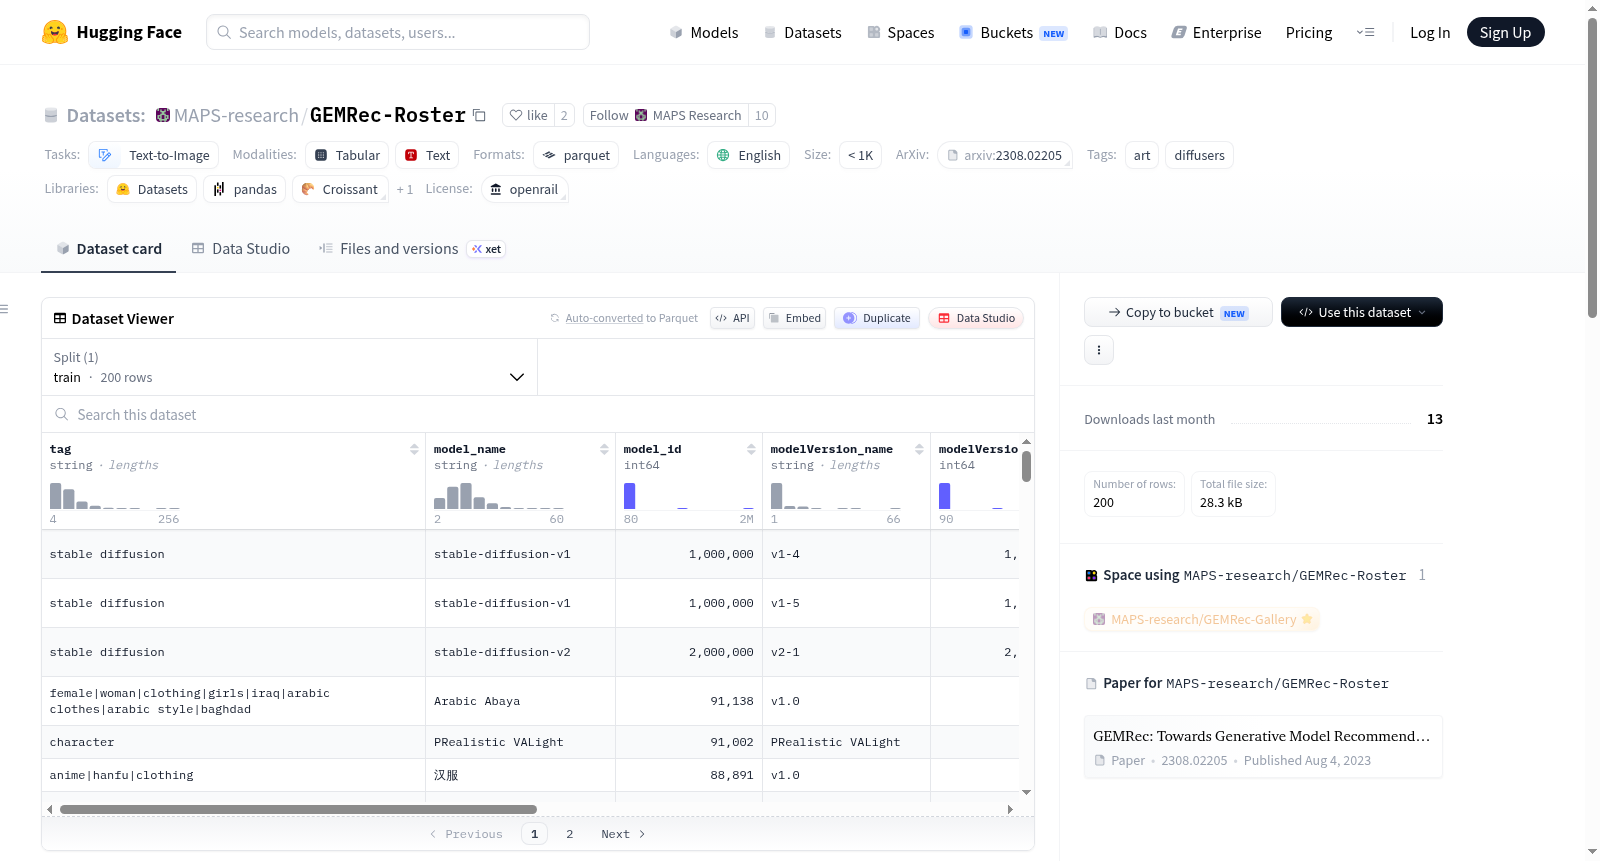
- tag: string
- model_name: string
- model_id: int64
- modelVersion_name: string
- modelVersion_id: int64
- modelVersion_url: string
- modelVersion_trainedWords: string
- model_download_count: int64
- baseModel: string
数据集分割
- train: 200个示例,36188字节
数据集大小
- 下载大小: 22662字节
- 数据集大小: 36188字节
许可证
openrail
任务类别
- text-to-image
语言
- en
标签
- art
- diffusers
大小类别
- n<1K
搜集汇总
数据集介绍
构建方式
在生成式推荐系统的研究背景下,GEMRec-Roster数据集作为GEMRec-18k项目的核心组件,专注于记录生成模型的元数据。该数据集从Civitai平台依据模型下载量的流行度分布,随机采样了197个基于Stable Diffusion微调的公开可用模型,并补充了来自HuggingFace的3个原始Stable Diffusion检查点(v1.4、v1.5、v2.1),共计200个模型。所有模型检查点均转换为Diffusers格式,以确保兼容性与标准化。数据集包含tag、model_name、model_id、modelVersion_name、modelVersion_id、modelVersion_url、modelVersion_trainedWords、model_download_count和baseModel等字段,全面刻画了每个模型的属性与版本信息。
特点
该数据集的核心特色在于其简洁而精准的元数据结构,仅用200条记录便覆盖了从流行社区模型到官方基准模型的广泛谱系。每个条目不仅记录了模型的基础标识与下载频次,还包含了训练用词与基础模型类型,为研究模型流行度与生成能力之间的关联提供了量化依据。数据集采用openrail许可,面向文本到图像任务,以英文标注,并以小型规模(n<1K)呈现,便于快速集成与实验。这种精心设计的稀疏性使其成为个性化提示-模型检索研究中的理想基准,平衡了数据丰富性与计算效率。
使用方法
使用GEMRec-Roster数据集时,研究者可将其作为模型检索系统的元数据索引。通过加载train分片中的200个样本,用户能够访问每个模型的唯一标识符(model_id与modelVersion_id)及其下载统计信息,从而构建基于流行度的排序或过滤策略。结合GEMRec-PromptBook中的图像数据与提示文本,该数据集支持端到端的生成式推荐实验:例如,利用model_name与tag字段进行模型分类,或依据model_download_count分析用户偏好。数据以Parquet格式存储,可直接通过HuggingFace Datasets库加载,并支持与Diffusers管线无缝对接,用于评估不同模型在多样化提示下的生成效果。
背景与挑战
背景概述
在生成式推荐系统领域,如何根据用户个性化提示精准匹配最合适的生成模型,已成为提升内容质量与用户体验的核心议题。由纽约大学研究团队于2023年创建的GEMRec-Roster数据集,隶属于GEMRec-18K项目,旨在为提示-模型检索任务提供标准化的模型元数据基准。该数据集收录了从Civitai平台按下载量分布采样的197个公开生成模型,并补充了HuggingFace上的三个原始Stable Diffusion检查点,所有模型均转换为Diffusers格式。其核心研究问题在于探索提示文本与生成模型之间的交互规律,为个性化生成推荐奠定数据基础。该数据集不仅推动了生成式推荐中模型检索方法的发展,还为后续研究提供了可复现的评估框架,在文生图领域具有重要的方法论价值。
当前挑战
GEMRec-Roster数据集面临多重挑战。在领域问题层面,提示-模型检索需解决生成模型性能与用户意图之间的非对称匹配问题,即同一提示在不同模型上可能产生风格迥异的输出,而现有推荐算法难以精确捕捉这种异构关系。在构建过程中,模型元数据的标准化与版本控制构成主要难点:从Civitai采集的模型需逐一验证其基础架构与训练参数,同时确保200个检查点的下载量分布能真实反映社区流行度。此外,提示文本的多源融合(Parti Prompts、Civitai、DreamStudio与Midjourney)导致类别覆盖不均衡,抽象与艺术类提示的语义歧义性增加了模型响应的评估复杂度。这些挑战共同制约着数据集在个性化生成推荐任务中的泛化能力。
常用场景
经典使用场景
在生成式推荐系统的研究领域中,GEMRec-Roster数据集作为GEMRec-18K项目的重要组成部分,为探索文本提示与生成模型之间的匹配关系提供了标准化的模型元数据资源。该数据集收录了200个公开可用的生成式模型检查点,这些模型均基于Stable Diffusion架构进行微调,并按照下载量分布从Civitai平台采样而来,同时补充了HuggingFace上的三个原始版本。通过与GEMRec-PromptBook和GEMRec-Metadata的协同使用,研究者能够系统性地分析不同模型在多样化文本提示下的生成表现,从而推动个性化生成推荐技术的纵深发展。
实际应用
在实际应用层面,GEMRec-Roster数据集支撑着面向创意工作者和普通用户的个性化生成工具开发。例如,数字艺术家在生成特定风格图像时,可通过该数据集训练的检索系统自动推荐最适配其文本描述的模型检查点,从而避免反复试错的低效流程。在电商产品展示、游戏角色设计等需要批量生成视觉内容的场景中,该数据集使得平台能够根据用户输入的抽象概念(如“未来主义建筑”或“复古插画”)动态调度最优生成模型,实现从单一模型服务向模型即服务生态的跨越。
衍生相关工作
围绕GEMRec-Roster数据集已衍生出多项具有影响力的学术工作。其核心论文《Towards Personalized Prompt-Model Retrieval for Generative Recommendation》提出了提示-模型检索的完整框架,并基于该数据集验证了多种排序模型的有效性。后续研究进一步探索了多模态特征融合的检索算法,以及利用对比学习增强提示与模型表征的语义对齐。此外,该数据集与GEMRec-Gallery可视化平台相结合,催生了交互式模型比较工具的开发,为生成式AI的可用性研究提供了实证支撑。
以上内容由遇见数据集搜集并总结生成


