
LHUThacSi/ViSportSent_full
收藏官方服务:
资源简介:
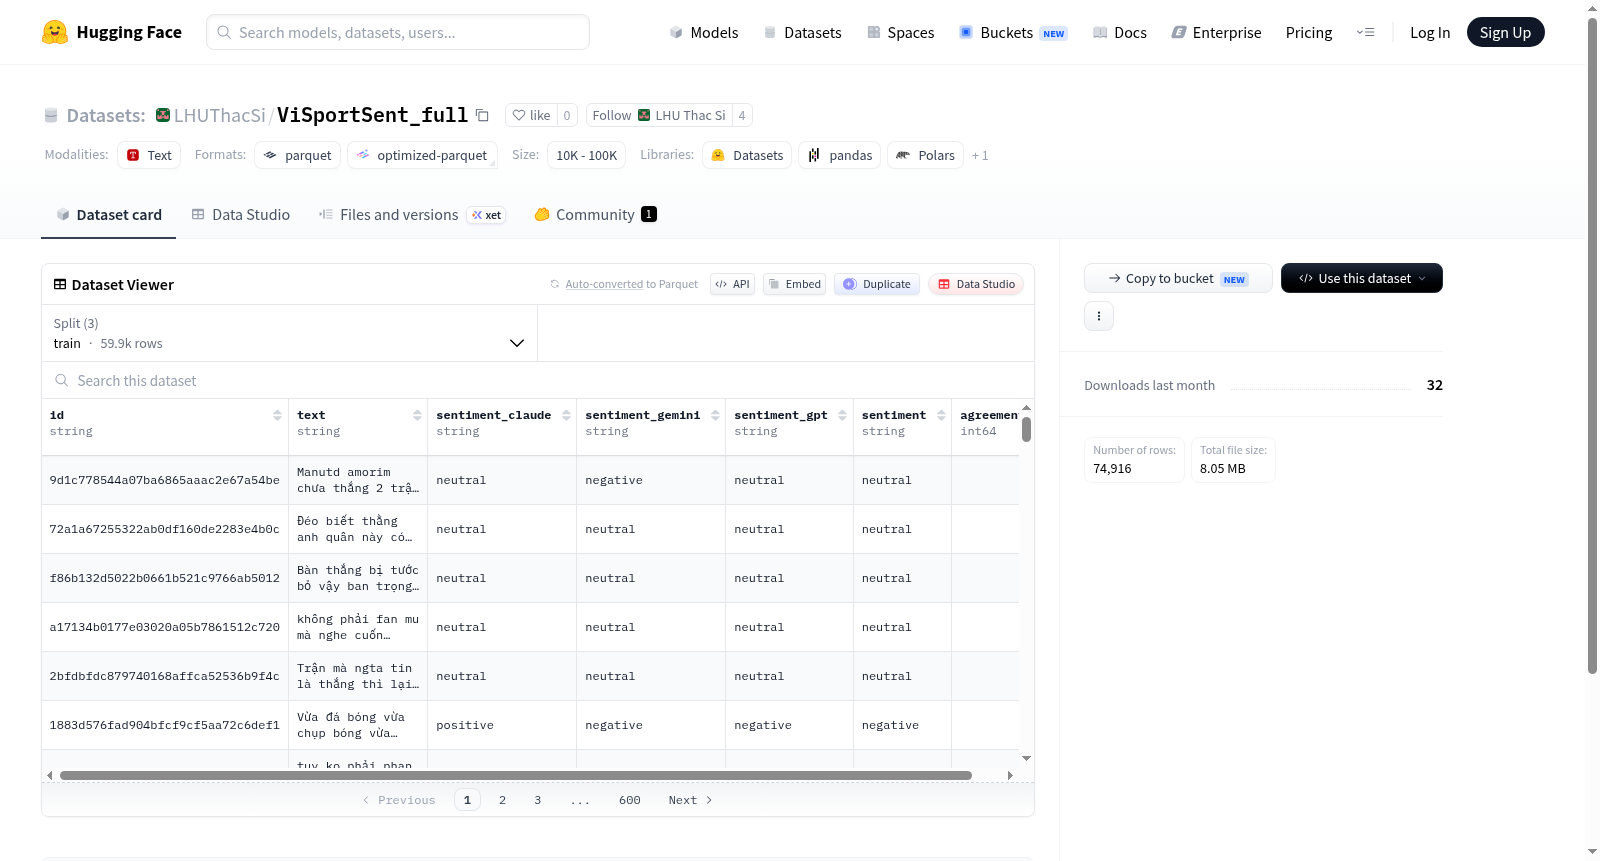
--- dataset_info: features: - name: id dtype: string - name: text dtype: string - name: sentiment_claude dtype: string - name: sentiment_gemini dtype: string - name: sentiment_gpt dtype: string - name: sentiment dtype: string - name: agreement dtype: int64 splits: - name: train num_bytes: 12371740 num_examples: 59932 - name: validation num_bytes: 1549136 num_examples: 7492 - name: test num_bytes: 1536941 num_examples: 7492 download_size: 8043972 dataset_size: 15457817 configs: - config_name: default data_files: - split: train path: data/train-* - split: validation path: data/validation-* - split: test path: data/test-* ---
提供机构:
LHUThacSi搜集汇总
数据集介绍
构建方式
在体育文本情感分析领域,ViSportSent_full数据集应运而生,专为越南语体育评论的情感倾向研究而构建。该数据集汇聚了来自多个来源的体育相关文本,通过精密的数据清洗与标注流程,确保每一则文本均被赋予情感标签。构建过程中,研究团队采用三大先进语言模型——Claude、Gemini与GPT——作为标注工具,分别产出'情感_Claude'、'情感_Gemini'与'情感_GPT'字段,进而通过综合评判算法将三者融合,形成最终的情感标签'sentiment'。同时,为衡量跨模型标注的一致性,数据集引入了'agreement'字段,以整数形式记录模型间的共识程度。最终,数据集被划分为训练集(59932条)、验证集(7492条)与测试集(7492条),支撑从模型训练到性能评估的完整流程。
特点
ViSportSent_full数据集最显著的特征在于其多维度的情感标注机制与体育领域的专业针对性。相较于传统单一来源的情感标注,该数据集创新性地集成了Claude、Gemini与GPT三大模型的独立判断,不仅提供了多视角的情感分析结果,还通过'agreement'字段量化了模型间的协同效力,为评估标签可靠性提供了实证基础。此外,数据集的文本内容均源自越南语体育语境,涵盖了赛事评论、运动员评价等多样化场景,确保了领域内情感表达的丰富性与真实性。其结构清晰,包含文本、情感标签及模型间的一致性度量,便于研究者深入探索跨模型情感分析的异同。
使用方法
使用ViSportSent_full数据集时,研究者可通过HuggingFace Datasets库便捷加载,支持按需选择训练、验证或测试子集。数据以JSON格式存储,每条记录包含唯一标识符'id'、原始文本'text'以及来自不同模型的情感标签,适合用于越南语情感分类任务的模型训练与基准测试。建议研究者利用'sentiment'字段作为标准监督标签,同时可对比'情感_Claude'、'情感_Gemini'与'情感_GPT'字段,分析不同模型在体育文本上的表现差异。此外,'agreement'字段可作为过滤条件,筛选高共识样本以提升训练质量。该数据集也可拓展至多模态情感分析或跨语言迁移学习,具有较强灵活性与应用潜力。
背景与挑战
背景概述
在体育赛事与社交媒体的深度融合背景下,针对越南语体育文本的情感分析研究显得尤为重要。ViSportSent_full数据集由相关研究机构创建,旨在系统性地解决越南语体育评论情感极性分类这一核心问题。该数据集包含了近75,000条人工标注的体育文本,每条文本融合了Claude、Gemini、GPT等多个大型语言模型的预标注结果,并通过多数投票机制确定最终情感标签。这一精细化的标注策略不仅提升了数据集的可靠性与一致性,也为越南语非通用情感分析领域提供了高质量的基准资源。该数据集的发布对于推动越南语自然语言处理、特别是体育舆情监控与智能分析技术的发展具有重要意义。
当前挑战
该数据集面临的核心挑战包括:其一,在领域问题层面,体育文本中充斥大量非正式表达、俚语及情绪化用语,使得传统情感词典方法与通用情感模型难以准确捕捉其细腻情感倾向,亟需针对特定领域与低资源语言构建专用数据集;其二,在构建过程中,三大语言模型对同一文本的情感判定常出现分歧,如何设计有效的标注整合机制以减少标注偏差、提升标签一致性成为重大难题;此外,越南语本身的词汇丰富性与句法多样性,也给数据清洗、标准化与高质量标注带来了额外挑战。
常用场景
经典使用场景
在自然语言处理与体育文本分析的交叉领域中,ViSportSent_full数据集凭借其丰富的越南语体育评论数据,成为情感分析研究的理想语料库。该数据集囊括近七万五千条标注样本,每条文本均附有基于多种大语言模型(如Claude、Gemini、GPT)的情感标签及综合判定结果与一致性评分。研究者常将其用于训练和评估针对体育领域的情感分类模型,捕捉球迷在赛事评论中流露的激昂、失落或中立等细腻情绪,进而推动非英语语言环境下情感理解的深度发展。
衍生相关工作
围绕ViSportSent_full数据集,学界已衍生出多项经典工作。研究者基于其多情感标签结构,开发了集成多个大语言模型判决的知识蒸馏方法,用于训练轻量级情感分析模型,实现高效部署。另有工作利用该数据集的一致性评分探索主动学习策略,在少样本条件下优化标注效率。此外,该数据集还催生了针对越南语体育文本的跨领域迁移学习研究,验证了其在政治、经济等其他情感分析任务中的泛化潜力,推动了低资源语言情感模型的边界拓展。
数据集最近研究
最新研究方向
ViSportSent_full数据集的诞生恰逢社交媒体情感分析研究从通用领域向垂直场景深度演进的浪潮,尤其在体育赛事这一充满激烈情绪表达与即时舆论互动的特殊场域中,为细粒度情感计算提供了高质量的越南语语料基础。当前,该数据集的前沿研究方向主要聚焦于多模型共识机制与标注质量评估,其通过整合Claude、Gemini及GPT三大先进语言模型的独立情感判断,构建了跨模型标签一致性比较的独特基准,进而探索不同架构下情感倾向的异同规律。这一设计不仅回应了学术界对于标注偏见与模型鲁棒性日益增长的关切,更为之后端到端的情感歧义消解与置信度建模研究铺平了道路,在低资源语言情感分析领域具有里程碑式的启发意义。
以上内容由遇见数据集搜集并总结生成


