
遇见数据集

PrimeIntellect/Multi-SWE-RL-Reupload

收藏
Hugging Face2026-07-08 更新2026-06-14 收录
官方服务:

资源简介:

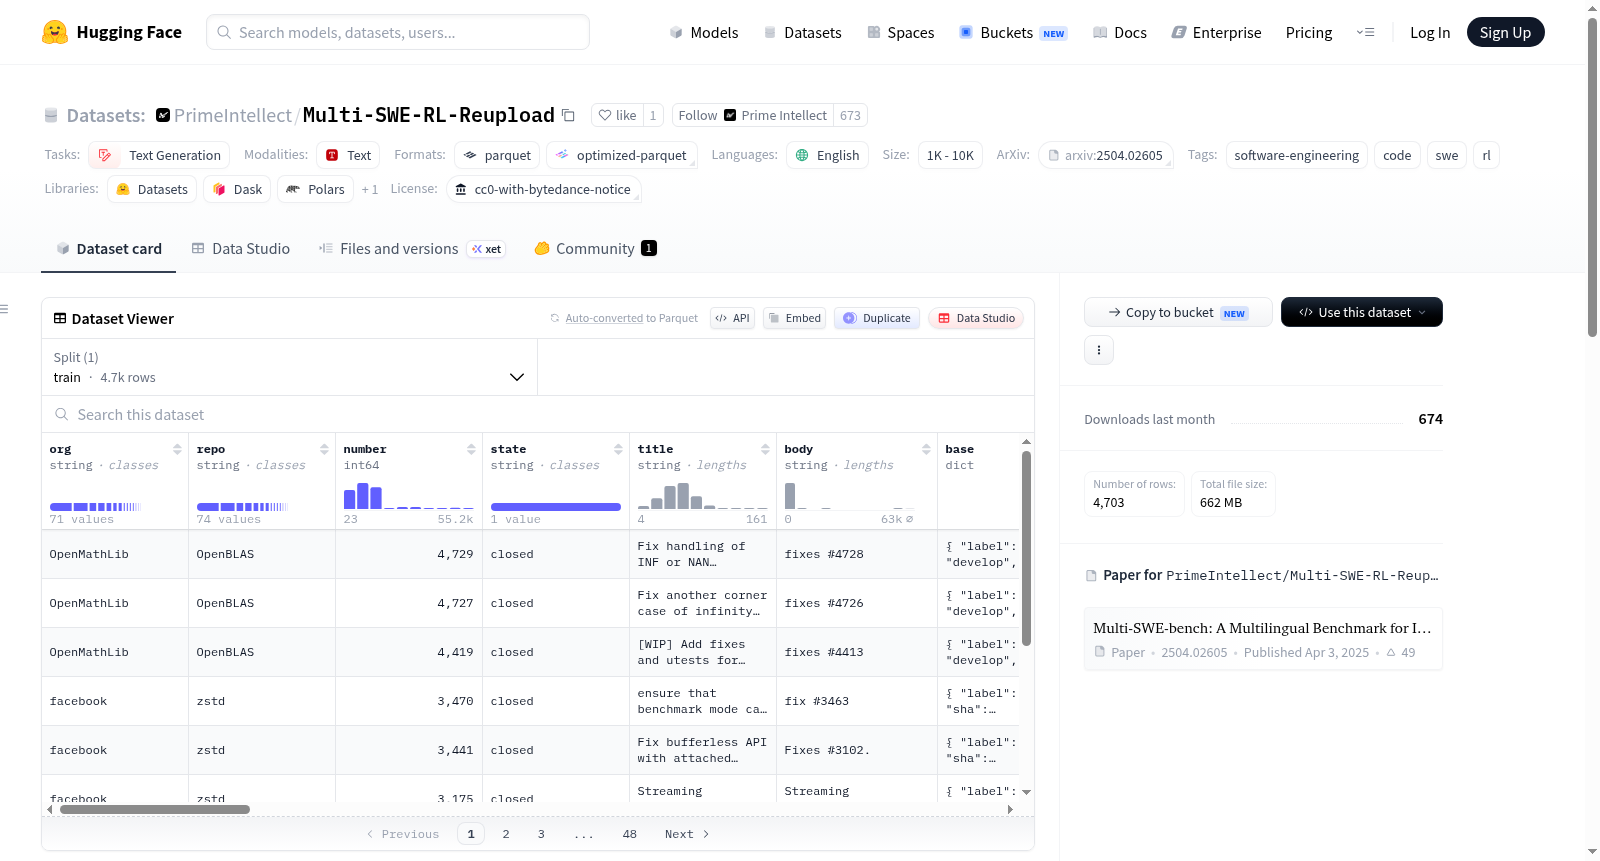
Multi-SWE-RL-Reupload 是 ByteDance 社区贡献数据集 Multi-SWE-RL 的逐字重新上传版本,包含 4,703 个容器化的软件工程问题解决任务,涵盖 C、C++、Go、Java、JavaScript、Rust 和 TypeScript 多种编程语言。该数据集旨在为复杂的软件工程任务提供高质量的强化学习(RL)数据,以支持自主软件工程代理的开发,并推动人工智能通用智能(AGI)的进展。数据集包括新收集的未标注 RL 数据以及从 Multi-SWE-bench 中丢弃的实例,任务涉及代码修复、测试执行等,可用于训练和评估代码生成与问题解决模型。数据集采用 CC0 许可证,但受 ByteDance 的知识产权约束,且底层仓库保留各自许可证。

Multi-SWE-RL-Reupload is a verbatim re-upload of ByteDances community-sourced Multi-SWE-RL dataset, containing 4,703 containerized issue-resolving tasks across C, C++, Go, Java, JavaScript, Rust, and TypeScript programming languages. This dataset aims to provide high-quality reinforcement learning (RL) data for complex software engineering tasks, supporting the development of autonomous software engineering agents and advancing towards Artificial General Intelligence (AGI). It includes newly collected unannotated RL data and discarded instances from Multi-SWE-bench, involving tasks such as code fixes and test execution, suitable for training and evaluating code generation and problem-solving models. The dataset is licensed under CC0, subject to ByteDances intellectual property rights, with underlying repositories retaining their own licenses.
提供机构:
PrimeIntellect
搜集汇总
数据集介绍
PrimeIntellect/Multi-SWE-RL-Reupload 数据集图片
构建方式
Multi-SWE-RL-Reupload 数据集是 ByteDance 社区贡献的 Multi-SWE-RL 数据集的忠实重传。该数据集通过收集来自 C、C++、Go、Java、JavaScript、Rust 和 TypeScript 等多种编程语言的真实开源仓库中的 Issue 解决任务构建而成。构建过程中,每个任务都被容器化以提供可复现的运行环境,并详细记录了 Issue 描述、修复补丁、测试补丁以及多个维度的测试结果(如固定测试、补丁到补丁测试等)。数据存储模式经过优化,将原先的嵌套结构转换为列式存储的列表结构,从而确保在使用 Hugging Face 的 datasets 库加载时不会发生结构联合爆炸的问题。
特点
该数据集的核心特点在于其多语言覆盖和容器化任务结构,共包含 4703 个 Issue 解决任务,横跨七种主流编程语言。每个样本不仅提供了完整的 Issue 上下文(包括标题、正文、基础分支信息),还配备了修复补丁、测试补丁及其运行结果的详细统计(通过、失败、跳过的测试数及具体测试列表)。特别值得关注的是,数据集引入了五种不同类型的测试映射(fixed_tests、p2p_tests、f2p_tests、s2p_tests、n2p_tests),为评估修复效果的准确性和全面性提供了多维度的指标。此外,该数据集已通过金补丁验证筛选出子集 Multi-SWE-RL-Verified,确保高质量基准。
使用方法
使用 Multi-SWE-RL-Reupload 数据集进行模型评估时,推荐安装官方提供的 multiswe_v1 任务集环境(来自 research-environments 仓库),并结合 verifiers 框架运行端到端评估。具体步骤为:首先通过 uv 包管理器安装 multiswe_v1 环境,然后使用 eval 命令指定任务集 ID、模型名称、采样次数(如 -n 100)和运行轮次(如 -r 4)来启动评估。该数据集已预先格式化为 Hugging Face datasets 兼容的结构,因此用户也可直接使用 datasets 库加载并访问其丰富的分层字段,灵活用于强化学习训练或模型微调中的反馈信号构建。
背景与挑战
背景概述
随着大型语言模型在代码生成领域的迅猛发展,构建能够解决真实世界软件工程问题的自主智能体成为人工智能研究的前沿热点。2025年,字节跳动Seed团队联合社区贡献者推出了Multi-SWE-RL数据集,旨在为强化学习提供高质量的多语言软件工程任务训练资源。该数据集包含4703个容器化的问题解决任务,覆盖C、C++、Go、Java、JavaScript、Rust和TypeScript七种编程语言,源自多个知名开源仓库。作为Multi-SWE-Bench生态的核心组成部分,该数据集填补了多语言、真实场景下强化学习训练数据匮乏的空白,推动了代码智能从单语言基准向多语言实战应用的跨越,对软件工程自动化领域产生了深远影响。
当前挑战
该数据集应对的核心领域挑战在于,传统代码基准数据集多局限于单一语言和简化任务,难以培养智能体应对复杂、跨语言、真实仓库中的问题修复能力。Multi-SWE-RL通过容器化技术将任务执行环境与测试验证过程紧密耦合,模拟了真实的软件开发协作场景。构建过程中面临的挑战包括:从海量开源仓库中筛选并标准化多语言问题实例,确保每个任务包含可复现的修复补丁和测试用例;设计统一的数据存储架构以兼容各异的结构化信息;协调社区贡献者进行大规模数据标注与验证,保证数据质量与一致性。此外,还需处理不同语言项目间的依赖环境差异,实现跨平台的可重复执行能力。
常用场景
经典使用场景
Multi-SWE-RL-Reupload数据集的核心应用场景在于为强化学习驱动的软件工程智能体提供高质量的、多语言的任务训练与评估环境。该数据集包含了4,703个容器化的代码问题解决任务,覆盖C、C++、Go、Java、JavaScript、Rust和TypeScript七种主流编程语言。每个任务不仅提供了完整的Issue描述、代码库上下文和修复补丁,还配备了丰富的测试用例集合(包括固定测试、传递性测试等),使得研究者能够构建能够自动理解问题、定位缺陷并生成正确修复代码的智能体。这些容器化任务确保了评估的可复现性和安全性,成为衡量各模型实际代码修复能力的基准。
实际应用
在实际应用中,Multi-SWE-RL-Reupload数据集为构建企业级的自动化代码维护和缺陷修复系统提供了关键基础设施。开发团队可以利用该数据集训练和微调大型语言模型,使其能够自动处理从用户报告、代码审查到实际补丁生成的全流程。例如,在持续集成/持续部署流水线中,经过该数据集训练的智能体可以自动分析失败的测试用例,定位代码中的根本原因,并提出或直接应用修复方案。对于需要维护大型、多语言代码库的组织而言,该数据集训练的模型能够显著降低人工排查缺陷的时间成本,提升软件迭代效率和代码质量,尤其在人力资宝贵或需要快速响应用户反馈的场景下具有突出的应用价值。
衍生相关工作
Multi-SWE-RL-Reupload作为多语言强化学习软件工程数据的重要贡献,其本身衍生并促进了一系列相关工作的开展。其中之一便是其子集PrimeIntellect/Multi-SWE-RL-Verified的出现,该子集通过金标准补丁验证确保了任务的质量,为研究提供了更为纯净的训练数据。该数据集直接支撑了ByteDance-Seed团队在Multi-SWE-Bench工作上的深入研究,后者设立了一个多语言的问题解决基准,推动了跨语言代码修复能力的可量化评估。此外,围绕该数据集构建的research-environments工具包和验证器框架为后续研究者提供了一套完整的训练与评估基础设施,促进了在自动化代码修复、程序合成和基于强化学习的软件工程智能体等领域的探索与迭代研究。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

