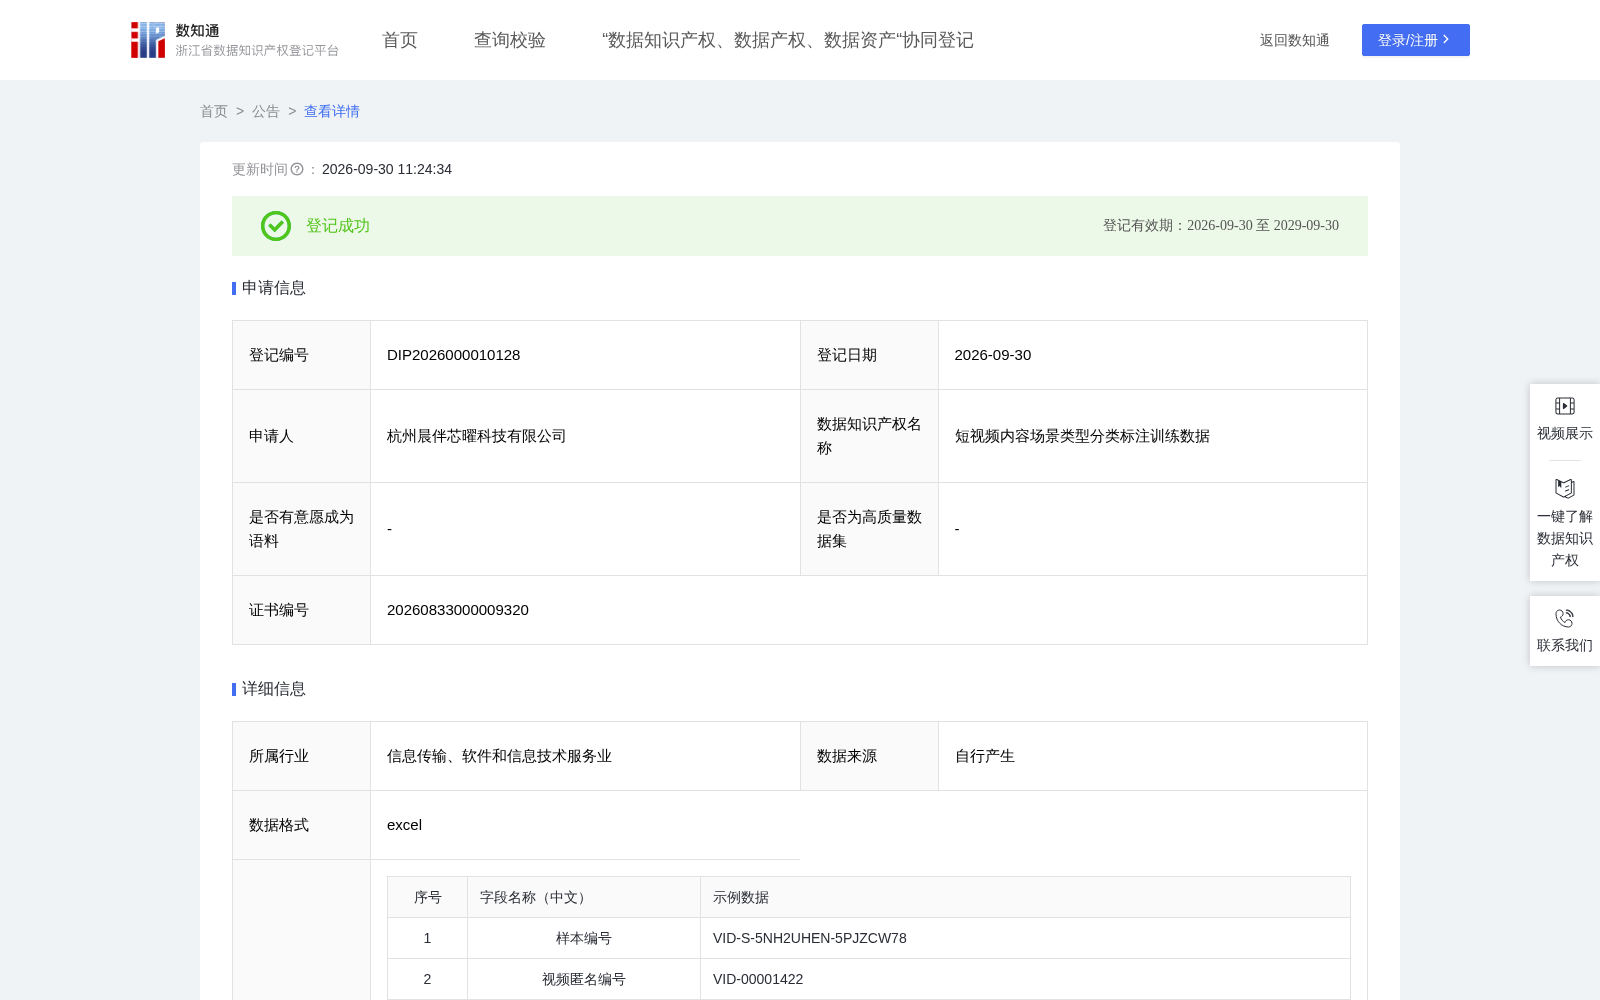
短视频内容场景类型分类标注训练数据
收藏资源简介:
本数据面向短视频平台、品牌投放方和内容服务商,适用于短视频场景识别、内容检索、推荐分发和商业投放匹配。通过融合关键帧图像特征与去标识化字幕语义,并计算主场景持续时长和时长占比,可形成办公学习、运动健身、室内生活、餐饮美食、购物消费和户外自然六类场景标签,为场景分类模型训练、同类视频自动归类和内容运营提供结构化数据。使用时需同时取得可辨认主要环境和活动对象的视频画面、关键帧及对应字幕。数据使用方可结合主场景识别依据回查画面与文本证据,利用持续时长和时长占比评价场景稳定程度,并按数据集划分标识完成模型训练、验证和测试。一、加工前的数据说明: 原始数据来源于企业自有内容平台的短视频、字幕和时间轴记录,原始字段包括视频编号、内容类别、原始视频、字幕文本和视频时长。 二、处理规则: 1.数据清洗:按视频编号去重,删除视频损坏、字幕或时长缺失及与任务无关的记录;统一视频方向、字幕编码和空白符,对字幕中的身份信息进行不可逆去标识化。 2.特征融合:按视频时间轴抽取能够反映环境、人物活动和主要物体的关键帧,图像分类模型从画面中提取场所、对象和动作特征;文本分类模型对字幕文本脱敏值进行分词和语义编码,提取与场景相关的活动及环境表达。将两类模型输出按同一六类场景体系进行对应,综合比较画面与字幕证据的一致方向,确定占主要内容的场景类型;同时记录关键帧图像编号,并将支持分类的画面特征和字幕语义整理为主场景识别依据。 3.时长计算:聚合同一场景的连续帧得到主场景持续时长,主场景时长占比=主场景持续时长/视频总时长,采用十进制定点四舍五入保留三位小数。关键帧时间和主场景持续时长均不得超过视频总时长。 4.算法校验:逐条复算主场景时长占比,核对关键帧时间、主场景持续时长、视频总时长、内容场景类型和主场景识别依据之间的一致性。画面或字幕证据不能支持所选场景类型的记录不进入最终数据集,相同核心场景签名仅保留一条;按视频匿名编号和“字幕文本脱敏值+内容场景类型+主场景识别依据”核心场景签名联合分组,并按场景类型分层以8:1:1划分训练集、验证集和测试集,避免同一视频或相同核心场景内容跨集合出现。 三、数据内容描述: 最终形成结构化的短视频内容场景类型分类标注训练数据集合,包含以下字段:1)样本编号:样本匿名唯一标识;2)视频匿名编号:视频去标识化编号;3)内容类别:短视频内容;4)关键帧时间(秒):关键帧在视频中的时间;5)关键帧图像编号:关键帧图像匿名标识;6)字幕文本脱敏值:去除身份信息后的字幕;7)主场景持续时长(秒):主场景连续出现的时长;8)视频总时长(秒):视频总时长;9)主场景时长占比:主场景持续时长与视频总时长之比;10)内容场景类型:办公学习、运动健身、室内生活、餐饮美食、购物消费或户外自然;11)主场景识别依据:支持场景分类的画面与文本证据;12)数据集划分标识:训练集、验证集或测试集。