
遇见数据集

NJU-LINK/CoVEBench

收藏
Hugging Face2026-06-09 更新2026-06-14 收录
官方服务:

资源简介:

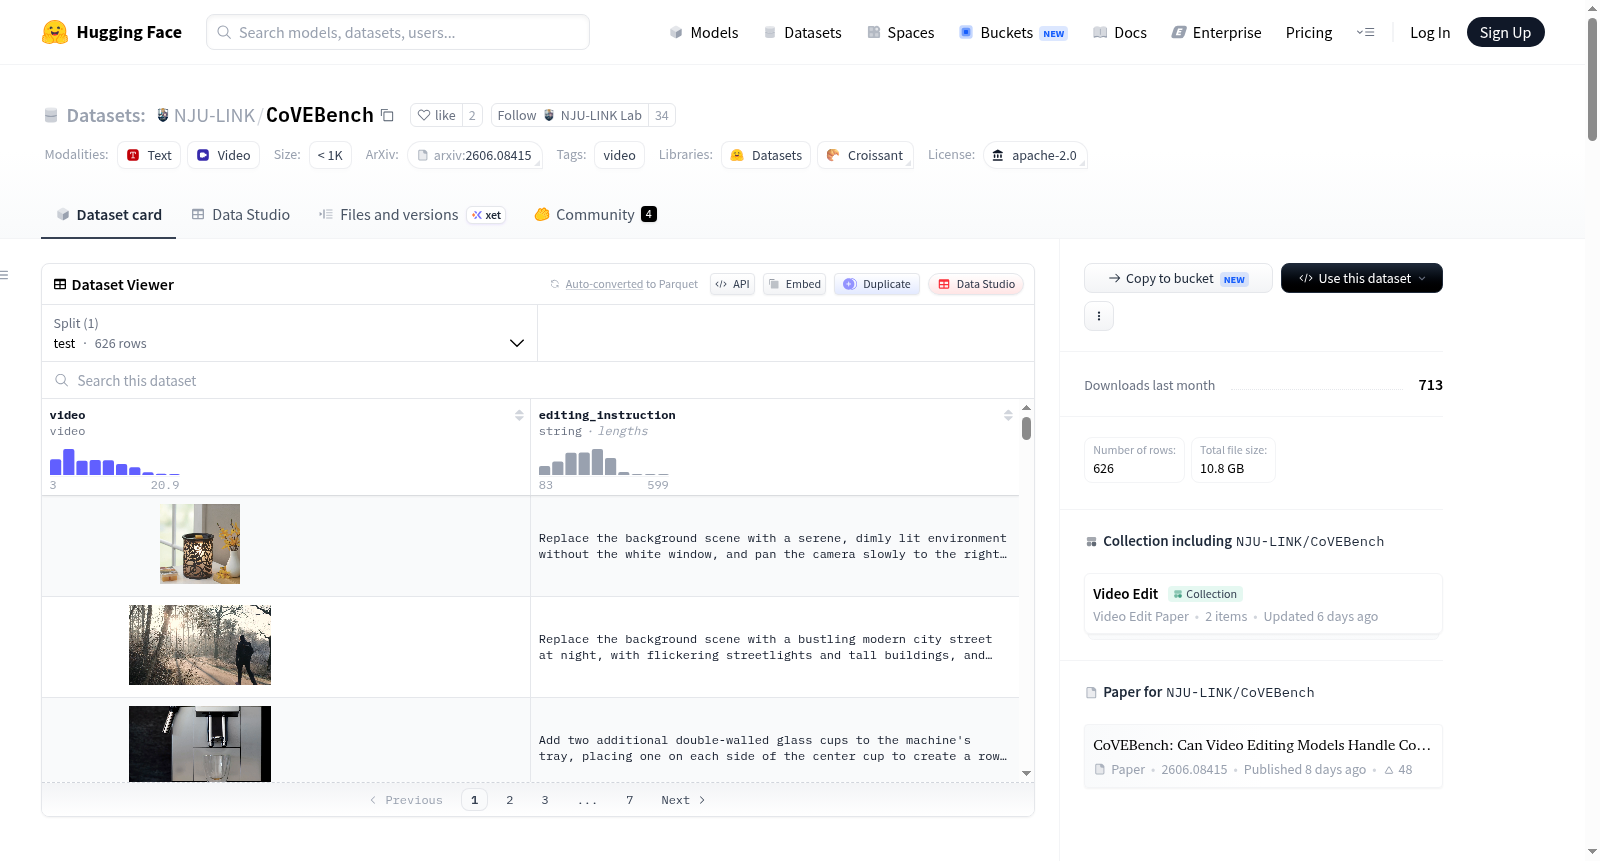
CoVEBench是一个用于组合式指令引导视频编辑的诊断性基准测试数据集,旨在评估视频编辑模型处理复杂、多操作指令的能力。该数据集包含418个源视频和626个检查表项,每个项包括源视频路径、编辑类别、原始描述、编辑指令、目标视频描述和评估组。它通过指令遵从性、视频质量和视频保真度三个维度,结合主观和客观指标,全面衡量编辑性能,特别关注模型在修改请求内容的同时保持无关语义和时间一致性的表现。

CoVEBench is a diagnostic benchmark for compositional instruction-guided video editing, designed to evaluate video editing models ability to handle complex, multi-operation instructions. The dataset includes 418 source videos and 626 checklist items, each containing source video paths, editing categories, original descriptions, editing instructions, target video descriptions, and evaluation groups. It measures editing performance across three dimensions: instruction compliance, video quality, and video fidelity, combining subjective and objective metrics to assess how well models modify requested content while preserving unrelated source video semantics and temporal coherence.
提供机构:
NJU-LINK
搜集汇总
数据集介绍
NJU-LINK/CoVEBench 数据集图片
构建方式
CoVEBench是一个面向组合式指令驱动视频编辑的诊断性基准数据集。其构建过程基于对真实复杂编辑场景的模拟,精心设计了涵盖多维度编辑需求的评估清单。数据集包含了418段源视频与626项检查清单条目,每一条目均对应一个组合式编辑指令,并附有原始视频描述、目标视频描述以及分组的评估问题。源视频以MP4格式存储于数据目录中,而元数据则通过JSONL文件组织,便于索引与加载。检查清单文件进一步细化了评估维度,确保每项编辑操作在指令遵从、物理逻辑与语义保持等方面均可被量化分析。
特点
CoVEBench的核心特点在于其超越传统单操作编辑基准的评估范式。它聚焦于现实场景中常见的多点组合指令,要求模型在修改指定内容的同时,必须严格保持无关区域的语义一致性及时间连贯性。该基准从指令遵从、视频质量与视频保真度三个互补维度进行度量,融合了基于多模态大语言模型的主观检查清单评分与客观质量指标。具体评估指标包括并集精度、指令遵循得分、视频真实感得分,以及结构相似性、运动保真度等,形成了一个系统而全面的诊断框架。
使用方法
使用CoVEBench时,研究人员可通过Hugging Face的snapshot_download函数完整下载数据集仓库。随后加载根目录下的checklist.json文件,解析其中的检查清单条目,并根据videoA_path字段获取源视频的本地路径。每条检查清单条目包含详细的编辑指令与评估问题分组,可直接用于模型的推理与结果评估。数据集提供了标准的评价脚本仓库,用户可结合官方发布的评估代码,调用各维度指标对模型输出的编辑视频进行自动化打分,从而高效地衡量模型在处理复杂视频编辑指令时的综合性能。
背景与挑战
背景概述
CoVEBench由南京大学LINK研究团队于2026年提出,旨在解决视频编辑领域缺乏对组合性指令评估基准的问题。现有的视频编辑基准多聚焦于单一操作,无法衡量模型在真实场景中处理多点指令的能力,即同时执行多项修改任务,同时保持无关区域的语义一致性与时间连贯性。作为首个诊断性基准,CoVEBench通过引入基于多模态大语言模型的检查清单机制,从指令遵循、视频质量与保真度三个维度系统评估模型表现,揭示了当前模型在面对复杂指令时的局限性,为视频编辑研究提供了更具挑战性的测试平台,推动了领域内评估标准向实用化与精细化方向发展。
当前挑战
CoVEBench面临的核心挑战源于组合性指令视频编辑任务的复杂性。在领域问题层面,现有模型难以同时满足多样化的编辑要求,往往在完成部分指令时失败于严格的一致性判据,编辑强度与区域保留之间的矛盾未被有效解决,导致优化过程失焦。在基准构建层面,设计涵盖真实场景的多点编辑指令需要精心平衡指令复杂度与可评估性,同时确保检查清单的细粒度足以暴露单指标评分无法捕捉的失败模式,这对数据集质量控制与注释标准提出了极高要求,需在指令多样性、视频来源广泛性与评估科学性之间寻求平衡。
常用场景
经典使用场景
在视频编辑与计算机视觉的交汇领域,CoVEBench作为首个专注于组合性指令引导视频编辑的诊断基准,为评估模型对复杂多动作指令的理解与执行能力提供了权威标尺。该数据集的核心应用场景在于评测视频编辑模型是否能够在遵循用户给出的复合编辑指令的同时,精准保留源视频中未提及区域的语义内容与时间连贯性。研究者借助CoVEBench中精心设计的626项检查清单,可以系统性地检验模型在每次编辑操作上的准确性,并依循“联合准确率”等严格指标,揭示模型在应对真实世界中多步骤、多目标编辑需求时的真实性能边界。
衍生相关工作
受CoVEBench的研究启发,学术界涌现出若干旨在提升视频编辑组合指令理解能力的后续工作,如面向指令分解的训练策略创新与基于区域感知的注意力机制改进。部分研究团队基于CoVEBench的检查清单框架,进一步构建了多语指令视频编辑基准,拓展了该评测体系在跨语言场景下的适用性。同时,CoVEBench所公开的评估代码与详细指标规范,也被多个视频生成模型的开源项目采纳为标准评测模块,催生出一系列关于编辑强度控制与时空一致性保持的专项优化技术,形成了以诊断驱动的视频编辑研究新生态。
数据集最近研究
最新研究方向
当前视频编辑领域正从单一操作的简单任务评估迈向复合指令的精细化诊断,CoVEBench作为首个针对组合性指令引导视频编辑的标杆性基准,聚焦于评估模型在保持源视频语义与时间连贯性的同时,精准执行多要点编辑指令的能力。该基准通过融合多模态大语言模型驱动的清单式主观评分与客观质量、保真度指标,对指令遵循、视频质量与视频保真度三大维度进行立体化剖析,揭示出现有模型在满足严格联合标准时普遍存在的编辑强度与保留性失衡、细粒度编辑点遗漏等关键瓶颈,为推动复杂场景下视频编辑模型的鲁棒性提升与语义对齐优化提供了系统性的评估框架与严谨的度量基准。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

