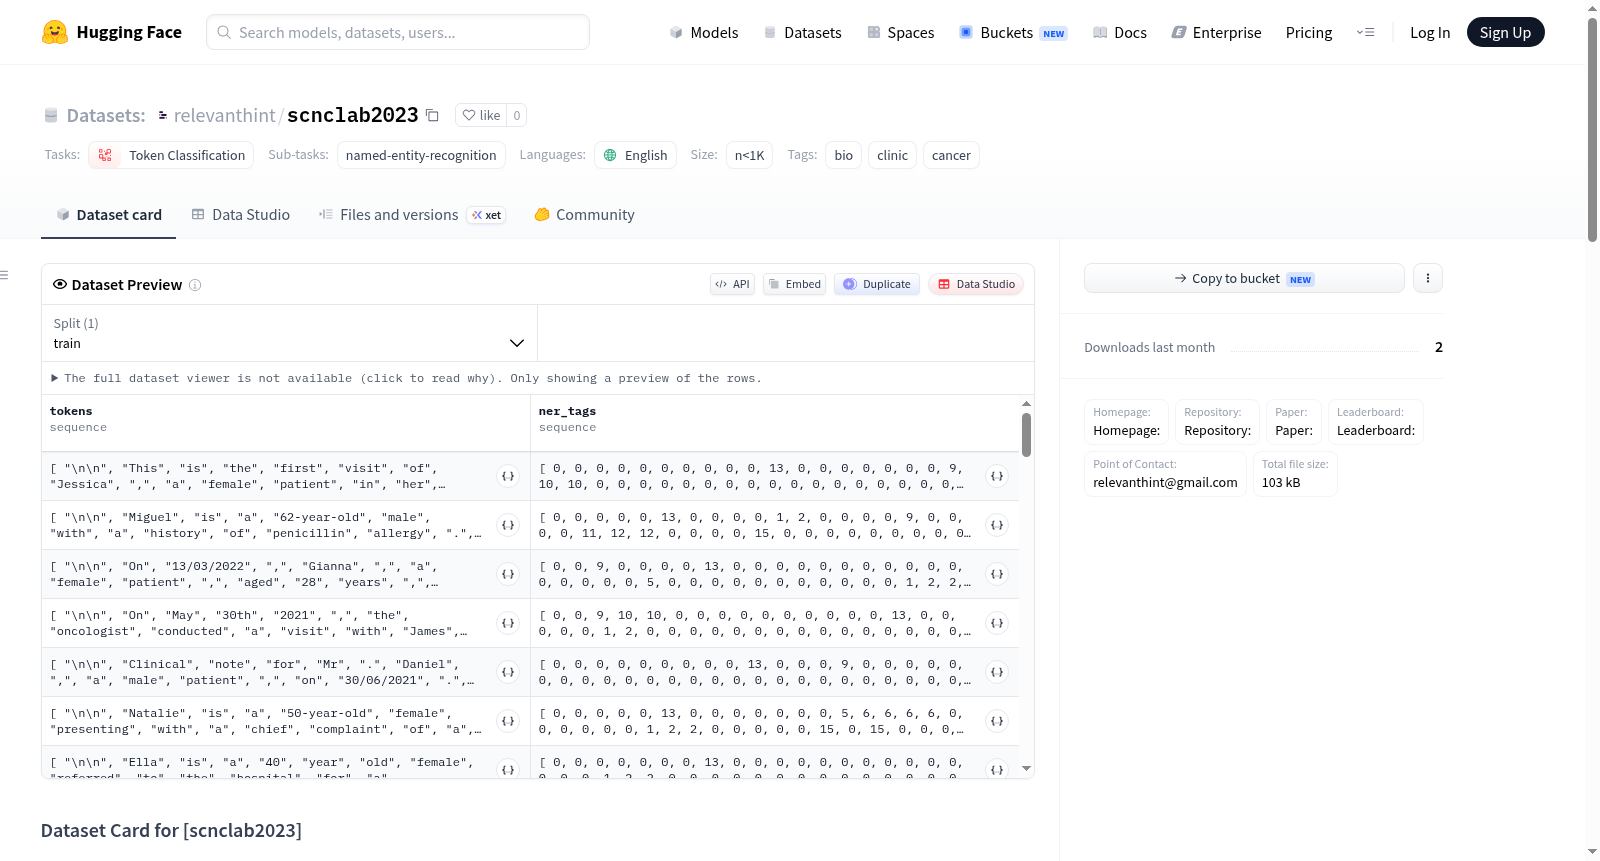
relevanthint/scnclab2023
收藏资源简介:
--- annotations_creators: - expert-generated language: - en language_creators: - machine-generated license: [] multilinguality: - monolingual paperswithcode_id: scnclab2023 pretty_name: Synthetical Clinical Notes - Clab 2023 dataset_info: features: - name: tokens sequence: string - name: ner_tags sequence: class_label: names: '0' : O '1' : B-allergies '2' : I-allergies '3' : B-biomarkers '4' : I-biomarkers '5' : B-cancer_symptoms '6' : I-cancer_symptoms '7' : B-cancer_type '8' : I-cancer_type '9' : B-date '10' : I-date '11' : B-diagnosis '12' : I-diagnosis '13' : B-gender '14' : I-gender '15' : B-imaging_options '16' : I-imaging_options '17' : B-test_result '18' : I-test_result '19' : B-treatment '20' : I-treatment size_categories: - n<1K source_datasets: - original tags: - bio - clinic - cancer task_categories: - token-classification task_ids: - named-entity-recognition --- # Dataset Card for [scnclab2023] ## Table of Contents - [Table of Contents](#table-of-contents) - [Dataset Description](#dataset-description) - [Dataset Summary](#dataset-summary) - [Supported Tasks and Leaderboards](#supported-tasks-and-leaderboards) - [Languages](#languages) - [Dataset Structure](#dataset-structure) - [Data Instances](#data-instances) - [Data Fields](#data-fields) - [Data Splits](#data-splits) - [Dataset Creation](#dataset-creation) - [Curation Rationale](#curation-rationale) - [Source Data](#source-data) - [Annotations](#annotations) - [Personal and Sensitive Information](#personal-and-sensitive-information) - [Considerations for Using the Data](#considerations-for-using-the-data) - [Social Impact of Dataset](#social-impact-of-dataset) - [Discussion of Biases](#discussion-of-biases) - [Other Known Limitations](#other-known-limitations) - [Additional Information](#additional-information) - [Dataset Curators](#dataset-curators) - [Licensing Information](#licensing-information) - [Citation Information](#citation-information) - [Contributions](#contributions) ## Dataset Description - **Homepage:** - **Repository:** - **Paper:** - **Leaderboard:** - **Point of Contact:** relevanthint@gmail.com ### Dataset Summary [More Information Needed] ### Supported Tasks and Leaderboards [More Information Needed] ### Languages [More Information Needed] ## Dataset Structure ### Data Instances [More Information Needed] ### Data Fields [More Information Needed] ### Data Splits [More Information Needed] ## Dataset Creation ### Curation Rationale The Dataset has been created using the GPT-3 API by providing a prompt with some manually created clinical notes. #### Who are the source language producers? [More Information Needed] ### Annotations #### Annotation process The annotation has been done using [Argilla](https://github.com/argilla-io) #### Who are the annotators? The sinthetical clinical notes have been annotated by a group of three biomedical experts ### Personal and Sensitive Information [More Information Needed] ## Considerations for Using the Data ### Social Impact of Dataset Note that this is not a real dataset. ### Discussion of Biases [More Information Needed] ### Other Known Limitations [More Information Needed] ## Additional Information ### Dataset Curators [More Information Needed] ### Licensing Information [More Information Needed] ### Citation Information [More Information Needed] ### Contributions Thanks to [@github-username](https://github.com/<github-username>) for adding this dataset.
annotations_creators: - 专家生成 language: - en language_creators: - 机器生成 license: [] multilinguality: - 单语言 paperswithcode_id: scnclab2023 pretty_name: 合成临床笔记——Clab 2023 dataset_info: features: - name: 词元(Token) sequence: 字符串 - name: 命名实体识别标签 sequence: 类标签: 名称: '0' : O '1' : B-过敏症 '2' : I-过敏症 '3' : B-生物标志物 '4' : I-生物标志物 '5' : B-癌症症状 '6' : I-癌症症状 '7' : B-癌症类型 '8' : I-癌症类型 '9' : B-日期 '10' : I-日期 '11' : B-诊断结果 '12' : I-诊断结果 '13' : B-性别 '14' : I-性别 '15' : B-影像检查选项 '16' : I-影像检查选项 '17' : B-检测结果 '18' : I-检测结果 '19' : B-治疗方案 '20' : I-治疗方案 size_categories: - 样本量小于1000 source_datasets: - 原创数据集 tags: - 生物信息学 - 临床 - 癌症 task_categories: - 词元分类(Token Classification) task_ids: - 命名实体识别(Named Entity Recognition) # 数据集卡片 [scnclab2023] ## 目录 - [目录](#目录) - [数据集描述](#数据集描述) - [数据集概述](#数据集概述) - [支持任务与排行榜](#支持任务与排行榜) - [语言](#语言) - [数据集结构](#数据集结构) - [数据实例](#数据实例) - [数据字段](#数据字段) - [数据划分](#数据划分) - [数据集构建](#数据集构建) - [构建初衷](#构建初衷) - [源数据](#源数据) - [注释](#注释) - [个人与敏感信息](#个人与敏感信息) - [数据集使用注意事项](#数据集使用注意事项) - [数据集的社会影响](#数据集的社会影响) - [偏差讨论](#偏差讨论) - [其他已知局限性](#其他已知局限性) - [附加信息](#附加信息) - [数据集维护者](#数据集维护者) - [许可信息](#许可信息) - [引用信息](#引用信息) - [贡献](#贡献) ## 数据集描述 - **主页:** - **代码仓库:** - **论文:** - **排行榜:** - **联系方式:** relevanthint@gmail.com ### 数据集概述 [更多信息待补充] ### 支持任务与排行榜 [更多信息待补充] ### 语言 [更多信息待补充] ## 数据集结构 ### 数据实例 [更多信息待补充] ### 数据字段 [更多信息待补充] ### 数据划分 [更多信息待补充] ## 数据集构建 ### 构建初衷 本数据集通过GPT-3 API构建,向接口输入包含若干人工撰写的临床笔记的提示词完成生成。 #### 源语言生成者是谁? [更多信息待补充] ### 注释 #### 注释流程 本数据集的注释工作通过[Argilla](https://github.com/argilla-io)工具完成。 #### 注释人员是谁? 本合成临床笔记由三名生物医学专家组成的团队完成注释。 ### 个人与敏感信息 [更多信息待补充] ## 数据集使用注意事项 ### 数据集的社会影响 请注意,本数据集并非真实临床数据集。 ### 偏差讨论 [更多信息待补充] ### 其他已知局限性 [更多信息待补充] ## 附加信息 ### 数据集维护者 [更多信息待补充] ### 许可信息 [更多信息待补充] ### 引用信息 [更多信息待补充] ### 贡献 感谢[@github-username](https://github.com/<github-username>)为本数据集添加至仓库。
数据集概述
- 名称: Synthetical Clinical Notes - Clab 2023
- ID: scnclab2023
- 语言: 英语 (en)
- 语言生成方式: 机器生成
- 多语言性: 单语种
- 任务类别: 词元分类
- 任务ID: 命名实体识别
- 标签创建者: 专家生成
- 数据集大小: 小于1000条记录
- 源数据集: 原始数据
- 标签: 生物、临床、癌症
数据集结构
数据字段
- tokens: 字符串序列
- ner_tags: 标签序列,包含以下类别:
- O
- B-allergies
- I-allergies
- B-biomarkers
- I-biomarkers
- B-cancer_symptoms
- I-cancer_symptoms
- B-cancer_type
- I-cancer_type
- B-date
- I-date
- B-diagnosis
- I-diagnosis
- B-gender
- I-gender
- B-imaging_options
- I-imaging_options
- B-test_result
- I-test_result
- B-treatment
- I-treatment
数据集创建
注释过程
- 注释工具: Argilla
- 注释者: 一组三名生物医学专家
数据生成
- 生成方式: 使用GPT-3 API,通过提供手动创建的临床笔记作为提示
注意事项
- 数据集真实性: 注意,这不是一个真实的数据集。