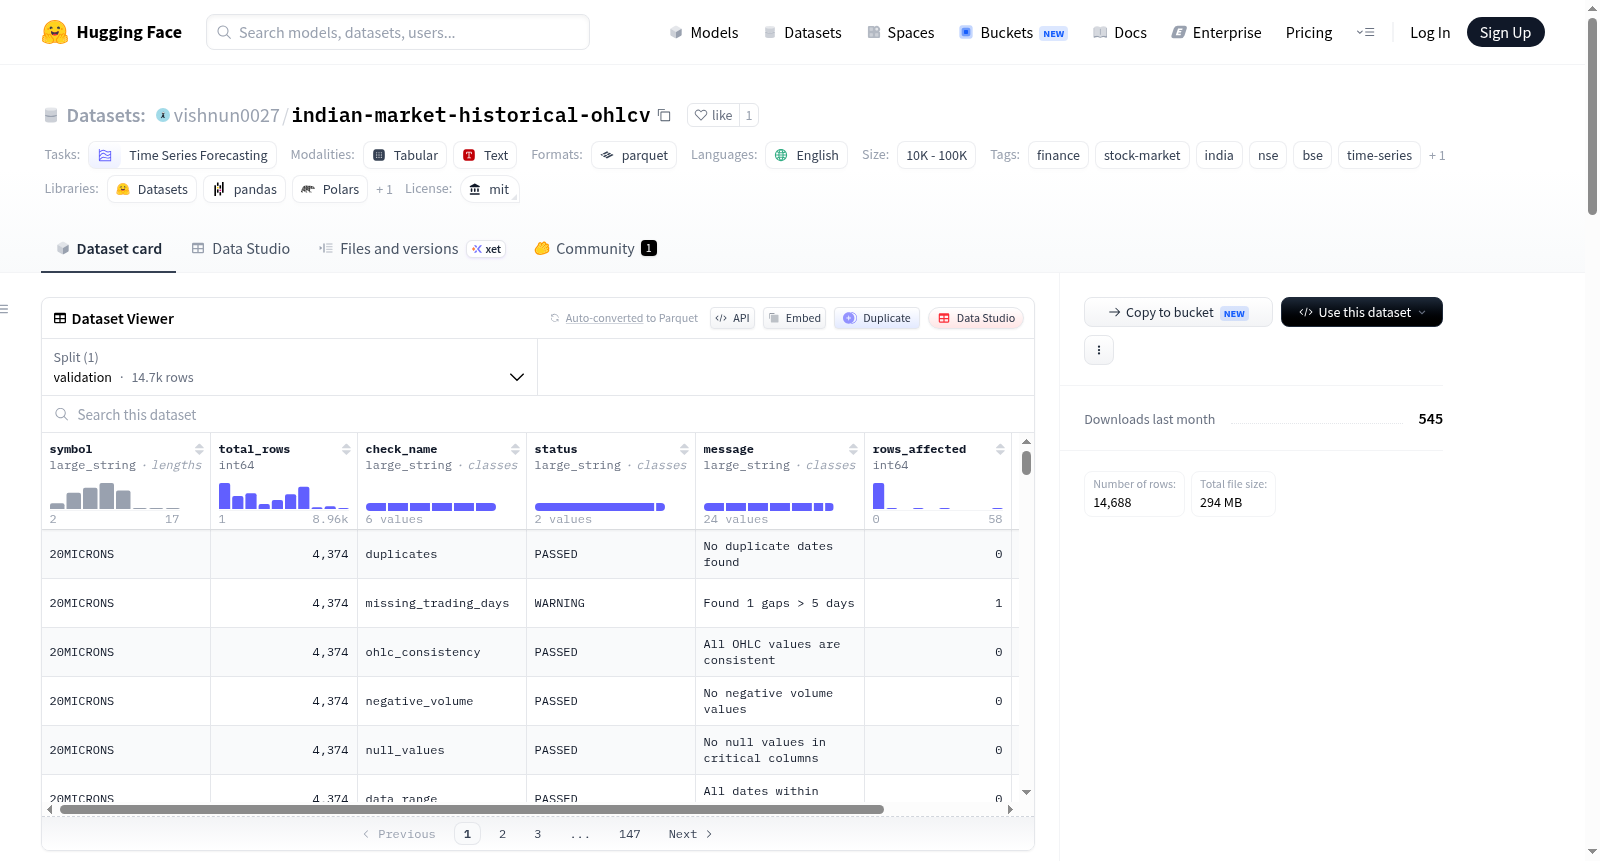
indian-market-historical-ohlcv
收藏资源简介:
该数据集是一个针对印度金融市场(包括国家证券交易所NSE和孟买证券交易所BSE)的生产级历史OHLCV(开盘价、最高价、最低价、收盘价、成交量)数据集,通过GitHub Actions每日(工作日)自动更新。数据来源于Yahoo Finance(通过yfinance工具获取)。数据集包含多种资产类型:股票(2383个符号,270.5 MB)、指数(17个,3.0 MB)、交易所交易基金(ETF,17个,2.0 MB)、大宗商品(8个,1.7 MB)和外汇(8个,1.8 MB),总计2433个文件,大小约279.0 MB。每个Parquet文件包含以下字段:交易日期(date)、开盘价(open)、当日最高价(high)、当日最低价(low)、收盘价(close)、调整后收盘价(adj_close,考虑股票分割和股息)、成交量(volume)、股息金额(dividends)、股票分割比率(stock_splits)和股票代码(symbol)。数据集适用于时间序列预测等金融分析任务,每次同步运行会进行数据质量验证,包括检查重复日期、OHLC一致性(如最高价≥最低价)、缺失值、成交量异常和交易日间隙。文件结构按资产类型组织,包含stocks、indices、etfs、commodities、forex等子目录。数据集采用MIT许可证。
This dataset is a production-level historical OHLCV (Open, High, Low, Close, Volume) dataset for the Indian financial markets (National Stock Exchange NSE and Bombay Stock Exchange BSE), automatically updated daily (on business days) via GitHub Actions. The data is sourced from Yahoo Finance (obtained through the yfinance tool). The dataset includes various asset types: stocks (2383 symbols, 270.5 MB), indices (17, 3.0 MB), exchange-traded funds (ETFs, 17, 2.0 MB), commodities (8, 1.7 MB), and forex (8, 1.8 MB), totaling 2433 files with an approximate size of 279.0 MB. Each Parquet file contains the following fields: trading date (date), open price (open), daily high price (high), daily low price (low), close price (close), adjusted close price (adj_close, accounting for stock splits and dividends), volume (volume), dividend amount (dividends), stock split ratio (stock_splits), and stock symbol (symbol). The dataset is suitable for financial analysis tasks such as time series forecasting. Each synchronization run includes data quality validation, checking for duplicate dates, OHLC consistency (e.g., high ≥ low), missing values, volume anomalies, and trading day gaps. The file structure is organized by asset type, with subdirectories including stocks, indices, etfs, commodities, and forex. The dataset is licensed under MIT.
数据集概述
数据集名称:Indian Market Data (NSE/BSE)
地址:https://huggingface.co/datasets/vishnun0027/indian-market-historical-ohlcv
语言:英文
许可证:MIT
标签:金融、股票市场、印度、NSE、BSE、时间序列、OHLCV
任务类别:时间序列预测
大小类别:1M < n < 10M
数据集摘要
- 总文件数:2,434
- 总大小:279.1 MB
- 最后更新:2026-07-07 17:10 UTC
- 更新频率:每个工作日(每日)
- 数据来源:Yahoo Finance(通过 yfinance 获取)
资产覆盖
| 资产类型 | 数量 | 大小 |
|---|---|---|
| 股票 | 2,384 | 270.6 MB |
| 指数 | 17 | 3.0 MB |
| ETF | 17 | 2.0 MB |
| 大宗商品 | 8 | 1.7 MB |
| 外汇 | 8 | 1.8 MB |
数据模式(Schema)
每个 Parquet 文件包含以下列,记录每日 OHLCV 数据:
| 列名 | 类型 | 描述 |
|---|---|---|
date |
date32 |
交易日期 |
open |
float64 |
开盘价 |
high |
float64 |
当日最高价 |
low |
float64 |
当日最低价 |
close |
float64 |
收盘价 |
adj_close |
float64 |
复权收盘价(考虑拆分和股息) |
volume |
int64 |
交易量 |
dividends |
float64 |
股息金额 |
stock_splits |
float64 |
股票拆分比率 |
symbol |
string |
股票代码 |
文件结构
├── stocks/ # NSE/BSE 股票数据(.parquet) ├── indices/ # 市场指数数据(.parquet) ├── etfs/ # 交易所交易基金数据(.parquet) ├── commodities/ # 大宗商品期货数据(.parquet) ├── forex/ # 货币对数据(*.parquet) ├── metadata/ # 资产列表与目录 └── sync_status.json # 上次同步时间戳与统计信息
数据质量
每次同步运行时会验证以下方面:
- 重复日期
- OHLC 一致性(最高价 ≥ 最低价,边界检查)
- 缺失值
- 交易量异常
- 交易日缺口
使用示例(Python)
python import pandas as pd
加载单个股票
df = pd.read_parquet("hf://datasets/vishnun0027/indian-market-historical-ohlcv/stocks/RELIANCE.parquet")
加载所有股票
from datasets import load_dataset ds = load_dataset("vishnun0027/indian-market-historical-ohlcv", data_dir="stocks")