
KlingTeam/VWG-Bench
收藏官方服务:
资源简介:
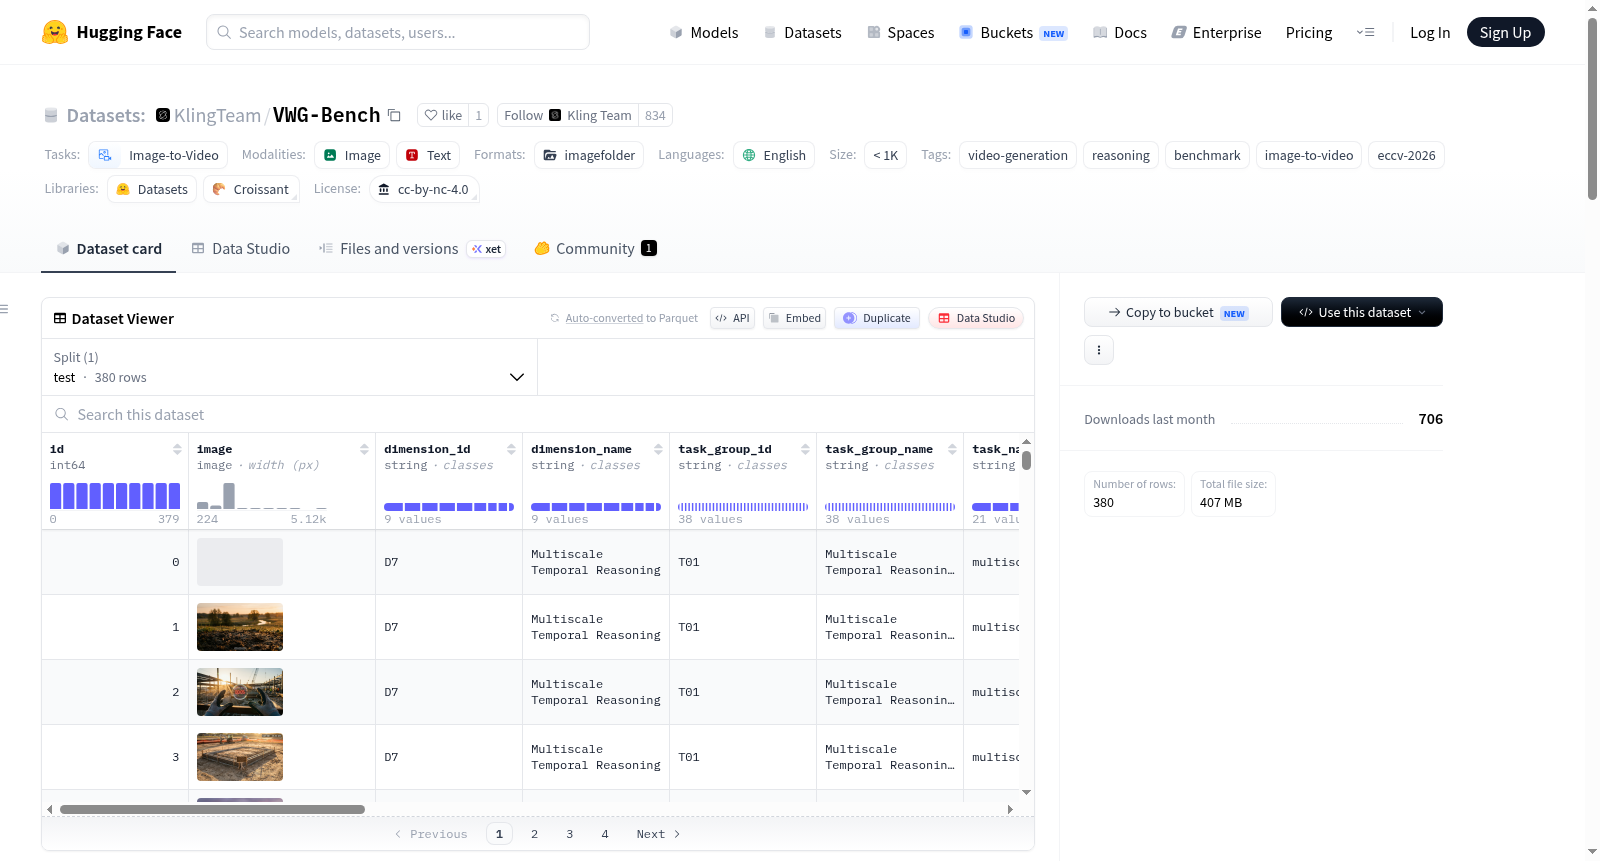
VWG-Bench(视频世界通用基准)是一个图像到视频推理基准,用于评估视频生成模型是否能够遵循符号规则,尊重物理和常识约束,并在时间推移中实现预期目标。测试集包含380个初始图像和结构化注释,这些注释被组织成9个推理维度和38个十个样本的任务组。该数据集旨在通过多维度评估视频生成模型的推理能力,包括视频质量、进度一致性、隐式规则遵循、进度目标实现和最终帧目标实现等方面。数据集仅包含测试集,每个任务组有10个样本,评估分数范围为1到5的整数。
VWG-Bench (Video World Generalist Benchmark) is an image-to-video reasoning benchmark for evaluating whether video generation models can follow symbolic rules, respect physical and commonsense constraints, and realize intended goals over time. The test split contains 380 initial images and structured annotations organized into 9 reasoning dimensions and 38 ten-sample task groups.
提供机构:
KlingTeam搜集汇总
数据集介绍
构建方式
VWG-Bench是一个面向图像到视频生成模型的推理基准测试数据集,旨在评估模型在遵循符号规则、尊重物理与常识约束以及实现目标导向行为方面的能力。该数据集包含380个测试样本,每个样本由一张初始图像和结构化标注组成,这些标注按照9个推理维度和38个十样本任务组进行系统化组织。数据集遵循Hugging Face ImageFolder布局规范,其核心数据文件metadata.jsonl记录了每个样本的唯一标识符、图像路径、所属维度与任务组信息、用户生成指令、期望的最终帧目标及可选的过程目标、前景/背景一致性规则、隐式物理或逻辑约束等丰富字段,从而为细粒度的推理能力评估提供了结构化基础。
使用方法
VWG-Bench的使用依托于其配套的evaluation_code评估工具包。用户可通过执行validate-data命令对本地数据集进行完整性校验,随后利用evaluation_code目录下的评估脚本对生成视频进行多维度打分。生成的视频文件需遵循{id}_seed{seed}.mp4的命名规范,例如0_seed0.mp4。通过设置环境变量GEMINI_API_KEY并运行eval_vwg.sh脚本,用户可以批量评估并输出JSON格式的结果文件。评估工具包还提供了外部基准适配器接口,便于将VWG-Bench集成到更广泛的视频生成模型评测流程中。数据集遵循CC BY-NC 4.0许可协议,适用于非商业学术研究场景。
背景与挑战
背景概述
VWG-Bench(Video World Generalist Benchmark)是一个面向图像到视频(Image-to-Video)生成任务的推理基准数据集,由相关研究团队在ECCV 2026会议背景下创建。该数据集旨在系统性地评估视频生成模型是否能够遵循符号规则、尊重物理与常识约束,并在时间维度上实现预期目标。通过涵盖9个推理维度与38个十样本任务组,VWG-Bench为视频基础模型的世界理解能力提供了精细化的评测框架。其构建标志着视频生成评估从视觉质量向高阶推理能力的重要演进,对推动视频生成领域的理论发展和实际应用具有深远影响。
当前挑战
VWG-Bench所解决的核心领域挑战在于当前视频生成模型普遍缺乏对物理规律、符号逻辑及常识约束的遵循能力,多数模型仅能生成外观连贯的视觉内容,而无法在语义层面完成目标导向的推理任务。在数据集构建过程中,研究团队面临着如何将抽象的推理规则(如隐含物理约束、进度目标)转化为可量化的评测指标,以及如何确保380个样本在9个推理维度上均衡分布、避免任务设计中的歧义与偏差。此外,针对评估工具的标准化开发也颇具挑战,需支持多维度指标(如视频质量、进度一致性、目标达成度)的自动计算,同时兼容可选的评价维度,以实现灵活且公正的性能判定。
常用场景
经典使用场景
VWG-Bench作为图像到视频生成领域的推理基准,专用于评估视频生成模型在复杂逻辑约束下的表现。该数据集通过提供380张初始图像及其结构化标注,构建了涵盖9个推理维度和38个十样本任务组的测试框架。其核心使用场景在于系统性地检验模型是否能够遵循符号规则、尊重物理与常识约束,并在时间跨度内实现预期目标。研究人员利用该基准,可精确衡量生成视频在视觉质量、过程一致性、隐含规则遵循、进度目标实现及最终帧目标达成五个维度上的表现,从而推动视频生成技术从简单的视觉模仿向具有推理能力的智能生成范式演进。
解决学术问题
VWG-Bench针对性地解决了视频生成模型在推理能力评估中的空白问题。长期以来,学术界面临的核心挑战在于缺乏一个能够量化模型对符号规则、物理规律和常识约束遵循程度的标准化评测体系。该数据集通过引入包含前景一致性、背景一致性、隐含物理逻辑规则等多维度标注结构,使得研究者能够系统诊断模型在时间推理、因果推理和空间推理方面的缺陷。这种精细化的评估机制不仅揭示了当前模型在理解动态场景规则上的局限,更为量化不同技术路线的推理能力差异提供了可靠工具,从而推动了视频生成领域从基于统计的模式匹配向基于规则理解的认知建模方向转型。
实际应用
在实际应用层面,VWG-Bench为视频内容创作、智能监控和自动化决策支持系统提供了关键的评估基础设施。例如在影视制作中,该基准可辅助筛选能够准确执行导演分镜头脚本中物理约束(如物体碰撞规则、时空连贯性)的视频生成模型;在自动驾驶仿真领域,其进度目标与最终帧目标的评估机制可用于验证场景模拟器是否精确再现了交通规则约束下的车辆行为。此外,该数据集对于虚拟现实环境构建、机器人任务规划视频模拟等需要严格遵循物理和逻辑规则的应用场景,提供了验证生成内容合理性与可靠性的标准化测试方案。
数据集最近研究
最新研究方向
VWG-Bench作为首个系统化评估视频生成模型符号推理与物理常识遵循能力的基准,正推动视频生成领域从单纯关注视觉质量向高阶认知能力验证转型。该基准涵盖9个推理维度与38个任务组,通过显式规则(前景/背景约束)与隐式约束(物理常识、逻辑一致性)的双重评估框架,直击当前视频生成模型在长程目标达成、因果链条理解等方面的核心短板。其评测指标不仅包括传统的视频质量评分,更独创性地引入进度一致性、隐式规则遵守度与最终帧目标达成度,为生成式AI从“感知生成”迈向“认知推理”提供了可量化的关键标尺,尤其对具身智能、自动驾驶等需要长期时序规划能力的应用场景具有里程碑式的理论指导意义。
以上内容由遇见数据集搜集并总结生成


