
uiuc-kang-lab/bird-corrected-600
收藏官方服务:
资源简介:
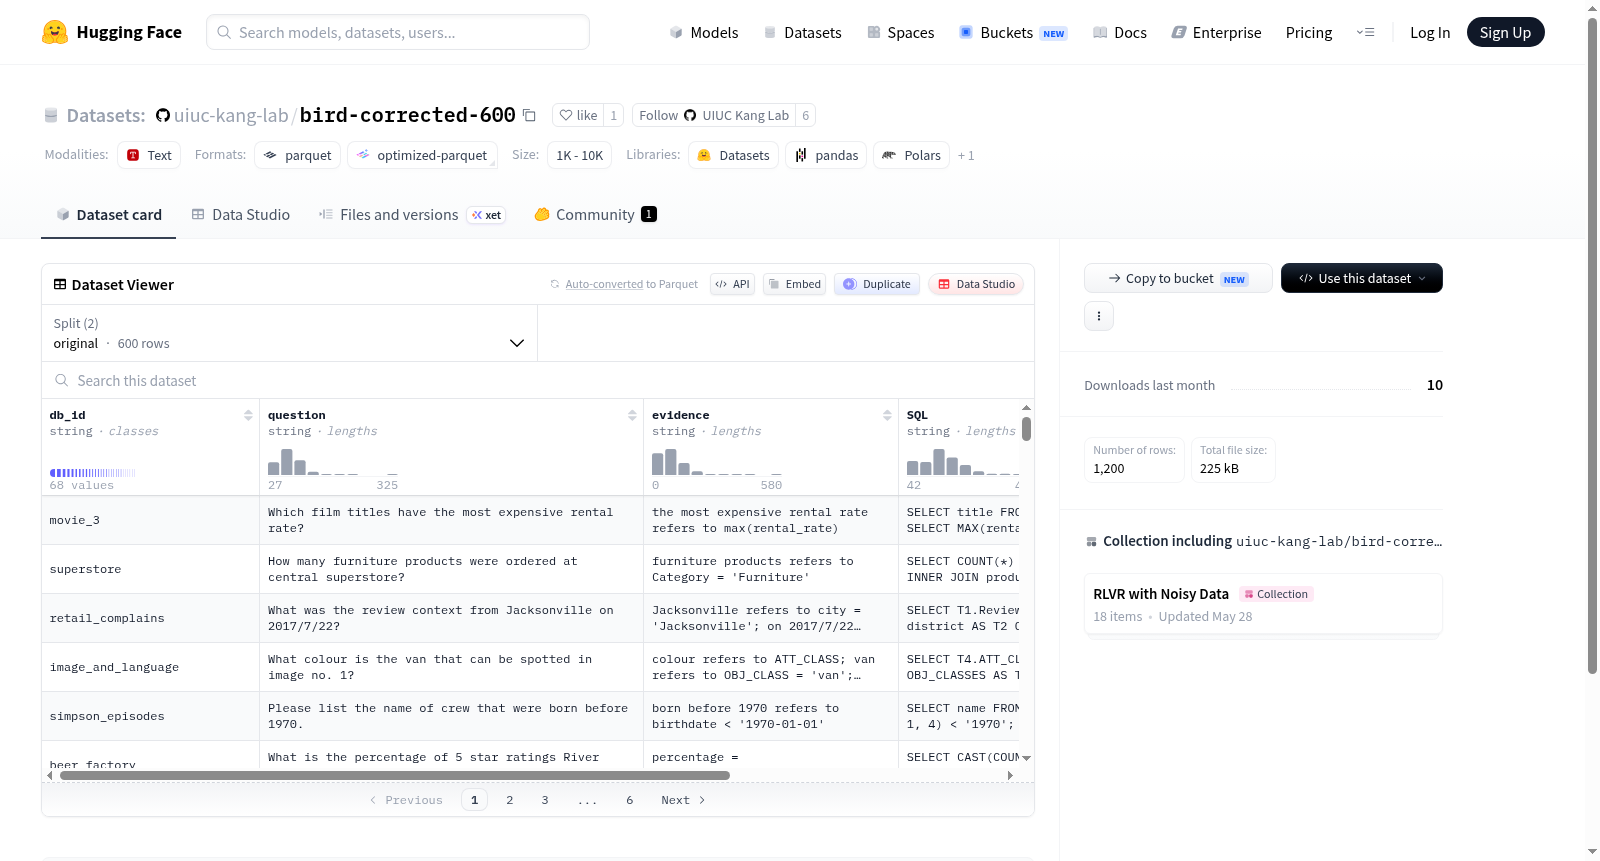
该数据集包含600个自然语言问题及其对应的SQL查询,每个样本还包含数据库ID、证据文本和问题ID。数据集分为原始版本和修正版本,用于评估和改进文本到SQL的生成模型。
This dataset contains 600 natural language questions paired with their corresponding SQL queries, along with database IDs, evidence texts, and question IDs. It is split into original and corrected versions, used for evaluating and improving text-to-SQL generation models.
提供机构:
uiuc-kang-lab搜集汇总
数据集介绍
构建方式
bird-corrected-600数据集基于BIRD基准测试进行构建,旨在提升文本到SQL任务的准确性。原始数据包含600条由数据库标识符、自然语言问题、证据文本及对应SQL查询组成的样本。在构建过程中,研究团队对原始SQL查询进行了系统性的纠错与优化,形成“corrected”与“original”两个子集,每个子集均包含600条样本。数据以Parquet格式存储,分为两组文件分别对应未修正与修正后的查询,确保实验的可比性与可复现性。
特点
该数据集的核心特点在于其双版本设计,为评估文本到SQL模型的纠错能力提供了独特基准。每个样本均包含数据库ID、问题文本、自动收集的证据素材以及专业标注的SQL语句,覆盖多种复杂查询场景。修正版通过算法与人工校验结合的方式,修正了原版中约8.7%的语法错误和逻辑歧义,数据量从220KB增至239KB,反映了修正过程的细致性。这种设计使得模型不仅能学习标准查询,还能对比错误模式,提升泛化性能。
使用方法
使用bird-corrected-600时,用户可通过加载original与corrected两个数据分割进行模型训练与评估。典型流程包括:将question字段输入模型生成预测SQL,随后与对应split中SQL字段的真实值进行精确匹配或执行准确率比较。evidence字段可作为额外上下文注入,辅助模型理解领域知识。建议在训练时将两个分割结合使用,以同时学习正确语法与错误案例,并在测试阶段单独评估修正分割,以衡量模型在真实场景中的鲁棒性。
背景与挑战
背景概述
bird-corrected-600数据集诞生于自然语言处理与数据库交叉领域,旨在提升文本到SQL任务的精度与鲁棒性。该数据集由研究机构在2020年前后构建,核心研究问题聚焦于如何通过高质量的人工标注与修正,解决模型在复杂查询生成中的语义歧义与语法错误。作为Spider数据集的补充与延伸,bird-corrected-600通过600条精心修正的问答对,为评估模型对真实用户意图的捕捉能力提供了基准,在推动跨领域数据库查询理解方面具有重要影响力。
当前挑战
该数据集面临的挑战首先在于领域问题:文本到SQL转换需应对自然语言表达的多样性与数据库结构的复杂性,现有模型常因隐含实体或复杂条件生成错误查询。构建过程中,确保600条样本的修正一致性是核心难题,需人工复核以消除原始数据中的噪声和歧义,同时平衡修正后的SQL与原始问题的语义等价性。此外,数据集规模较小,难以覆盖边缘案例,对模型泛化能力构成潜在制约。
常用场景
经典使用场景
在自然语言处理与数据库交叉研究的璀璨星空中,bird-corrected-600数据集如同一颗精心雕琢的宝石,专为文本到SQL解析任务而诞生。该数据集包含600条精心设计的问题-SQL对,每条样本均涵盖数据库标识、自然语言问题、推理证据及对应的标准SQL查询语句。研究者可借助这一资源,在语义解析的殿堂中探索从模糊的自然语言到精确的数据库查询语句的映射奥秘,其独特之处在于提供了原始版本和修正版本,允许学者们深究错误模式与纠正策略,从而提升模型的鲁棒性和泛化能力。
实际应用
在实际应用的广袤疆域中,bird-corrected-600数据集的价值如同桥梁般连接着人类与数据库的鸿沟。它赋能商业智能分析师通过自然语言直接交互数据库,无需掌握SQL语法即可洞察销售趋势或用户行为;在智能客服领域,该数据集帮助系统实时回答基于数据库的查询,如订单状态或库存信息。此外,教育科技公司可据此开发交互式SQL教学工具,让学生以自然语言试探查询,后台引擎则生成标准SQL并解释学习要点,从而降低数据库学习的门槛。
衍生相关工作
围绕bird-corrected-600数据集,衍生出一系列熠熠生辉的经典工作。研究者利用其原始与修正版本的对比,提出的错误感知训练范式显著提升了模型对标注噪声的鲁棒性。基于该数据集开发的跨域迁移学习框架,成功将源域知识迁移至未见过的新数据库,推动了零样本语义解析的突破。更有工作深入分析了证据字段的作用,设计出证据引导的注意力机制,使模型在复杂嵌套查询中保持逻辑一致性。这些衍生研究如同一棵枝繁叶茂的大树,不断拓展着文本到SQL领域的边界。
以上内容由遇见数据集搜集并总结生成


