
遇见数据集

thesaurus-linguae-aegyptiae/tla-demotic-v18-premium

收藏
Hugging Face2024-05-26 更新2024-03-04 收录
官方服务:

资源简介:

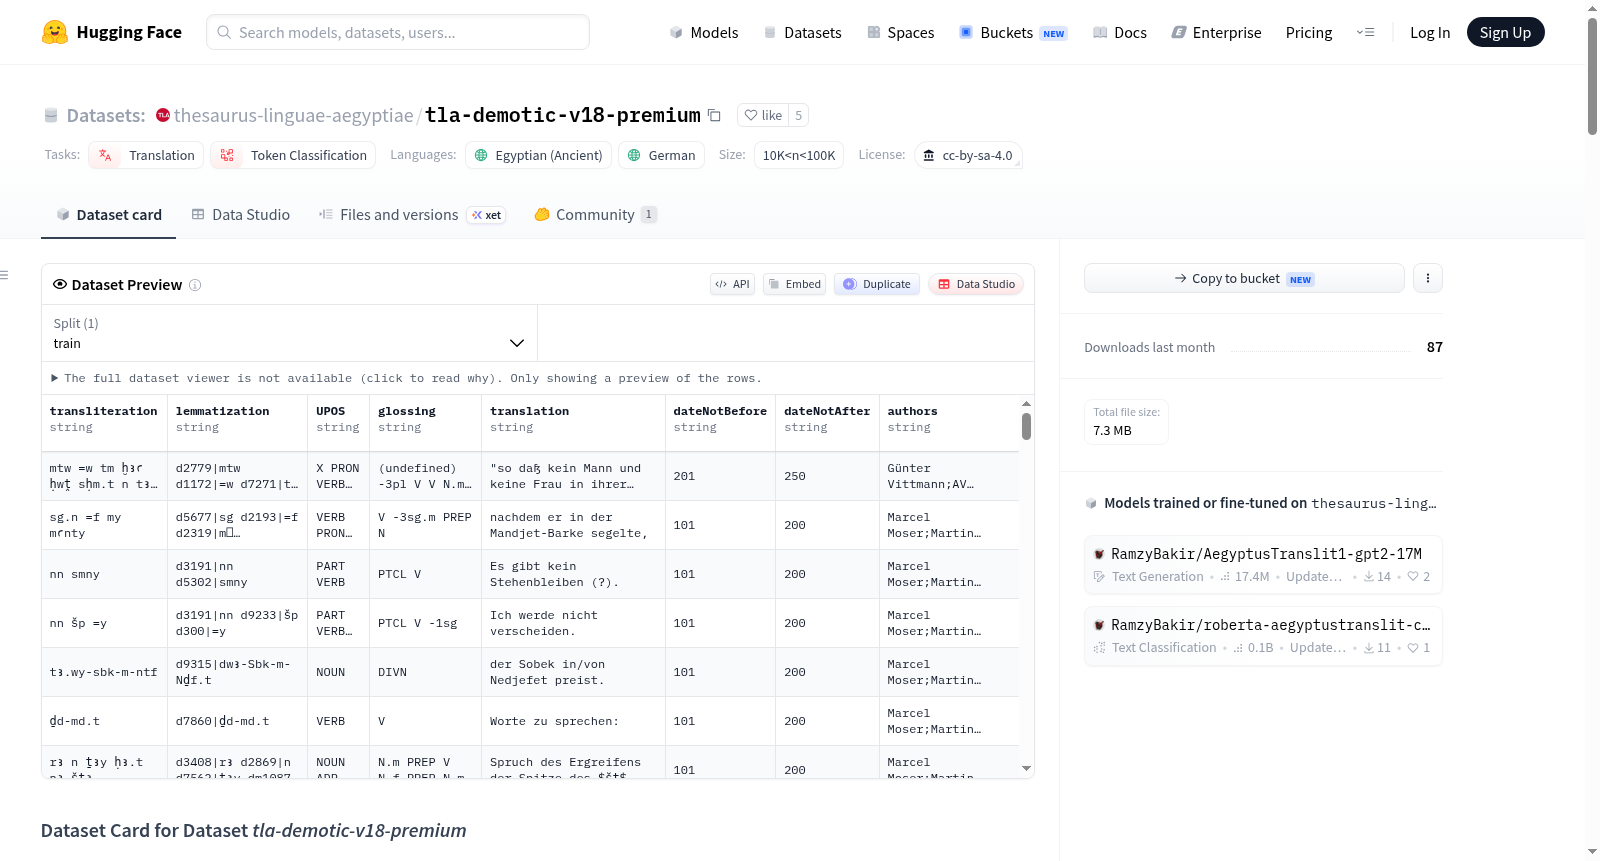
该数据集包含古埃及语(Demotic)句子的转写、词形还原、词性标注、注释和德语翻译。数据来源于Thesaurus Linguae Aegyptiae数据库的第18版语料库,仅包含完整且明确可读的句子(13,383条句子)。数据集适用于训练翻译模型和词形还原器,但不适用于重建古代源文本。

该数据集包含古埃及语(Demotic)句子的转写、词形还原、词性标注、注释和德语翻译。数据来源于Thesaurus Linguae Aegyptiae数据库的第18版语料库,仅包含完整且明确可读的句子(13,383条句子)。数据集适用于训练翻译模型和词形还原器,但不适用于重建古代源文本。

原始信息汇总

数据集概述

数据集描述

  • 名称: Thesaurus Linguae Aegyptiae, Demotic sentences, corpus v18, premium
  • 标注创建者: 专家生成
  • 许可: CC BY-SA 4.0
  • 任务类别: 翻译、词性标注
  • 语言: 埃及语(egy)、德语(de)
  • 多语言性: 多语言
  • 大小类别: 10K<n<100K

数据集结构

特征

  • transliteration: 字符串,埃及语转写
  • lemmatization: 字符串,词形还原
  • UPOS: 字符串,通用词性标签
  • glossing: 字符串,词义标注
  • translation: 字符串,德语翻译
  • dateNotBefore: 字符串,文本见证的最早日期
  • dateNotAfter: 字符串,文本见证的最晚日期
  • authors: 字符串,主要作者和贡献者

数据分割

  • 训练集: 13383个样本

数据实例

json { "transliteration": "ꞽy ꞽh pr =k", "lemmatization": "d338|ꞽy d4158|ḥr d1985|pr d6496|=k", "UPOS": "VERB ADP NOUN PRON", "glossing": "V PREP N.m -2sg.m", "translation": "Komm in dein Haus!", "dateNotBefore": "-75", "dateNotAfter": "-51", "authors": "Günter Vittmann;AV Altägyptisches Wörterbuch, AV Wortschatz der ägyptischen Sprache" }

数据集创建

筛选理由

该数据集仅包含完整、无争议、完全词形还原的句子,以满足机器学习项目对原始数据的需求。

源数据

数据集包含来自TLA语料库v18(2023)的所有埃及语句子,这些句子满足以下条件:

  • 无破坏
  • 无可疑读音
  • 完全词形还原
  • 有德语翻译

标注过程

转写中有时包含圆括号(( )),表示编辑添加的音素,这些括号及其内容在模型训练时可选择性移除。

标注者

Joachim Friedrich Quack, Marcel Moser, Simon D. Schweitzer, Martin Stadler, Günter Vittmann, Daniel A. Werning

偏差、风险和限制

该数据集并非精心平衡的数据集,词形还原通过词形ID进行,因为词形转写中包含许多因埃及语无音素特性而产生的同音字。
搜集汇总
数据集介绍
thesaurus-linguae-aegyptiae/tla-demotic-v18-premium 数据集图片
构建方式
该数据集源自《埃及语言宝库》(Thesaurus Linguae Aegyptiae)第18版语料库,聚焦于世俗体埃及语(Demotic)的完整句子。构建过程中,研究团队从原始数据库中筛选出31,156条句子,严格剔除了存在残缺、可疑释读或未完全词条化的条目,最终保留13,383条结构完整、语义明确的句子。每条数据均经过专家标注,包含转写(transliteration)、词条化(lemmatization)、词性标注(UPOS)、注释(glossing)及德语翻译(translation),同时附有文本的时间范围(terminus ante quem non与terminus post quem non)和作者信息。数据集以JSON Lines格式存储,未预设划分,用户可根据需要自行生成随机训练集。
特点
该数据集的核心特色在于其高纯净度与专家级标注质量。所有句子均无破坏痕迹、无疑问释读,且已完全词条化并配有德语翻译,确保了数据的可靠性与可用性。转写遵循莱顿统一转写系统(Leiden Unified Transliteration),词性标注采用通用词性标签集(Universal POS tag set),词条化则通过稳定的TLA词条ID进行,有效规避了世俗体文字因缺乏元音而产生的同形异义问题。此外,注释字段对应词条的基本形态而非句中的屈折形式,为自然语言处理任务提供了清晰的语言学基础。数据集虽未刻意平衡,但覆盖了广泛的历史时期,从公元前75年至公元前51年不等,体现了其时间维度的多样性。
使用方法
该数据集适用于两项主要任务:一是构建世俗体转写至TLA词条ID的词条化工具(lemmatizer),二是训练世俗体转写至德语的翻译模型。使用时,用户可直接加载JSON Lines文件,提取各字段进行模型训练。由于数据集未预设划分,建议用户自行创建随机训练集、验证集和测试集。需注意,转写字段中可能包含圆括号标记的编辑添加音素,这些括号在模型训练中可选择性移除,但括号内的内容应保留。此外,数据集不适用于重构完整的古代原始文本,因其仅包含筛选后的完整句子。用户应参考官方文档中的引用建议,遵循CC BY-SA 4.0国际许可协议进行署名。
背景与挑战
背景概述
古埃及语作为人类文明的珍贵遗产,其研究长期受限于文本的稀缺性与解读的复杂性。在此背景下,由柏林-勃兰登堡科学院与萨克森科学院联合主导的“古埃及语词汇结构与转型”项目,于2023年推出了TLA世俗体语料库v18版,并从中精选出13,383条完整、无歧义且经过完全词素标注的句子,构建了名为thesaurus-linguae-aegyptiae/tla-demotic-v18-premium的数据集。该数据集由Daniel A. Werning担任执行编辑,旨在为计算语言学与埃及学交叉领域提供标准化资源,涵盖转写、词条ID、词性标注、注释及德语翻译等结构化信息,其发布标志着数字化方法在古典语文学中的深度应用,对推动低资源语言的机器翻译与词性标注研究具有里程碑意义。
当前挑战
该数据集所面临的挑战首先体现在领域问题的特殊性上:世俗体文字作为古埃及语晚期书写形式,其转写系统(如莱顿统一转写)需处理大量辅音同形词,加之元音缺失引发的词义模糊性,使得自动化词条消歧与精准翻译成为难题。其次,构建过程中遭遇了严苛的史料筛选困境——原始文本充斥语文学标记、残缺与存疑内容,需人工逐一剔除31,156条句子中的非完整实例,仅保留13,383条可信数据;同时,词素标注需依赖专家团队跨多年协作,由Günter Vittmann等学者完成转写、词条化与年代判定,而UPOS映射与注释计算则需额外算法适配,数据平衡性的缺失进一步限制了模型的泛化能力。
常用场景
经典使用场景
在古埃及语计算语言学领域,该数据集为构建从世俗体转写(transliteration)到德语翻译的神经机器翻译模型提供了高质量的平行语料。其核心价值在于收录了13383条经过严格筛选的完整、无歧义句子,每条样本均包含词素分析、词性标注(UPOS)和语法注释(glossing),为端到端的序列到序列学习任务奠定了数据基础。研究者可基于此训练面向低资源语种的翻译系统,或利用其丰富的语言学标注信息开展跨语言词性标注与句法分析实验。
衍生相关工作
基于该数据集,研究者已衍生出多个经典工作方向。其一,利用其词素ID与通用词性标签,开发面向世俗体转写的序列标注模型,实现自动词性标注与词干还原;其二,以其为种子语料,结合迁移学习方法拓展至同一语系的其他阶段(如僧侣体、圣书体)的跨时期文本处理;其三,基于其严格的筛选标准,构建了评估古埃及语机器翻译质量的基准测试集,推动了低资源语种NLP评估体系的发展。
数据集最近研究
最新研究方向
在古埃及学与自然语言处理的交叉领域,thesaurus-linguae-aegyptiae/tla-demotic-v18-premium数据集为埃及世俗体(Demotic)文本的数字化解析开辟了全新路径。该数据集精选了来自《埃及语言宝库》(Thesaurus Linguae Aegyptiae)第18版语料库中13,383条完整无误的世俗语句子,每一条都配备了转写、词位标注、词性标注(UPOS)、德语翻译以及精确的年代信息。当前前沿研究聚焦于利用这些高质量标注数据训练专门针对世俗体转写的词位分析器和德文翻译模型,从而突破以往因语料残缺、标记杂乱而难以进行机器学习的瓶颈。这一工作不仅推动了濒危古文字资源的智能化处理,更与数字人文学科中“语言知识图谱构建”的热点事件紧密呼应,为破译埃及晚期文献、还原跨文化语境下的语义演变提供了可靠的数据基石,其深远意义在于让尘封数千年的文明密码得以被计算语言学家高效解读。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

