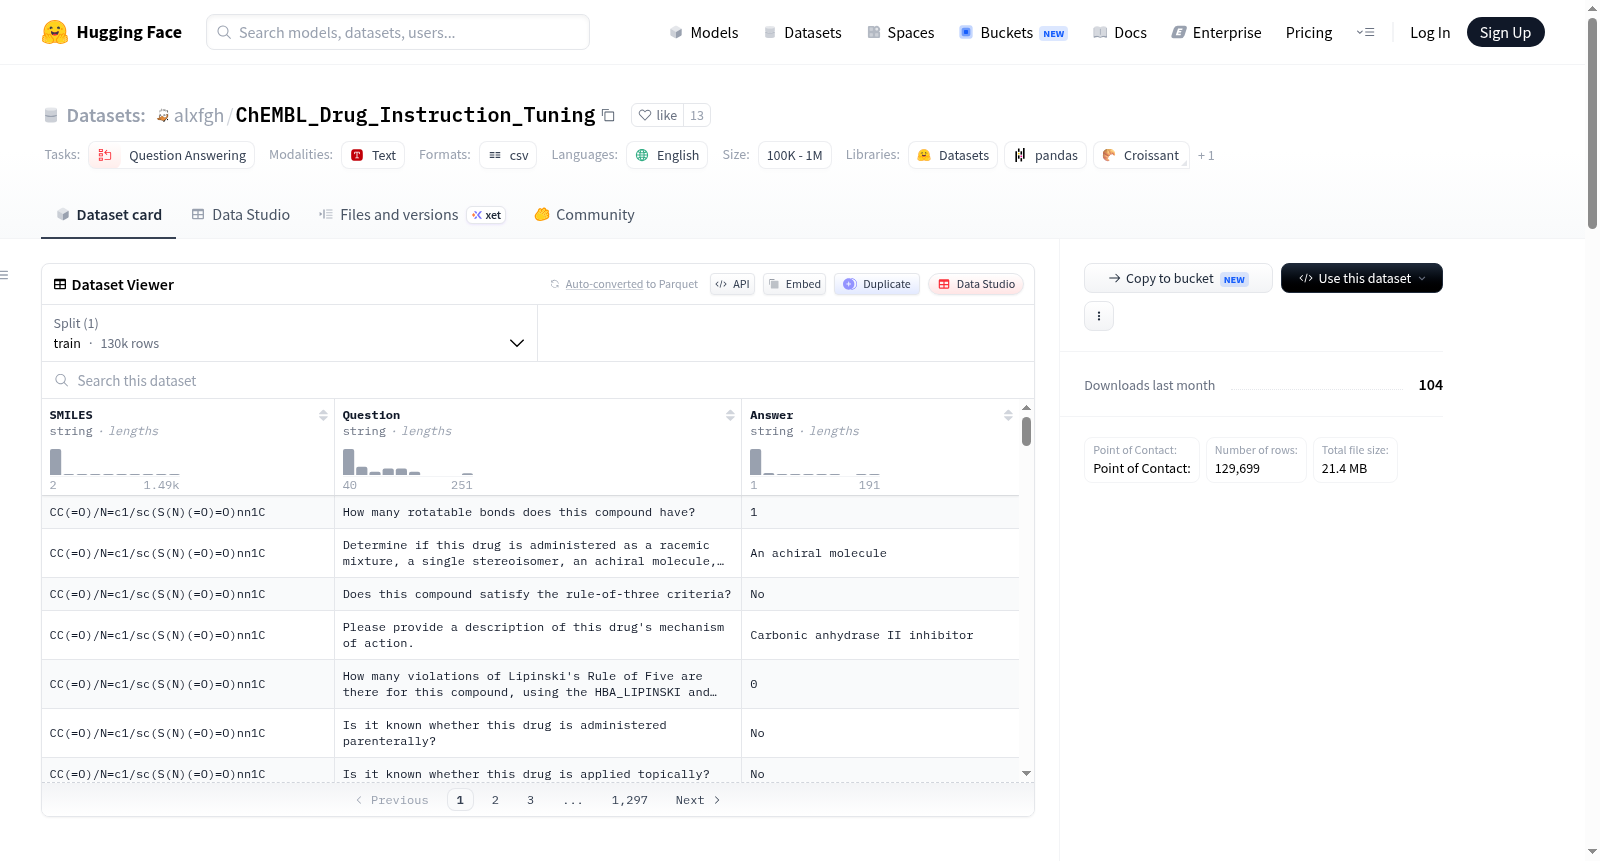
alxfgh/ChEMBL_Drug_Instruction_Tuning
收藏资源简介:
--- task_categories: - question-answering language: - en pretty_name: ChEMBL Drug Instruction Tuning --- # Dataset Card for ChEMBL Drug Instruction Tuning ## Dataset Description - **Homepage:** - **Repository:** - **Paper:** - **Leaderboard:** - **Point of Contact:** ### Dataset Summary This dataset card aims to be a base template for new datasets. It has been generated using [this raw template](https://github.com/huggingface/huggingface_hub/blob/main/src/huggingface_hub/templates/datasetcard_template.md?plain=1). ### Supported Tasks and Leaderboards [More Information Needed] ### Languages [More Information Needed] ## Dataset Structure ### Data Instances [More Information Needed] ### Data Fields [More Information Needed] ### Data Splits [More Information Needed] ## Dataset Creation ### Curation Rationale [More Information Needed] ### Source Data #### Initial Data Collection and Normalization [More Information Needed] #### Who are the source language producers? [More Information Needed] ### Annotations #### Annotation process [More Information Needed] #### Who are the annotators? [More Information Needed] ### Personal and Sensitive Information [More Information Needed] ## Considerations for Using the Data ### Social Impact of Dataset [More Information Needed] ### Discussion of Biases [More Information Needed] ### Other Known Limitations [More Information Needed] ## Additional Information ### Dataset Curators [More Information Needed] ### Licensing Information [More Information Needed] ### Citation Information [More Information Needed] ### Contributions [More Information Needed]
--- task_categories: - 问答任务 language: - 英语 pretty_name: ChEMBL药物指令微调(ChEMBL Drug Instruction Tuning) --- # ChEMBL药物指令微调数据集卡片 ## 数据集描述 - **主页:** - **代码仓库:** - **相关论文:** - **排行榜:** - **联系人:** ### 数据集概述 本数据集卡片旨在作为新建数据集的基础模板,其通过[此原始模板](https://github.com/huggingface/huggingface_hub/blob/main/src/huggingface_hub/templates/datasetcard_template.md?plain=1)生成。 ### 支持任务与排行榜 [More Information Needed] ### 语言 [More Information Needed] ## 数据集结构 ### 数据实例 [More Information Needed] ### 数据字段 [More Information Needed] ### 数据划分 [More Information Needed] ## 数据集构建 ### 遴选依据 [More Information Needed] ### 源数据 #### 初始数据收集与标准化处理 [More Information Needed] #### 源语言生成者为何人? [More Information Needed] ### 标注信息 #### 标注流程 [More Information Needed] #### 标注者为何人? [More Information Needed] ### 个人与敏感信息 [More Information Needed] ## 数据集使用注意事项 ### 数据集的社会影响 [More Information Needed] ### 偏差讨论 [More Information Needed] ### 其他已知局限性 [More Information Needed] ## 附加信息 ### 数据集整理者 [More Information Needed] ### 许可信息 [More Information Needed] ### 引用信息 [More Information Needed] ### 贡献内容 [More Information Needed]
数据集概述
基本信息
- 任务类别: 问答(question-answering)
- 语言: 英语(en)
- 数据集名称: ChEMBL Drug Instruction Tuning
数据集描述
- 数据集概要: 本数据集卡片旨在作为新数据集的基础模板,使用此原始模板生成。
数据集结构
- 数据实例: 信息待补充
- 数据字段: 信息待补充
- 数据分割: 信息待补充
数据集创建
- 筛选理由: 信息待补充
- 源数据:
- 初始数据收集与标准化: 信息待补充
- 源语言生产者: 信息待补充
- 注释:
- 注释过程: 信息待补充
- 注释者: 信息待补充
- 个人和敏感信息: 信息待补充
使用数据时的考虑
- 数据集的社会影响: 信息待补充
- 讨论偏见: 信息待补充
- 其他已知限制: 信息待补充
附加信息
- 数据集管理者: 信息待补充
- 许可信息: 信息待补充
- 引用信息: 信息待补充
- 贡献: 信息待补充