
遇见数据集

cjvt/Nemotron-Pretraining-SFT_translated

收藏
Hugging Face2026-07-21 更新2026-07-22 收录
官方服务:

资源简介:

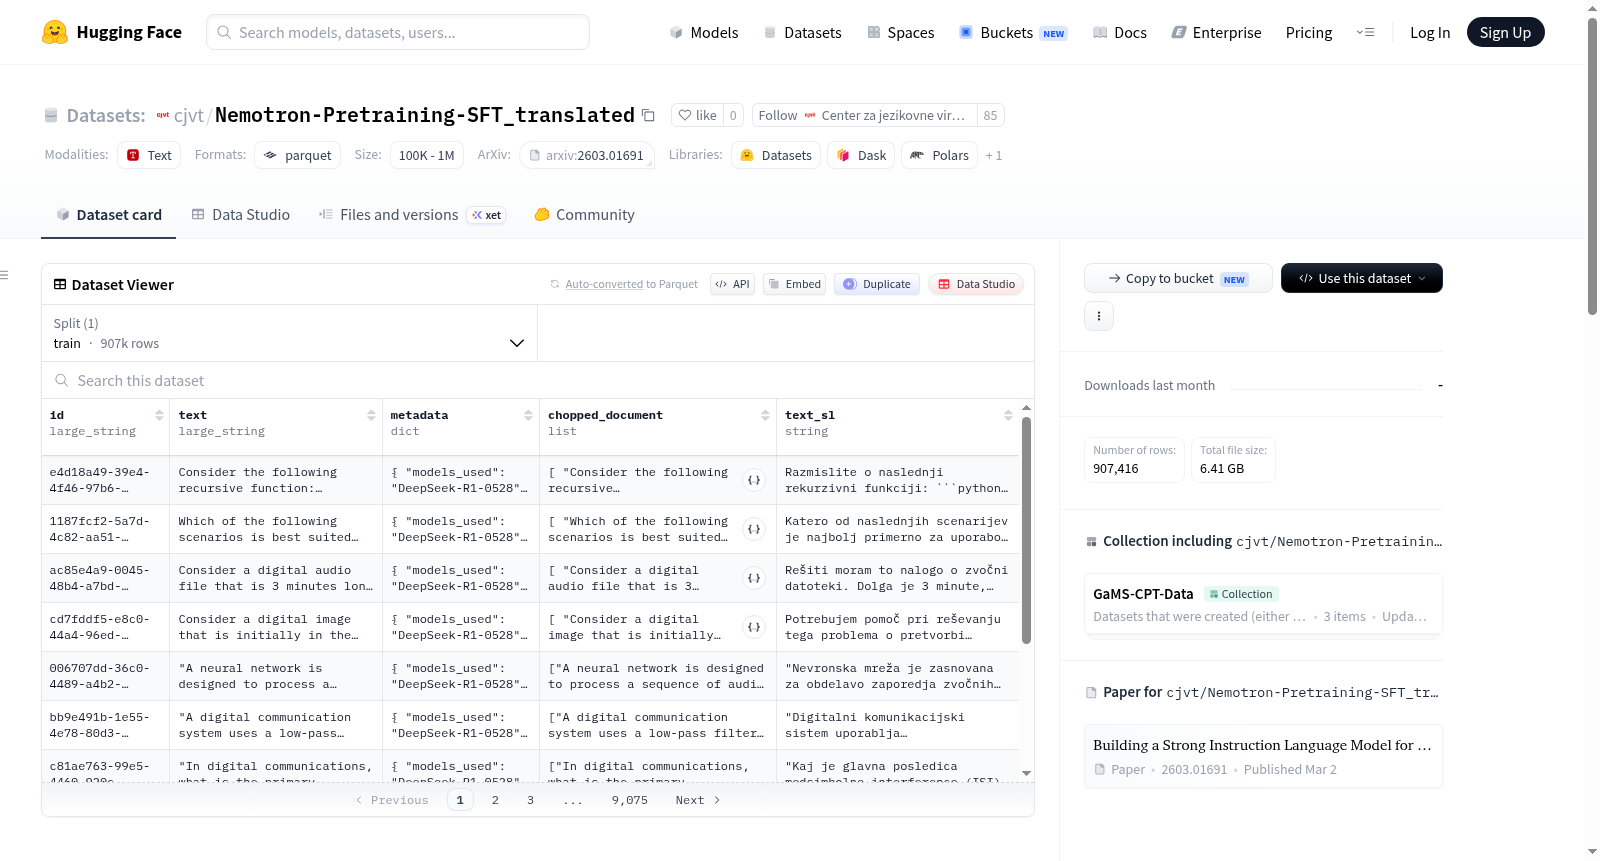
该数据集是Nemotron Pretraining SFT数据的斯洛文尼亚语翻译版本,源数据集来自nvidia/Nemotron-Pretraining-SFT-v1,是Nemotron-SFT-General子集的子样本。它包含90万份文档,翻译文档约含8.89亿斯洛文尼亚语单词。数据集结构包括以下字段:id(从原始数据集保留的标识符)、text(原始英文文本示例)、metadata(从原始数据集保留的元数据)、chopped_document(为适应GaMS-DPO-Translator模型上下文窗口而切分的较小文本单元列表)和text_sl(英文示例的斯洛文尼亚语翻译)。翻译工作使用cjvt/GaMS-DPO-Translator模型完成,旨在支持斯洛文尼亚语的自然语言处理任务。

This is a Slovene translation of the Nemotron Pretraining SFT data. The source dataset was taken from nvidia/Nemotron-Pretraining-SFT-v1. It is a subsample of the Nemotron-SFT-General subset. The dataset contains 900k documents, with translated documents containing around 889 million Slovene words. Dataset fields include: id (kept from the original dataset), text (original English example), metadata (kept from the original dataset), chopped_document (the list of smaller text units that fit into the context window of GaMS-DPO-Translator), and text_sl (Slovene translation of the English example). The translation was performed using the cjvt/GaMS-DPO-Translator model.
提供机构:
cjvt
搜集汇总
数据集介绍
cjvt/Nemotron-Pretraining-SFT_translated 数据集图片
构建方式
Nemotron-Pretraining-SFT_translated 数据集是基于 NVIDIA 发布的原始英文数据集 Nemotron-Pretraining-SFT-v1 进行翻译构建而成。原始数据取自其 Nemotron-SFT-General 子集,涵盖约 90 万条英文指令调优样本。为实现斯洛文尼亚语适配,研究团队采用 cjvt/GaMS-DPO-Translator 翻译模型对每条样本进行翻译处理。翻译过程中,先将超出模型上下文窗口的长文档分割为较小的文本单元(chopped_document),确保翻译质量与完整性,最终生成包含原始英文与对应斯洛文尼亚语翻译的对齐数据,并以 JSON 格式存储,保留了原始数据中的 id 与 metadata 信息。
特点
该数据集最显著的特点是针对性服务于低资源语言——斯洛文尼亚语的指令调优任务,填补了该语言在大规模监督微调数据领域的空白。数据规模庞大,包含约 90 万条文档,翻译后斯洛文尼亚语词汇量高达 8.89 亿,为模型提供了丰富的语义与句法多样性。此外,数据集保留了原始英文文本与翻译文本的双语对齐结构,支持跨语言研究与模型评估。数据集采用 CC BY 4.0 许可协议发布,确保了学术与商业场景下的灵活使用。
使用方法
使用者可通过 Hugging Face Datasets 库直接加载该数据集,指定配置名为 'default' 的 train 分片即可获取全部数据。数据集中包含五个字段:id 用于跟踪原始样本、text 提供英文原文、metadata 记录模型与类别信息、chopped_document 展示翻译时的分块结果、text_sl 提供斯洛文尼亚语翻译文本。典型的应用场景包括使用 text_sl 字段对预训练语言模型进行斯洛文尼亚语指令微调,或利用 text 与 text_sl 的对齐关系进行跨语言对比学习与评估。
背景与挑战
背景概述
随着大语言模型在多语言场景下的广泛应用,高质量的非英语训练数据成为构建稳健模型的关键瓶颈。Nemotron-Pretraining-SFT_translated数据集于2026年由斯洛文尼亚研究人员Domen Vreš及其团队在PoVeJMo研究计划框架下创建,隶属于SloLLaMai项目,旨在解决斯洛文尼亚语等低资源语言在指令微调阶段的数据匮乏问题。该数据集基于NVIDIA发布的Nemotron-Pretraining-SFT-v1英文子集,通过机器翻译模型GaMS-DPO-Translator完成900k条样本的斯洛文尼亚语转换,包含约8.89亿词,由卢布尔雅那大学等机构联合推动,受斯洛文尼亚研究与创新局及NextGenerationEU资助。其发布显著推动了低资源语言NLP研究,特别是为斯洛文尼亚语的指令跟随模型训练提供了基础数据资源。
当前挑战
该数据集的核心挑战首先在于解决低资源语言指令微调的数据稀缺难题——斯洛文尼亚语缺乏大规模、高质量的监督微调数据集,导致模型难以在该语言上准确理解用户意图并生成符合语境的响应。其次,构建过程中机器翻译的质量控制成为关键障碍:自动翻译可能引入语义偏差、术语不匹配或语法错误,尤其面对包含多轮对话或领域术语的复杂文本时,翻译模型需在有限的上下文窗口中保持一致性。此外,原始English样本的文化特定表达(如习语)难以直接映射至斯洛文尼亚语境,需借助人工后处理或混合策略缓解生成文本的泛化能力受限问题。
常用场景
经典使用场景
Nemotron-Pretraining-SFT_translated 数据集的核心价值在于为斯洛文尼亚语这一资源匮乏的语言提供大规模、高质量的指令微调数据。该数据集源自 NVIDIA 发布的 Nemotron-Pretraining-SFT-v1 英文语料,经由先进的神经机器翻译模型 GaMS-DPO-Translator 精准翻译而成,包含约 90 万条文档,总词量近 8.9 亿。其经典使用场景聚焦于斯洛文尼亚语大型语言模型的监督式微调,研究者可借助其中的指令-响应配对样本,赋予模型遵循自然语言指令的能力,从而在语义理解、任务执行与对话生成等维度显著提升模型在低资源语言上的表现。
实际应用
在实际应用层面,该数据集直接服务于面向斯洛文尼亚语用户的人工智能产品开发。例如,基于此数据微调的语言模型可被集成到智能客服系统中,以母语级别自然度处理用户查询;或在教育领域辅助生成斯洛文尼亚语的个性化学习材料与自动习题解答。同时,该数据集也为自动化文档摘要、法律文本分析及新闻报道生成等专业场景提供了坚实的语言基底,助力相关企业在斯洛文尼亚市场部署具备本土化语言理解能力的智能体,显著降低跨语言部署的技术门槛。
衍生相关工作
围绕 Nemotron-Pretraining-SFT_translated 数据集,已衍生出多项具有启发性的研究工作。其中,Vreš 等人(2026)发表的论文《Building a Strong Instruction Language Model for a Less-Resourced Language》直接依托该数据集,系统论证了在斯洛文尼亚语场景下,经过高质量翻译数据微调后的模型在指令遵循与任务完成度上可媲美英语基线。此外,该数据集还催生了关于跨语言对齐训练、低资源语言数据增强策略以及翻译后语料噪声对模型鲁棒性影响的分析,成为 PoVeJMo 研究计划中探索自适应大语言模型的关键基石。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

