py-bug-trace-laguna-xs-2-l3-rollouts
收藏资源简介:
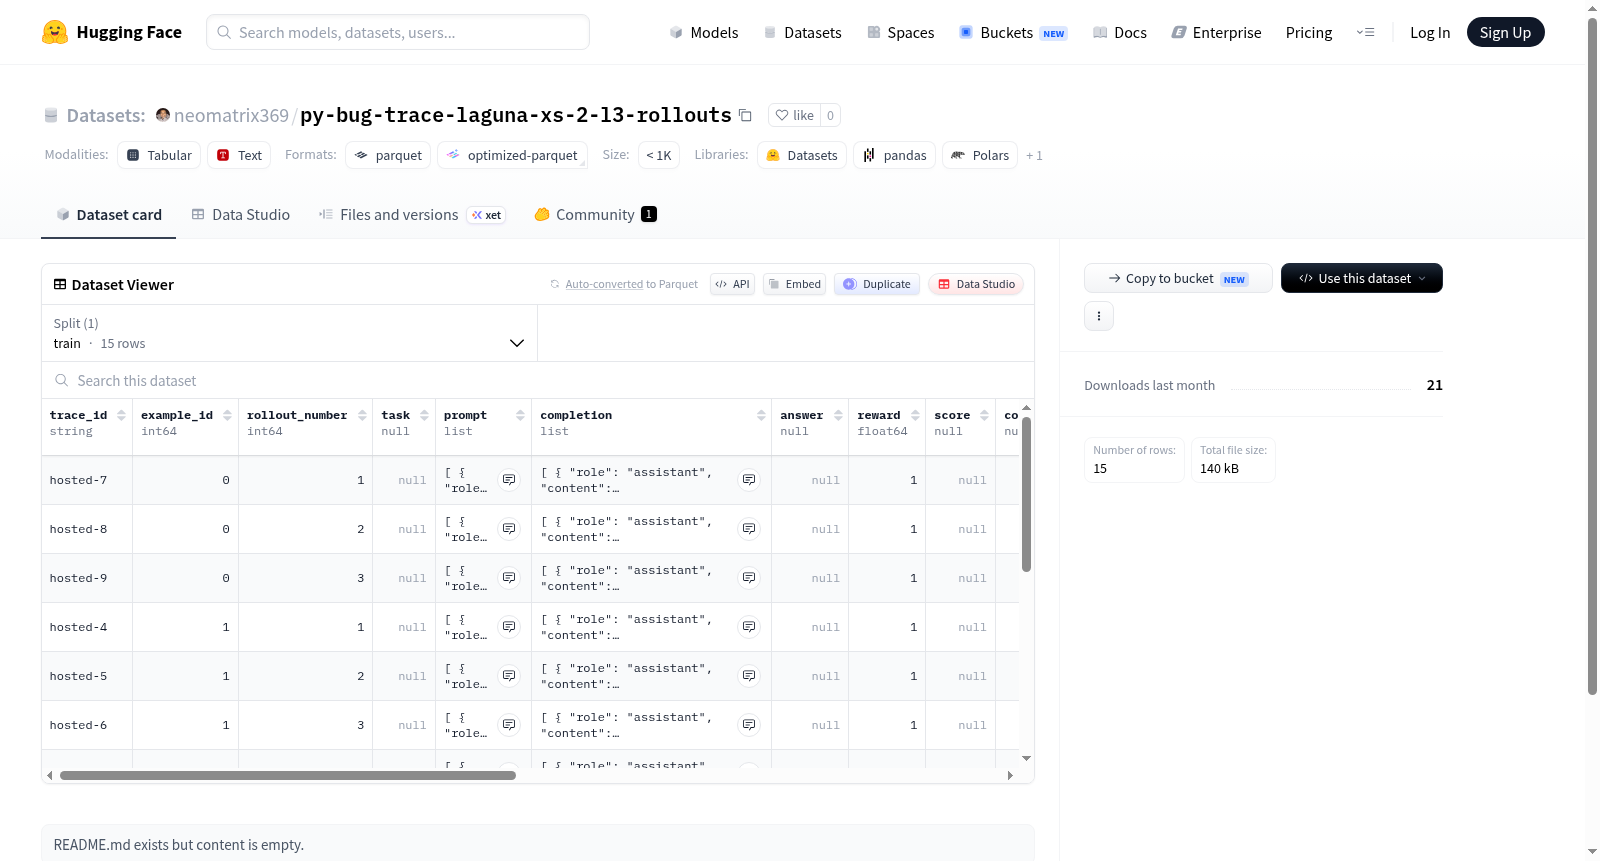
该数据集包含了一系列用于评估和训练代码生成AI模型的交互轨迹数据。每个数据样本代表一次完整的模型任务执行过程,其中包含用户提示(prompt)、模型的多轮响应(completion)以及相应的评估结果。数据以结构化格式存储,核心字段包括:唯一轨迹标识(trace_id)、提示消息列表(包含角色和内容)、模型完成消息列表(额外包含推理内容 reasoning_content)、任务奖励(reward, pytest_reward)以及详细的性能元数据(info)。元数据信息丰富,涵盖了任务难度(difficulty)、类别(category)、测试代码(test_code)、精确的时间消耗统计(timing)和令牌使用情况(token_usage)。数据集规模较小,包含15个训练样本,适用于代码生成模型的强化学习训练、性能基准测试、智能体行为分析以及包含推理链的模型评估等研究场景。
This dataset contains a series of interaction trajectory data for evaluating and training code generation AI models. Each data sample represents a complete model task execution process, including user prompts, multi-turn model responses (completions), and corresponding evaluation results. The data is stored in a structured format, with core fields including: unique trace identifier (trace_id), prompt message list (with roles and content), model completion message list (additionally containing reasoning_content), task rewards (reward, pytest_reward), and detailed performance metadata (info). The metadata is rich, covering task difficulty, category, test code, precise timing statistics, and token usage. The dataset is small in scale, containing 15 training samples, and is suitable for research scenarios such as reinforcement learning training for code generation models, performance benchmarking, agent behavior analysis, and model evaluation with chain-of-thought reasoning.
数据集概述
数据集名称:py-bug-trace-laguna-xs-2-l3-rollouts
数据集链接:https://huggingface.co/datasets/neomatrix369/py-bug-trace-laguna-xs-2-l3-rollouts
数据集规模
- 总下载大小:133,812 字节
- 数据集大小:97,341 字节
- 数据划分:仅包含训练集(train),共 15 个样本
特征字段
每条数据包含以下字段:
| 字段名 | 类型 | 说明 |
|---|---|---|
| trace_id | string | 追踪ID |
| example_id | int64 | 示例ID |
| rollout_number | int64 | 回滚编号 |
| task | null | 任务(空) |
| prompt | list | 提示信息,包含 role、content、tool_calls、tool_call_id |
| completion | list | 完成结果,包含 role、content、reasoning_content、tool_calls、tool_call_id |
| answer | null | 答案(空) |
| reward | float64 | 奖励值 |
| score | null | 分数(空) |
| correct | null | 是否正确(空) |
| num_steps | null | 步数(空) |
| total_time | float64 | 总耗时 |
| latency_ms | int64 | 延迟(毫秒) |
| created_at | string | 创建时间 |
| difficulty_score | int64 | 难度分数 |
| pytest_reward | float64 | pytest奖励值 |
| info | struct | 详细信息结构体 |
info 结构体包含:
- id (string):数据ID
- level (int64):级别
- difficulty (string):难度
- included (bool):是否包含
- category (string):类别
- task_bank_version (string):任务库版本
- test_code (string):测试代码
- prompt_test_code (string):提示测试代码
- timing (struct):时间记录,包含 start_time、setup、generation、scoring、model、env、total、overhead 等子字段
- token_usage (struct):Token使用量,包含 input_tokens、output_tokens、final_output_tokens、final_input_tokens
- is_completed (bool):是否完成
- is_truncated (bool):是否被截断
- stop_condition (string):停止条件
- metrics (struct):指标,包含 num_turns(轮次数量)和 pytest_reward(pytest奖励值)
数据集用途
该数据集包含 Python 编程相关的任务追踪与回滚记录,侧重于程序调试与错误追踪场景,适用于训练或评估代码生成、调试、推理等任务的模型。