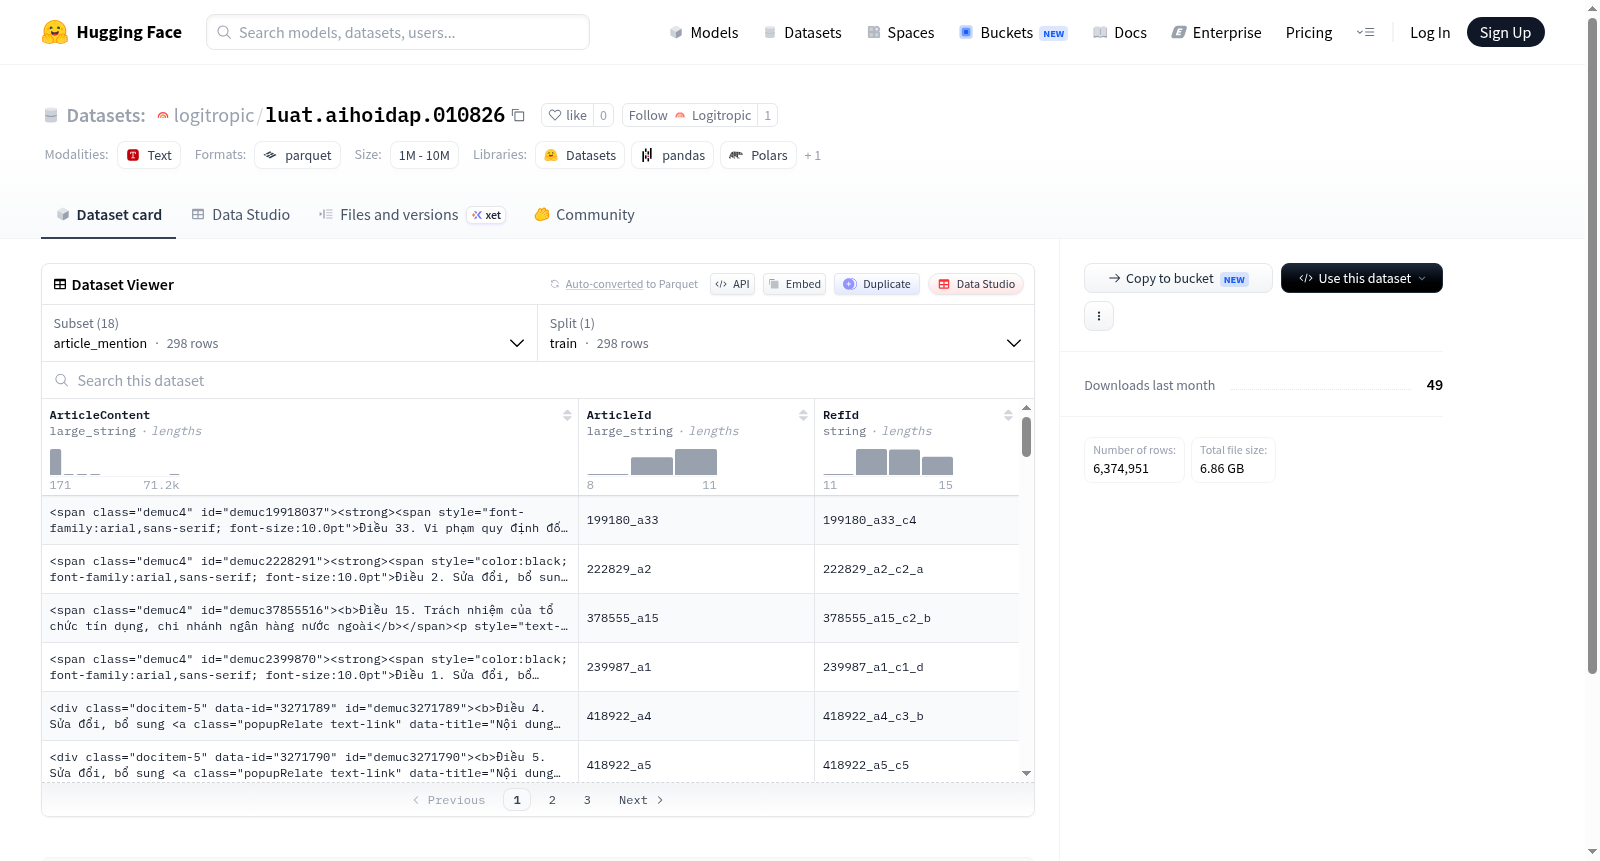
luat.aihoidap.010826
收藏资源简介:
该数据集是一个包含多层次法律文档结构的多配置数据集。它由多个子集组成,分别对应文档、文章、条款和要点等不同粒度的文本单元,以及它们之间的提及和关系信息。具体子集包括:documents(文档)、documents_id(文档标识)、documents_mark(带标记的文档)、documents_property(文档属性,如文档名称、生效状态、发布日期等)、documents_relate(文档间关联关系)、documents_url(文档URL)、articles(文章)、articles_mark(带标记的文章)、article_mention(文章提及)、article_relation(文章关系)、clauses(条款)、clauses_mark(带标记的条款)、clause_mention(条款提及)、clause_relation(条款关系)、points(要点)、points_mark(带标记的要点)、point_mention(要点提及)、point_relation(要点关系)。每个子集仅包含训练集,数据规模从数百到数百万样本不等,总数据量较大。该数据集适用于法律文本分析、文档结构解析、引用关系抽取、法律信息检索等自然语言处理任务。
This dataset is a multi-configuration dataset containing multi-level legal document structures. It consists of multiple subsets corresponding to different granularity text units such as documents, articles, clauses, and points, along with their mention and relation information. The specific subsets include: documents, documents_id, documents_mark, documents_property (e.g., document name, effective status, publication date), documents_relate (inter-document relations), documents_url, articles, articles_mark, article_mention, article_relation, clauses, clauses_mark, clause_mention, clause_relation, points, points_mark, point_mention, point_relation. Each subset contains only a training set, with sample sizes ranging from hundreds to millions, and the total data volume is large. This dataset is suitable for natural language processing tasks such as legal text analysis, document structure parsing, citation relation extraction, and legal information retrieval.
数据集概述:luat.aihoidap.010826
数据集简介
该数据集是一个关于越南法律文档的多层次结构数据集,包含从文档(documents)到条款(articles)、条文(clauses)和要点(points)的层级关系,同时提供文档属性、关联关系以及各层级之间的引用(mention)和关联(relation)信息。数据集共包含18个配置(config),每个配置均提供训练集(train)。
数据集配置详情
核心内容配置
| 配置名称 | 说明 | 主要特征 | 样本数 |
|---|---|---|---|
| documents | 文档内容 | DocId, DocName, EffectStatusName, DocContent, DocUrl | 104,927 |
| documents_id | 文档标识 | DocId, DocName, EffectStatusName | 119,748 |
| documents_mark | 标记后的文档内容 | DocId, DocName, EffectStatusName, DocContent, DocUrl | 36,652 |
| documents_url | 文档链接 | DocId, DocName, EffectStatusName, DocUrl | 104,927 |
| documents_property | 文档属性 | DocId, DocName, EffectStatusName, DocIdentity, GazetteNumber, GazetteDate, IssueDate, EffectDate, ExpireDate, DocTypeName, OrganName, SignerName, FieldName, CrDateTime | 119,748 |
| documents_relate | 文档关联 | DocId, DocName, EffectStatusName, DocRelateList(含DocId和RelateTypeName) | 119,748 |
条款(Article)层级配置
| 配置名称 | 说明 | 主要特征 | 样本数 |
|---|---|---|---|
| articles | 条款内容 | DocId, ArticleContent, ArticleId | 427,327 |
| articles_mark | 标记后的条款内容 | DocId, ArticleContent, ArticleId | 490,526 |
| article_mention | 条款引用 | ArticleContent, ArticleId, RefId | 298 |
| article_relation | 条款关联 | ArticleId, ArticleId_origin, DocItemRelateId, DocItemId, ReferenceName | 77,160 |
条文(Clause)层级配置
| 配置名称 | 说明 | 主要特征 | 样本数 |
|---|---|---|---|
| clauses | 条文内容 | DocId, ArticleId, ClauseContent, Prefix, ClauseId | 925,337 |
| clauses_mark | 标记后的条文内容 | DocId, ArticleId, ClauseContent, Prefix, ClauseId | 1,453,338 |
| clause_mention | 条文引用 | ClauseContent, ClauseId, RefId | 7,097 |
| clause_relation | 条文关联 | ClauseId, ClauseId_origin, DocItemRelateId, DocItemId, ReferenceName | 175,586 |
要点(Point)层级配置
| 配置名称 | 说明 | 主要特征 | 样本数 |
|---|---|---|---|
| points | 要点内容 | DocId, ArticleId, Prefix, ClauseId, PointContent, PointId | 818,094 |
| points_mark | 标记后的要点内容 | DocId, ArticleId, Prefix, ClauseId, PointContent, PointId | 1,283,771 |
| point_mention | 要点引用 | PointContent, PointId, RefId | 6,468 |
| point_relation | 要点关联 | PointId, PointId_origin, DocItemRelateId, DocItemId, ReferenceName | 104,199 |
数据规模与规格
- 最大配置:documents_mark(约12.0 GB)和documents(约11.0 GB)
- 最小配置:article_mention(约1.0 MB)
- 数据总量:约31.9 GB(所有配置总和)
- 所有配置均包含统一的train分割,无其他分割
潜在应用场景
- 越南法律文本的层级结构解析与信息提取
- 法律文档间的关联关系挖掘与引用分析
- 文档、条款、条文、要点多粒度文本的检索与分类任务
- 法律文本的自然语言处理模型训练与评估