bergson-smollm2-scaling
收藏资源简介:
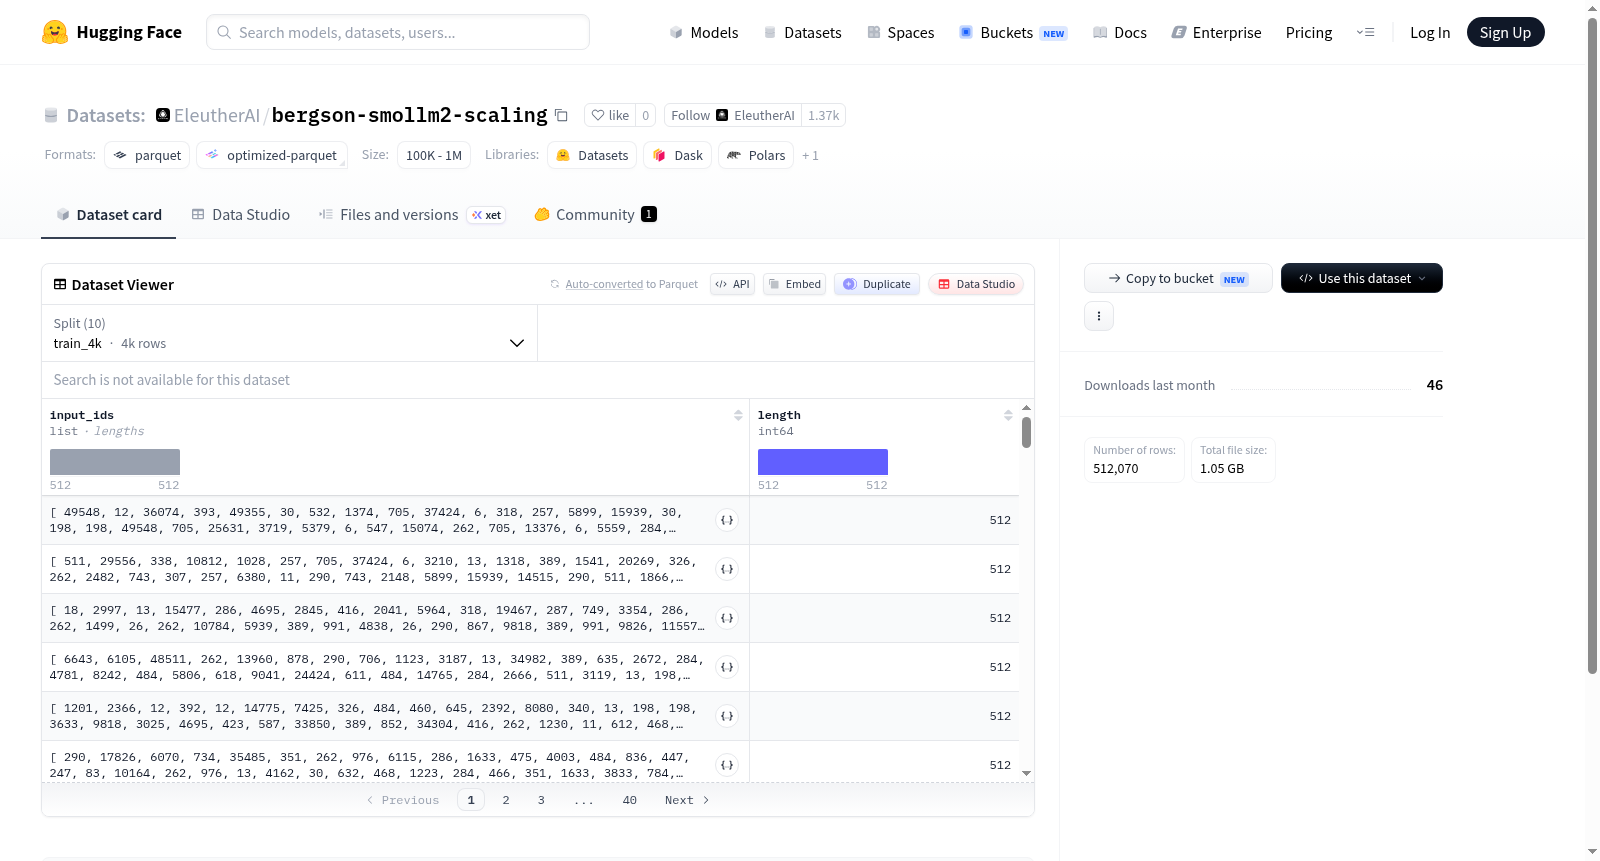
该数据集包含用于训练语言模型的tokenized序列。每条样本包含两个字段:input_ids(整数列表,表示token序列)和length(整数,表示序列长度)。数据集提供了多种规模的训练子集:train_4k(4000样本)、train_8k(8000样本)、train_16k(16000样本)、train_32k(32000样本)、train_64k(64000样本)、train_128k(128000样本)和train_256k(256000样本),以及一个heldout_4k验证集(4000样本)和两个小规模查询集query_50(50样本)和query_20(20样本)。总数据量约1GB,适用于不同规模的语言模型预训练、微调或评估任务。
This dataset contains tokenized sequences for training language models. Each sample includes two fields: input_ids (a list of integers representing token sequences) and length (an integer representing sequence length). The dataset provides training subsets of various sizes: train_4k (4000 samples), train_8k (8000 samples), train_16k (16000 samples), train_32k (32000 samples), train_64k (64000 samples), train_128k (128000 samples), and train_256k (256000 samples), as well as a heldout_4k validation set (4000 samples) and two small query sets query_50 (50 samples) and query_20 (20 samples). The total data volume is approximately 1GB, suitable for pre-training, fine-tuning, or evaluation tasks of language models at different scales.
数据集概述:EleutherAI/bergson-smollm2-scaling
基本信息
- 数据集地址:https://huggingface.co/datasets/EleutherAI/bergson-smollm2-scaling
- 数据集大小:约 1,054,864,200 字节(约 1.05 GB)
- 下载大小:约 1,051,574,307 字节(约 1.05 GB)
数据特征
- 特征字段:
input_ids:数据类型为 int32 的列表length:数据类型为 int64
数据划分
该数据集包含以下多个子集,按数据规模逐步递增:
训练集
| 子集名称 | 样本数量 | 数据大小 |
|---|---|---|
| train_4k | 4,000 | 8,240,000 字节 |
| train_8k | 8,000 | 16,480,000 字节 |
| train_16k | 16,000 | 32,960,000 字节 |
| train_32k | 32,000 | 65,920,000 字节 |
| train_64k | 64,000 | 131,840,000 字节 |
| train_128k | 128,000 | 263,680,000 字节 |
| train_256k | 256,000 | 527,360,000 字节 |
保留集
| 子集名称 | 样本数量 | 数据大小 |
|---|---|---|
| heldout_4k | 4,000 | 8,240,000 字节 |
查询集
| 子集名称 | 样本数量 | 数据大小 |
|---|---|---|
| query_50 | 50 | 103,000 字节 |
| query_20 | 20 | 41,200 字节 |
配置信息
- 默认配置名称:default
- 数据文件路径:各子集分别对应
data/目录下的文件,使用通配符(*)匹配多个分片文件。
用途说明
该数据集专为语言模型缩放实验设计,提供了从 4,000 到 256,000 数量不等的训练样本,用于研究模型性能随数据规模的变化规律。同时包含独立的保留集(heldout_4k)用于验证,以及少量查询样本(query_50、query_20)用于测试或快速演示。