
nassimjp/pashto-chatbot-greetings
收藏官方服务:
资源简介:
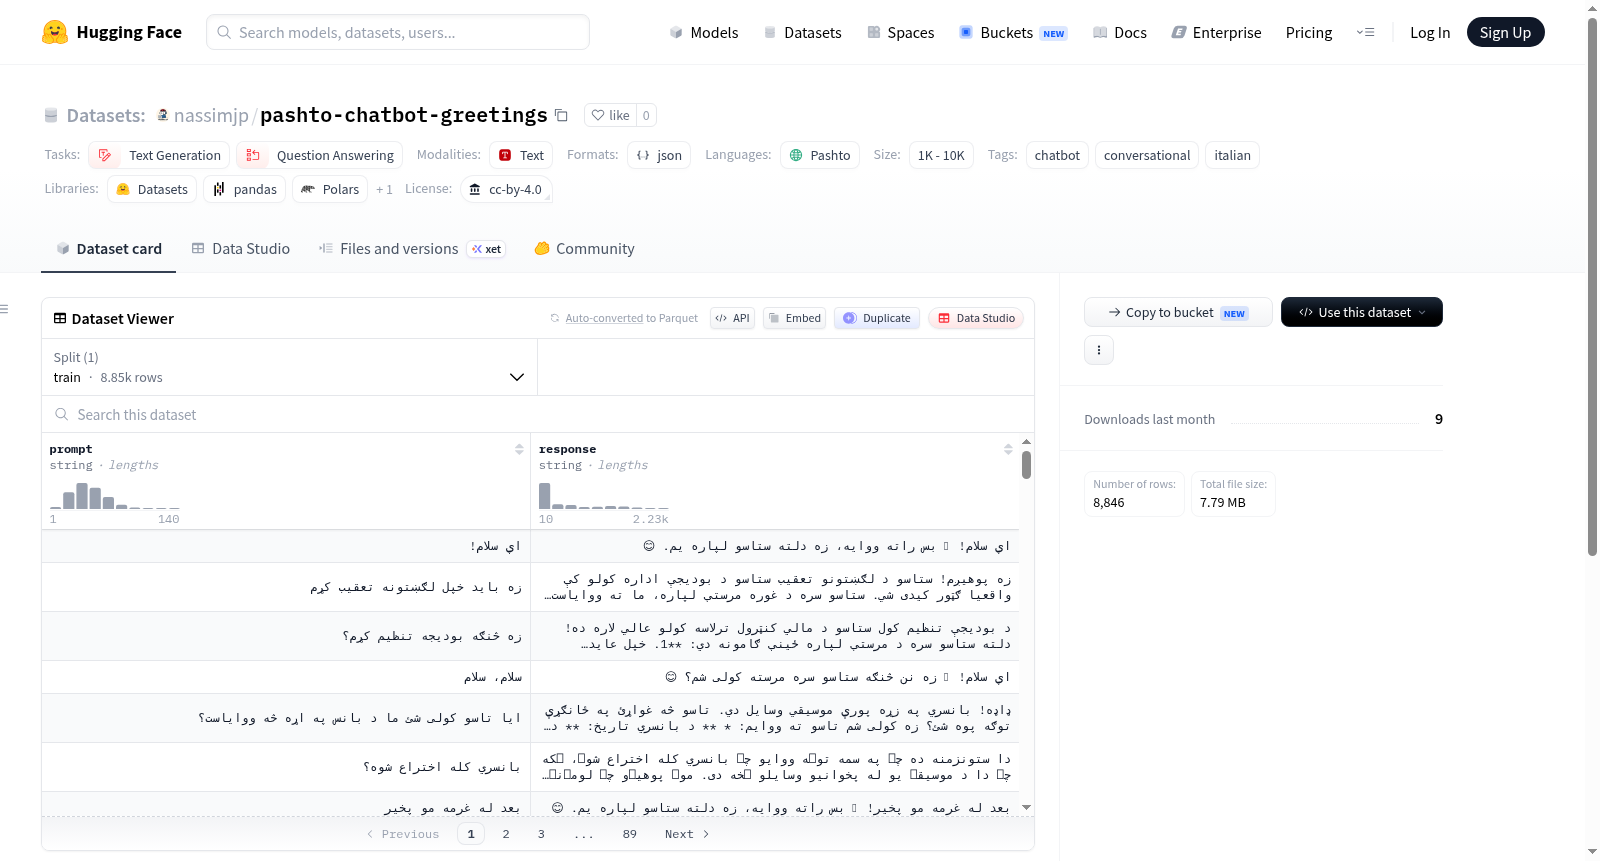
Pashto聊天机器人问候数据集是一个多轮聊天机器人问候配置数据集,从意大利语翻译成普什图语(ps)。数据集包含8,846条记录,格式为流式JSON行(.jsonl),由nassimjp维护。
Pashto Chatbot Greetings Dataset: Multi-turn chatbot greeting configurations translated from Italian into Pashto (ps). Total records: 8,846, format: Streaming JSON Lines (.jsonl), maintained by nassimjp.
提供机构:
nassimjp搜集汇总
数据集介绍
构建方式
该数据集源自意大利语的多轮聊天机器人问候配置,经由专业翻译转化为普什图语(ps),以构建面向普什图语用户的对话式人工智能语料库。数据以流式JSON Lines格式(.jsonl)存储,涵盖8,846条记录,由贡献者nassimjp维护,确保了数据的结构统一与跨语言迁移的语义保真度。
特点
数据集专为文本生成与问答任务设计,聚焦于多轮对话中的问候场景,具有领域聚焦性强的特点。其核心优势在于语言稀缺性——针对普什图语这一低资源语言,提供了结构化的对话数据,支持聊天机器人的语用适配与跨文化交互研究,同时兼容HuggingFace生态的流式加载与微调工具链。
使用方法
用户可通过HuggingFace Datasets库加载该数据集,利用其流式特性高效处理大规模对话样本。适用于序列到序列的对话模型微调、评估普什图语生成系统的问候精度,或作为低资源语言对话系统的基准语料。建议结合tokenizer适配普什图语的字符级特征,并利用多轮对话的时序关系优化上下文建模。
背景与挑战
背景概述
在自然语言处理与对话系统领域,低资源语言的数据匮乏长期制约着相关技术的发展,尤其是普什图语(Pashto)等使用范围有限的语言,其对话数据的构建更是鲜有涉足。pashto-chatbot-greetings数据集由维护者nassimjp于近期创建,致力于将意大利语中的多轮聊天机器人问候配置翻译为普什图语,旨在填补该语言在对话数据方面的空白。该数据集包含8,846条记录,以流式JSON Lines格式存储,专门服务于文本生成与问答任务,为面向普什图语用户的人机交互研究提供了基础资源,对推动低资源语言对话系统的本土化发展具有示范意义。
当前挑战
该数据集核心面对的挑战来自两个方面。在领域问题层面,普什图语作为低资源语言,缺乏足够的预训练语料与对话模板,现有模型难以准确生成符合文化习惯的问候与应答,亟需高质量数据以提升跨语言对话系统的鲁棒性。在构建过程中,将意大利语问候配置翻译为普什图语需克服语法结构差异与地域用语歧义,同时确保多轮对话的上下文连贯性,这对翻译准确性与数据一致性提出了严苛要求,加之仅由单一维护者完成,数据规模与多样性亦可能制约泛化能力。
常用场景
经典使用场景
该数据集专为普什图语对话系统的基础问候场景而设计,提供了近九千条多轮对话配置。在自然语言处理的前沿领域,它常被用作构建与评估低资源语言聊天机器人的起始基准,尤其专注于问候、寒暄等社交开场白环节,为模型学习普什图语的基本交互模式提供了核心训练素材。
衍生相关工作
围绕该数据集,衍生出关于跨语言对话模板对齐、低资源语言微调策略以及少样本学习在普什图语上的适配性研究。此外,它也启发了将意大利语等富资源语言的对话模式向其他低资源小语种进行迁移的系列工作,推动了多语言对话系统预训练与领域适配技术的交叉探索。
数据集最近研究
最新研究方向
当前,普什图语作为低资源语言在自然语言处理领域备受关注,该数据集聚焦于多轮对话问候场景,为普什图语聊天机器人的开发提供了高质量基础语料。前沿研究正围绕低资源语言的对话系统展开,利用此类数据集训练跨语言迁移模型,以缓解标注数据匮乏的瓶颈。同时,结合普什图语社区数字化服务的迫切需求,该资源在推动文化包容性AI应用、促进人机交互多样性方面具有显著意义,尤其在智能客服、社区信息引导等场景中展现出广阔潜力。
以上内容由遇见数据集搜集并总结生成


