
遇见数据集

quran-reciter-audio

收藏
Hugging Face2026-03-27 更新2026-03-28 收录
官方服务:

资源简介:

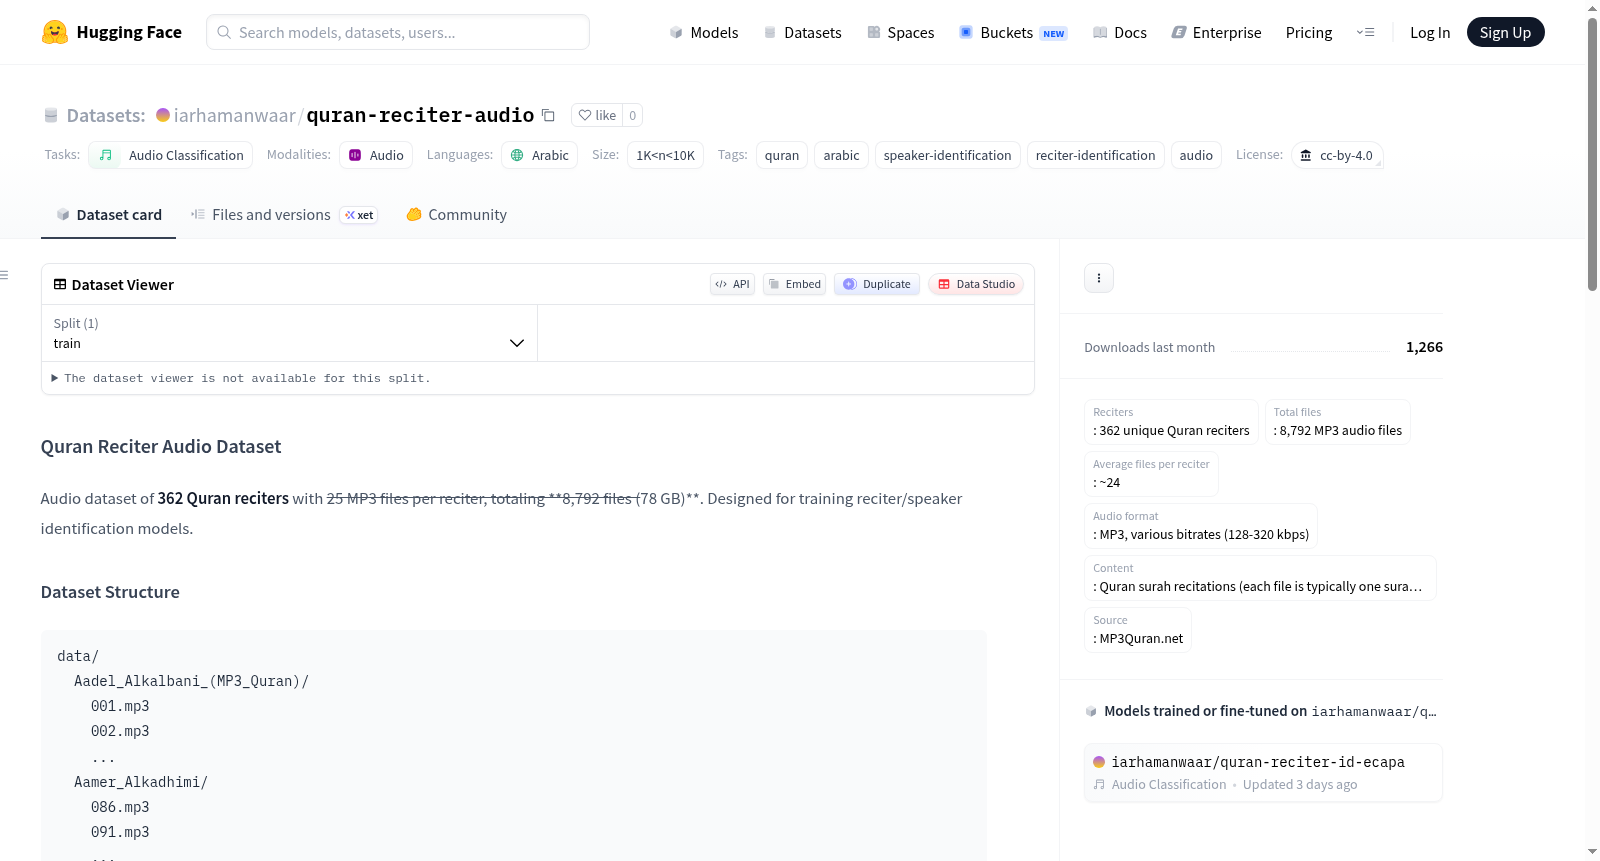
Quran Reciter Audio Dataset 是一个包含362位古兰经诵经者的音频数据集,总计8,792个MP3文件(约78 GB)。每个诵经者平均有约24个音频文件,文件格式为MP3,比特率在128-320 kbps之间。数据集内容为古兰经章节的诵读(每个文件通常为一个章节或部分)。数据来源于MP3Quran.net,适用于训练诵经者/说话人识别模型。数据集按照诵经者姓名组织目录,文件按章节编号。该数据集采用CC-BY-4.0许可,使用时需注明来源。

Quran Reciter Audio Dataset is an audio dataset encompassing 362 Quran reciters, with a total of 8,792 MP3 files (approximately 78 GB). On average, each reciter holds about 24 audio files, all in MP3 format with bitrates ranging from 128 to 320 kbps. The dataset consists of recitations of Quranic chapters, where each file typically corresponds to one chapter or a segment thereof. It is sourced from MP3Quran.net and is suitable for training reciter/speaker recognition models. The dataset organizes directories by the reciter's name, with files sorted by chapter number. This dataset is licensed under CC-BY-4.0, and the source must be cited when used.
创建时间:
2026-03-25
搜集汇总
数据集介绍
quran-reciter-audio 数据集图片
构建方式
在伊斯兰文化中,《古兰经》的诵读艺术承载着深厚的宗教与语言学价值,该数据集的构建过程体现了对传统诵读遗产的系统性数字化保存。数据集从MP3Quran.net平台精心采集了362位不同诵读者的音频资料,每位诵读者平均收录约25个MP3文件,总计形成8,792个音频样本,涵盖《古兰经》各章节的完整或部分诵读内容。音频以MP3格式存储,比特率在128至320 kbps之间,确保了音质的多样性与真实性,所有文件按诵读者姓名建立独立目录,并依据章节编号有序组织,为后续计算分析提供了结构化的数据基础。
特点
该数据集的核心特点在于其广泛的代表性与高度的专业性,汇聚了362位独特诵读者的声音样本,每位诵读者贡献了2至33个不等的音频文件,整体规模达到约78 GB,构成了当前阿拉伯语诵读识别领域较为全面的资源之一。音频内容均源自《古兰经》的正统诵读,不仅覆盖了多样的诵读风格与语音特征,还反映了阿拉伯语语音的丰富韵律变化。数据集专为诵读者识别与说话人识别任务设计,其结构化目录布局与标准化命名规则,便于研究者直接应用于机器学习模型的训练与评估,同时所有数据遵循CC-BY-4.0许可协议,确保了学术使用的合法性与透明度。
使用方法
为便于学术研究与工程应用,该数据集可通过Hugging Face生态系统便捷加载。用户可使用datasets库中的load_dataset函数,指定数据集名称'iarhamanwaar/quran-reciter-audio',即可自动下载并访问完整的音频文件与元数据。若需本地化管理,亦可借助huggingface_hub模块的snapshot_download功能,将数据集整体下载至指定目录。数据集的结构化组织形式允许研究者按诵读者目录直接读取音频,适用于说话人识别、声纹建模或伊斯兰文化语音分析等任务,同时配套的微调ECAPA-TDNN模型进一步拓展了其在实时识别场景中的应用潜力。
背景与挑战
背景概述
在语音技术与伊斯兰文化研究的交叉领域,古兰经诵读者识别任务逐渐受到关注。Quran Reciter Audio数据集由Arham Anwaar于2026年创建,旨在为诵读者身份识别模型提供训练资源。该数据集汇集了来自MP3Quran.net平台的362位独特诵读者,共计约8,792个MP3音频文件,涵盖了古兰经各章节的诵读片段。其核心研究问题聚焦于如何利用音频特征准确识别诵读者身份,从而推动阿拉伯语语音处理、说话人识别技术在宗教音频分析中的应用,并为文化遗产的数字化保存与检索提供技术支持。
当前挑战
该数据集旨在解决古兰经诵读者识别这一特定说话人识别任务的挑战,包括处理阿拉伯语诵读特有的韵律、音调变化以及不同诵读者之间风格的细微差异。构建过程中面临多重困难:音频文件来源于公开网络平台,需统一处理多样的比特率(128-320 kbps)与录制条件;数据规模庞大(约78 GB),在存储与预处理上存在效率瓶颈;同时,确保每位诵读者样本的均衡性(文件数量介于2至33之间)以维持模型训练的公平性,亦是一项复杂工作。
常用场景
经典使用场景
在语音识别与音频分析领域,Quran Reciter Audio数据集为研究者提供了一个独特的阿拉伯语语音资源。该数据集最经典的使用场景是训练和评估说话人识别模型,特别是针对古兰经诵经者的身份鉴别任务。通过涵盖362位不同诵经者的音频样本,模型能够学习到每位诵经者独特的语音特征、韵律模式和发音风格,从而在复杂的多说话人环境中实现高精度的身份验证。
解决学术问题
该数据集有效解决了语音技术研究中几个关键学术问题。首先,它提供了大规模、多样化的阿拉伯语语音数据,弥补了该语言在说话人识别任务中数据稀缺的不足。其次,数据集专注于宗教诵经这一特定领域,有助于探索领域自适应和跨领域语音特征迁移的挑战。此外,它支持研究在高度风格化、韵律丰富的语音中如何保持识别鲁棒性,推动了语音生物识别技术在文化特定场景下的理论进展。
衍生相关工作
围绕该数据集已衍生出多项经典研究工作。最直接的是基于ECAPA-TDNN架构的诵经者识别模型,该模型在数据集上进行了微调,实现了高效的说话人嵌入提取。进一步的研究扩展至多任务学习,结合诵经者识别与章节自动标注。也有工作探索了轻量化模型在移动设备上的部署,以及利用该数据集的语音特征进行诵经情感分析与风格相似性度量,推动了音频计算在文化遗产领域的交叉应用。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

