
car-rental-reviews
收藏官方服务:
资源简介:
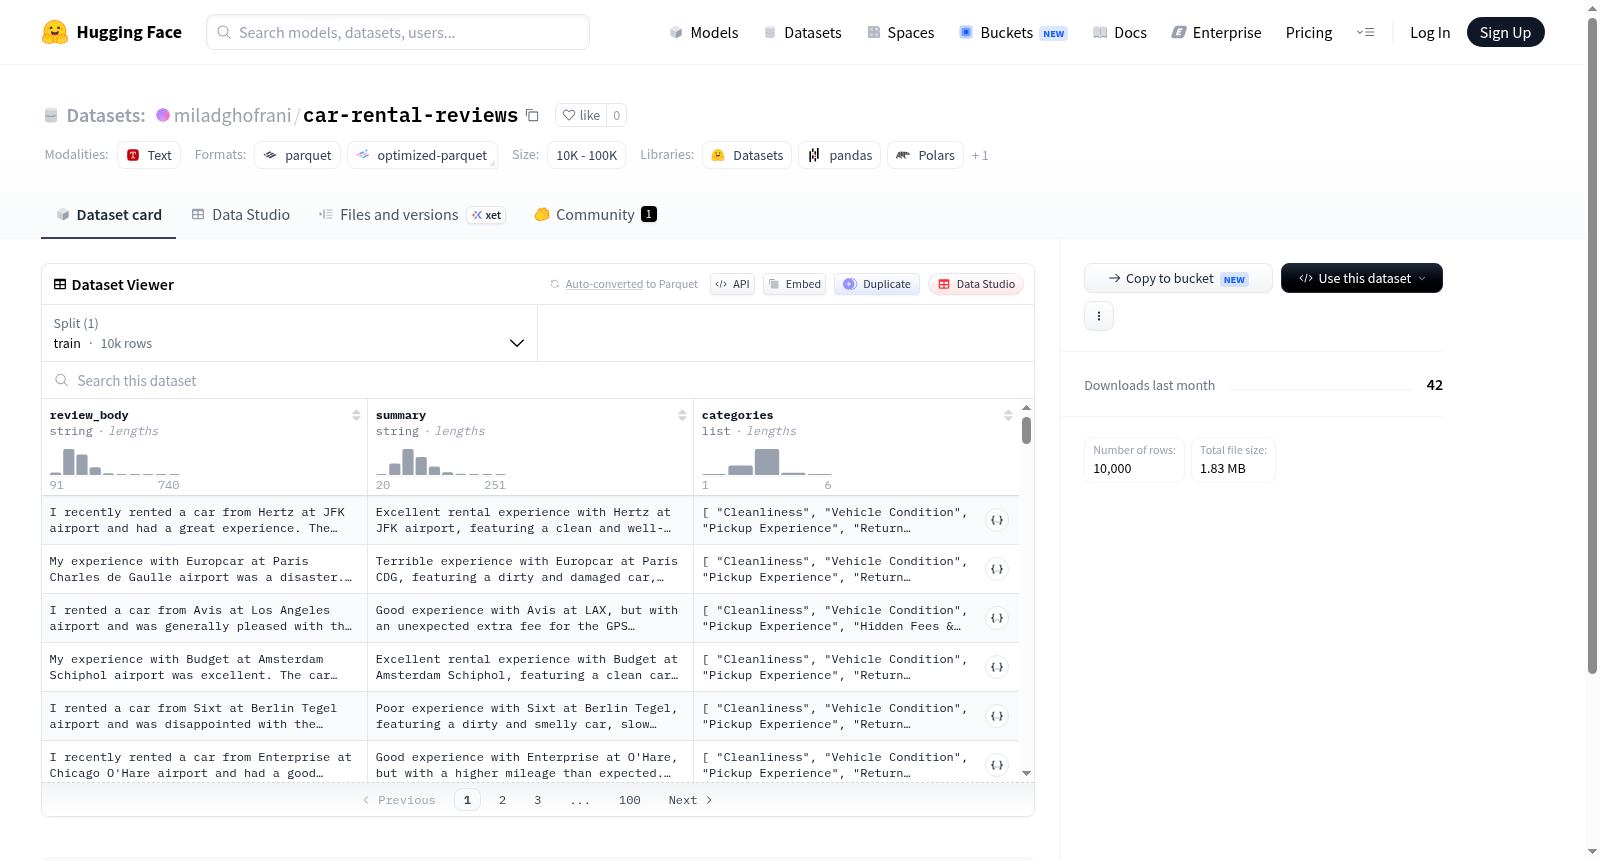
该数据集包含4151个训练样本,每个样本由评论文本(review_body)、摘要文本(summary)和类别标签列表(categories)三个字段组成。数据以结构化格式存储,总大小约为1.74MB,适用于文本摘要、情感分析或多标签分类等自然语言处理任务。
This dataset contains 4151 training samples, each consisting of three fields: review text (review_body), summary text (summary), and a list of category labels (categories). The data is stored in a structured format with a total size of approximately 1.74MB, and is suitable for natural language processing tasks such as text summarization, sentiment analysis, or multi-label classification.
创建时间:
2026-06-26
原始信息汇总
数据集概述
该数据集名为 car-rental-reviews,由 miladghofrani 在 Hugging Face 上发布,主要用于汽车租赁相关的评论分析任务。
数据字段
review_body(字符串类型):评论文本内容summary(字符串类型):评论摘要categories(字符串列表类型):评论所属类别
数据划分
- 训练集:包含 10,000 条样本,数据大小约为 3.98 MB
配置与文件
- 配置文件名称:
default - 数据文件路径:
data/train-* - 下载大小:约 1.83 MB
- 数据集总大小:约 3.98 MB
使用场景
适用于自然语言处理中的情感分析、文本摘要、分类等任务,特别是针对汽车租赁服务的用户评论数据。
搜集汇总
数据集介绍
构建方式
该数据集名为car-rental-reviews,专注于汽车租赁服务的用户评论数据。数据集的构建基于从公开网络平台采集的文本信息,每条记录包含评论文本(review_body)、评论摘要(summary)以及所属类别(categories)三个核心字段。其中,类别字段以列表形式存储,支持多标签分类场景。数据源经过清洗与标准化后,划分为单一训练集(train),共计10,000条样本,总数据量约3.98 MB。文件以Parquet格式存储于HuggingFace仓库中,便于高效加载与处理。
特点
该数据集的特点在于聚焦于汽车租赁这一垂直领域,提供了结构化的用户反馈信息。评论文本与摘要的配对设计,使其不仅适用于分类任务,还能支持文本摘要模型的训练。类别字段的多标签属性,允许每条评论涉及多个主题(如服务、价格、车辆状况等),增强了数据表达的丰富性。10,000条样本的规模虽不大,但经过精心筛选,确保了文本质量与领域相关性,适合作为小样本学习的基准数据集。
使用方法
在HuggingFace平台上,可通过datasets库直接加载该数据集,默认配置为default,仅包含训练集。用户可调用类似load_dataset('car-rental-reviews')的API快速获取数据。使用时,需注意字段含义:review_body为原始评论,summary为人工或自动生成的摘要,categories为标签列表。适用于文本分类、情感分析、摘要生成等自然语言处理任务。建议将数据集划分为训练集与验证集(如90%训练、10%验证)以评估模型性能。推荐结合Transformers库进行预训练模型微调,以适配下游任务。
背景与挑战
背景概述
在共享经济蓬勃发展的背景下,汽车租赁服务已成为现代出行的重要组成,用户反馈数据蕴含着服务质量提升与市场洞察的宝贵信息。car-rental-reviews数据集于近年由相关研究机构构建,旨在系统收集租车领域的用户评论文本,以支撑细粒度的情感分析与服务质量评估研究。该数据集收录了10,000条训练样本,涵盖评论文本、摘要及多维类别标签,为自然语言处理领域探索用户生成内容中的意见挖掘与分类任务提供了标准化的实验基础。其影响力体现在推动了面向垂直服务领域的非结构化文本理解技术发展,尤其在多标签文本分类与情感极性分析子任务中扮演了基准角色。
当前挑战
该数据集所面临的挑战首先体现于领域问题的复杂性:汽车租赁评论常涉及车况、服务效率、价格透明度等多维交织的方面,如何从非结构化文本中精准抽取细粒度意见并消除语义歧义,构成核心困难。构建过程中,数据源的口语化表达、拼写错误以及不同用户的情绪化语言,增加了标注一致性维护的难度。此外,类别标签的层级关联性与样本分布不均衡问题,要求建模时需兼顾低频类别的识别鲁棒性,对现有文本分类与情感分析算法构成了严苛的泛化能力考验。
常用场景
经典使用场景
在消费者行为与服务质量评估的研究领域中,汽车租赁评论数据集承载着揭示用户体验细节的独特价值。该数据集收录了一万条带摘要与分类标签的评论文本,为探究租车服务中的满意度驱动因素、抱怨模式及情感倾向提供了丰富的语料。研究者常利用其进行细粒度情感分析,挖掘用户对车辆状况、取还流程、客服响应等维度的态度,或构建主题模型以提炼服务改进的关键议题。
实际应用
在产业界,此数据集可支撑构建智能客服系统的情绪监控模块,通过实时分析评论趋势预警服务危机。汽车租赁平台能运用其训练AIGC摘要生成模型,自动提炼冗长评论中的核心痛点或亮点,辅助运营团队快速定位车辆故障或员工培训需求。此外,基于评论分类结果的推荐算法可优化车型与保险套餐的个性化展示,从而提升用户转化率与留存率。
衍生相关工作
该数据集衍生了若干经典研究工作,包括基于预训练语言模型的租车评论情感迁移学习方法,旨在将大规模通用语料知识适应至利基领域。另有工作探索了跨语言评论摘要的对照分析,通过提取中文与英文评论中的共同服务基准构建国际化质量评估框架。多任务学习框架也在此数据集上得到应用,同步完成满意度评级与关键短语抽取,推动了低资源服务评论的深度理解技术演进。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


