
eaeasee/Lean-Workbook
收藏官方服务:
资源简介:
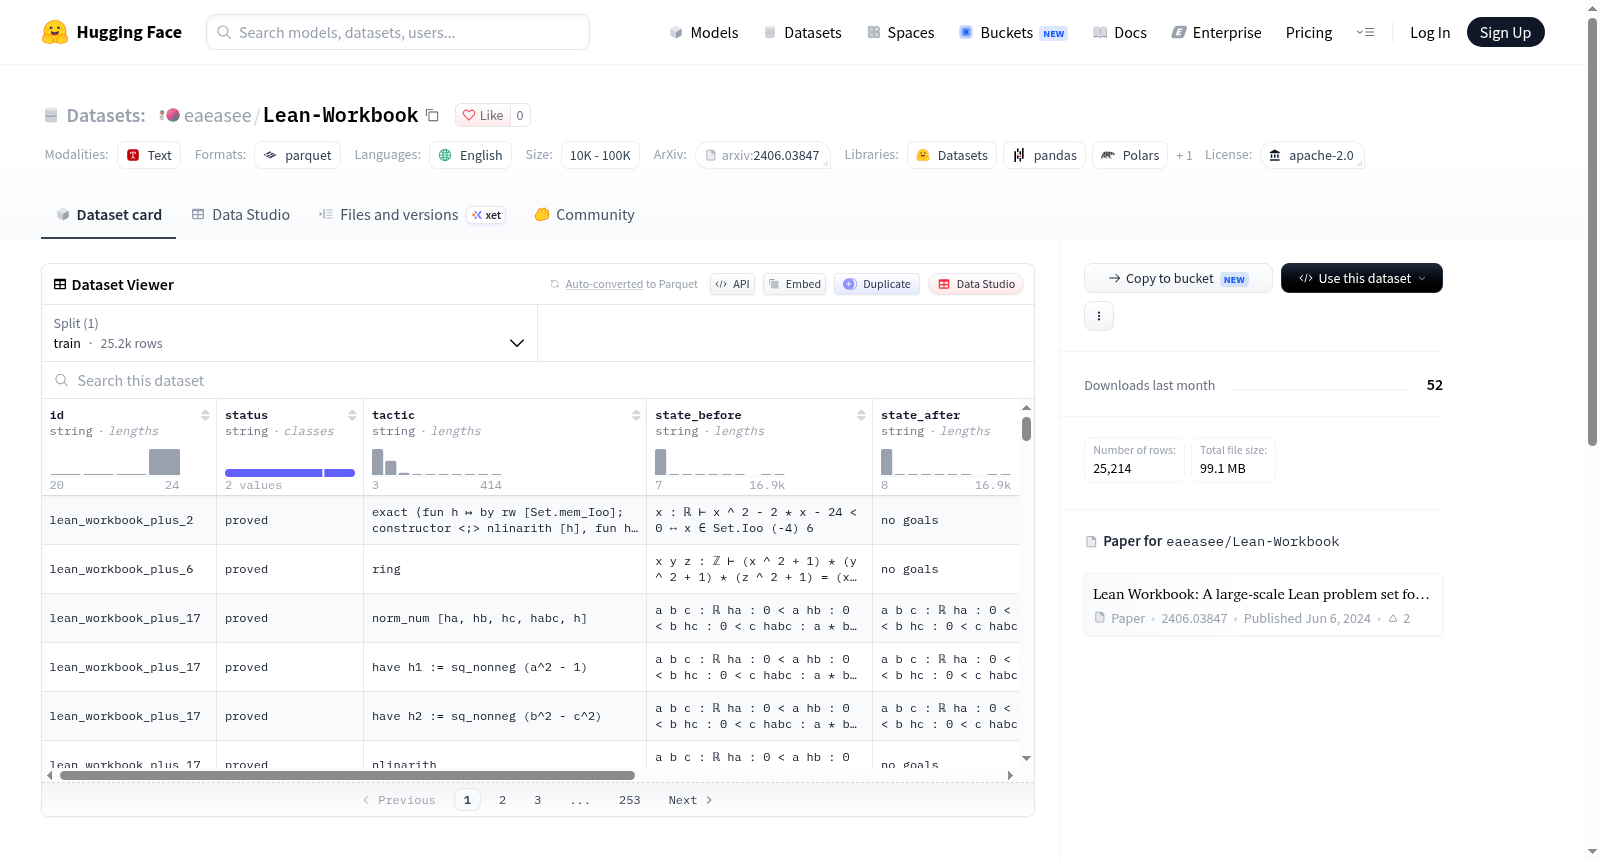
Lean Workbook 数据集是一个关于竞赛级数学问题的集合,这些问题使用 Lean 4 进行形式化。数据集包含两个部分:Lean Workbook(57231 个问题)和 Lean Workbook Plus(82893 个问题)。每个问题都提供自然语言陈述、答案、形式化陈述和形式化证明(如果可用)。这些数据可用于自动形式化模型训练和证明搜索。
Lean Workbook dataset is about contest-level math problems formalized in Lean 4. It contains 57231 problems in the split of Lean Workbook and 82893 problems in the split of Lean Workbook Plus. We provide the natural language statement, answer, formal statement, and formal proof (if available) for each problem. These data can support autoformalization model training and searching for proofs.
提供机构:
eaeasee搜集汇总
数据集介绍
构建方式
该数据集立足于竞赛级数学问题形式化的需求,通过将自然语言表述的数学问题转化为Lean 4可验证的形式化语句与证明,构建了大规模形式化问题集。构建过程依托InternLM-Math开源项目,由专业标注人员与自动形式化流程协同完成,每个问题均包含自然语言陈述、答案、形式化陈述及可用的形式化证明。数据集划分为Lean Workbook和Lean Workbook Plus两个子集,分别涵盖57231与82893个问题,所有形式化内容均在Lean v4.8.0-rc1与Mathlib4同版本环境下验证通过。
特点
数据集聚焦于竞赛级数学问题的形式化表达,兼具规模性与严谨性。其核心特点在于同时提供自然语言与形式化双重表述,并附带答案与证明,为自动形式化与定理证明研究提供了丰富监督信号。数据集覆盖10K至100K量级,语言为英文,采用Apache-2.0许可,便于学术与商业使用。问题来源于竞赛数学,形式化后可直接在Lean 4环境中编译验证,确保了逻辑一致性。此外,数据集与开源代码库紧密集成,支持可复现的实验流程。
使用方法
使用该数据集时,研究者可依托HuggingFace平台直接加载数据,结合提供的开源代码进行自动形式化模型训练或证明搜索。数据可用于训练模型将自然语言数学问题转化为Lean 4形式化语句,亦可作为定理证明器的评估基准。使用前需配置Lean v4.8.0-rc1及对应版本Mathlib4环境,以确保形式化代码的正确编译。数据集支持监督微调、强化学习等范式,并可通过引用指定论文获取技术细节。用户应遵守Apache-2.0许可协议,合理使用数据与代码。
背景与挑战
背景概述
在数学形式化与自动定理证明领域,高质量的基准数据集长期稀缺,阻碍了机器推理能力的深入探索。Lean-Workbook数据集由上海人工智能实验室联合商汤科技等机构的研究人员于2024年创建,旨在将竞赛级自然语言数学问题转化为Lean 4形式化表述,以推动自动形式化与定理证明研究。该数据集包含Lean Workbook和Lean Workbook Plus两个子集,分别涵盖57231与82893道题目,每道题提供自然语言陈述、答案、形式化陈述及(若可得)形式化证明。其开源代码与数据为训练自动形式化模型和搜索证明提供了大规模资源,对数学与人工智能交叉领域产生了显著影响。
当前挑战
该数据集所应对的领域问题——自动形式化数学问题并求解——本质上面临自然语言歧义、数学语义精确映射以及形式化证明搜索空间爆炸等固有困难。构建过程中,将竞赛级数学问题从自然语言翻译为Lean 4代码需克服表述多样性、隐含假设与复杂推理步骤的自动化提取难题。此外,确保形式化陈述与证明的正确性及与Mathlib4库的兼容性,要求严格的验证流程与大量人工校验。数据集虽规模庞大,但形式化证明的完整性与覆盖度仍受限于数学知识的深度与广度,为后续研究提出了持续挑战。
常用场景
经典使用场景
在数学形式化与自动定理证明的交汇领域,Lean-Workbook数据集扮演着基石性的角色。其最经典的使用场景在于为自动形式化模型提供大规模、高质量的训练语料,这些语料将自然语言描述的竞赛级数学问题与Lean 4形式化陈述及证明配对。研究者可借此训练模型将非形式化的数学问题转化为机器可验证的形式化代码,并进一步搜索或生成证明。该数据集包含57,231个问题和82,893个增强问题,覆盖从自然语言陈述、答案到形式化证明的完整链条,为形式化推理任务提供了标准化的基准。
解决学术问题
该数据集有效缓解了形式化数学领域长期存在的训练数据稀缺与领域覆盖不足的难题。此前,自动形式化研究受限于小规模、非竞赛级或缺乏证明标注的数据集,难以评估模型在复杂推理上的泛化能力。Lean-Workbook通过大规模竞赛级问题的形式化,为评估自动形式化模型的准确性、证明搜索的完备性以及跨领域迁移能力提供了严谨的测试平台。其意义在于推动了形式化数学与自然语言处理的交叉研究,使得模型能够在严格逻辑框架下进行数学推理,为可信人工智能在数学领域的应用奠定了数据基础。
衍生相关工作
Lean-Workbook的发布催生了一系列围绕自动形式化与证明搜索的经典工作。基于该数据集,研究者开发了InternLM-Math系列模型,在自动形式化任务上取得了显著性能提升,并探索了迭代式证明搜索策略。后续工作进一步利用其增强版Lean Workbook Plus进行课程学习与数据增强,推动了形式化数学基准的建立。同时,该数据集激发了将强化学习与形式化证明相结合的研究,例如通过反馈引导的证明生成,以及跨库迁移的形式化方法,为Lean社区和自动定理证明领域注入了新的活力。
以上内容由遇见数据集搜集并总结生成


