us-caselaw-wy
收藏资源简介:
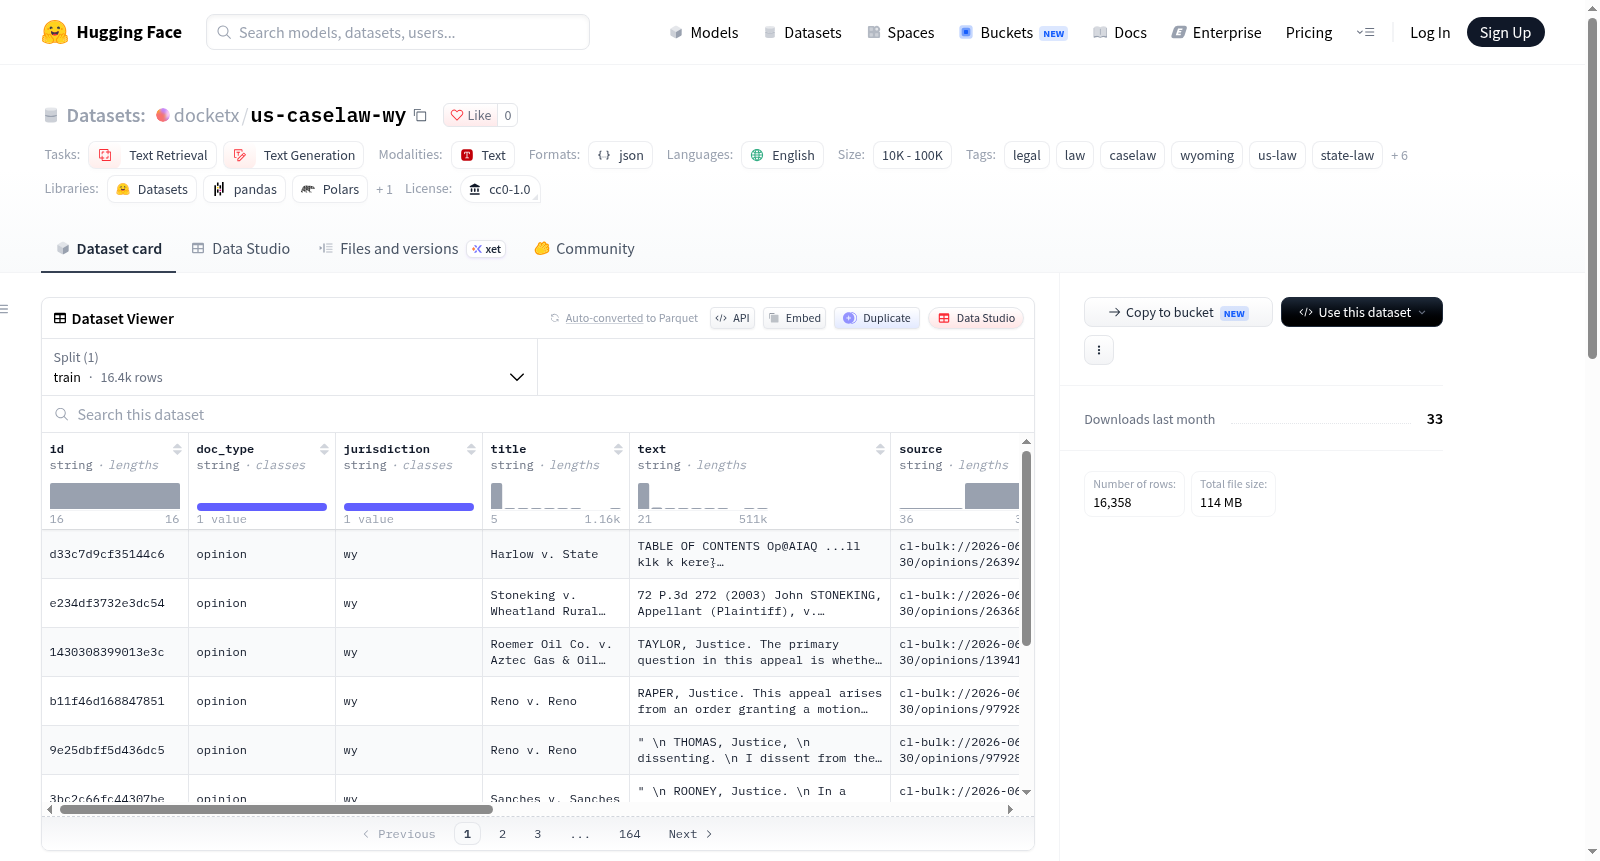
Wyoming Case Law 是一个包含16,358份怀俄明州上诉法院意见全文的数据集,源自 Free Law Project 于2026年6月30日的 CourtListener 批量导出。数据集覆盖法院标识为 wyo,包括主意见和单独意见,最小文档长度设为1字符以保留完整的公共记录(含驳回、单行命令和判决录入等简短记录)。其中15,317份文档(93.6%)超过2,000字符,943份(5.8%)为200-1,999字符,98份(0.6%)少于200字符。数据采用 docketx record v1 格式,每行一条意见,字段包括:id、doc_type、jurisdiction、title、text、source、license、retrieved_at、citation、court、date 和 extra(CourtListener 意见/案件簇ID及意见类型)。数据集基于美国司法意见作为政府法令属于公共领域的原则,以 CC0 1.0 许可证发布,不添加任何标注,无版权主张。该数据集适用于文本检索(如 RAG、法律检索)和文本生成(如法律 NLP 研究)等任务。
Wyoming Case Law is a dataset containing the full text of 16,358 opinions from the Wyoming appellate courts, sourced from the Free Law Projects CourtListener bulk export on June 30, 2026. The dataset covers court identifier wyo, including majority opinions and separate opinions, with a minimum document length of 1 character to preserve complete public records (including short records such as dismissals, single-line orders, and judgment entries). Among them, 15,317 documents (93.6%) exceed 2,000 characters, 943 (5.8%) are 200-1,999 characters, and 98 (0.6%) are fewer than 200 characters. The data uses the docketx record v1 format, with one opinion per line, and fields include: id, doc_type, jurisdiction, title, text, source, license, retrieved_at, citation, court, date, and extra (CourtListener opinion/case cluster IDs and opinion type). The dataset is released under the CC0 1.0 license based on the principle that U.S. judicial opinions are in the public domain as government edicts, without any annotations or copyright claims. It is suitable for tasks such as text retrieval (e.g., RAG, legal search) and text generation (e.g., legal NLP research).
Wyoming Case Law 数据集总结
基本信息
- 数据集名称:Wyoming Case Law
- 数据集地址:https://huggingface.co/datasets/docketx/us-caselaw-wy
- 许可证:CC0 1.0
- 语言:英语(en)
- 任务类别:文本检索(text-retrieval)、文本生成(text-generation)
- 数据规模:10K < n < 100K
- 标签:legal、law、caselaw、wyoming、us-law、state-law、court-opinions、public-domain、rag、retrieval、legal-nlp、legal-research
数据集内容
- 包含来自公共记录的 16,358 份怀俄明州上诉法院意见书全文文档。
- 数据切取自 Free Law Project / CourtListener 于 2026-06-30 发布的批量导出数据。
- 法院覆盖范围:1 个法院 id,采用显式允许列表(非前缀匹配):
wyo。 - 包含主意见书和单独意见书;排除少于 1 个字符的文档。
- 切片 sha256 值为
e713201b5a9c8ea78c26c1c58c056e77e35b18e773b96c61f21ef34e812663a9(也记录于slice.manifest.json)。
数据构成
在此切片上实测:
- 15,317 份文档(93.6%)包含 2,000 字符以上的文本。
- 943 份文档(5.8%)包含 200 至 1,999 字符。
- 98 份文档(0.6%)少于 200 字符。
短文档是真实记录而非错误,例如调卷令驳回、单行命令和判决登记条目。这些文档被有意保留(min_chars = 1),以保证这是完整的公共记录而非经过筛选的子集。如需仅保留实质性意见书,可按 len(text) 进行过滤。
数据格式
- 每行遵循 docketx record v1 格式(每行一条意见书)。
- 字段包括:
id、doc_type、jurisdiction、title、text、source、license、retrieved_at,以及citation、court、date和extra(包含 CourtListener 意见/集群 id、意见类型)。 - 所有 docketx 数据集均使用相同格式。
来源与许可
- 司法意见书属于政府法令,为不可享有著作权的公共领域作品(依据 Banks v. Manchester, 128 U.S. 244 (1888);Georgia v. Public.Resource.Org, 590 U.S. 255 (2020))。
- 本数据打包以 CC0 1.0 发布。
- 来源:CourtListener 批量导出(2026-06-30),Free Law Project — https://free.law。
- 本数据集重新分发公共领域法院文本,不添加任何标注,也不主张任何权利。
加载方式
python from datasets import load_dataset ds = load_dataset("docketx/us-caselaw-wy")
所属项目
属于 DocketRouter 法律语料库的一部分:https://huggingface.co/docketx