
遇见数据集

univer-api-sft

收藏
Hugging Face2026-02-05 更新2026-02-07 收录
官方服务:

资源简介:

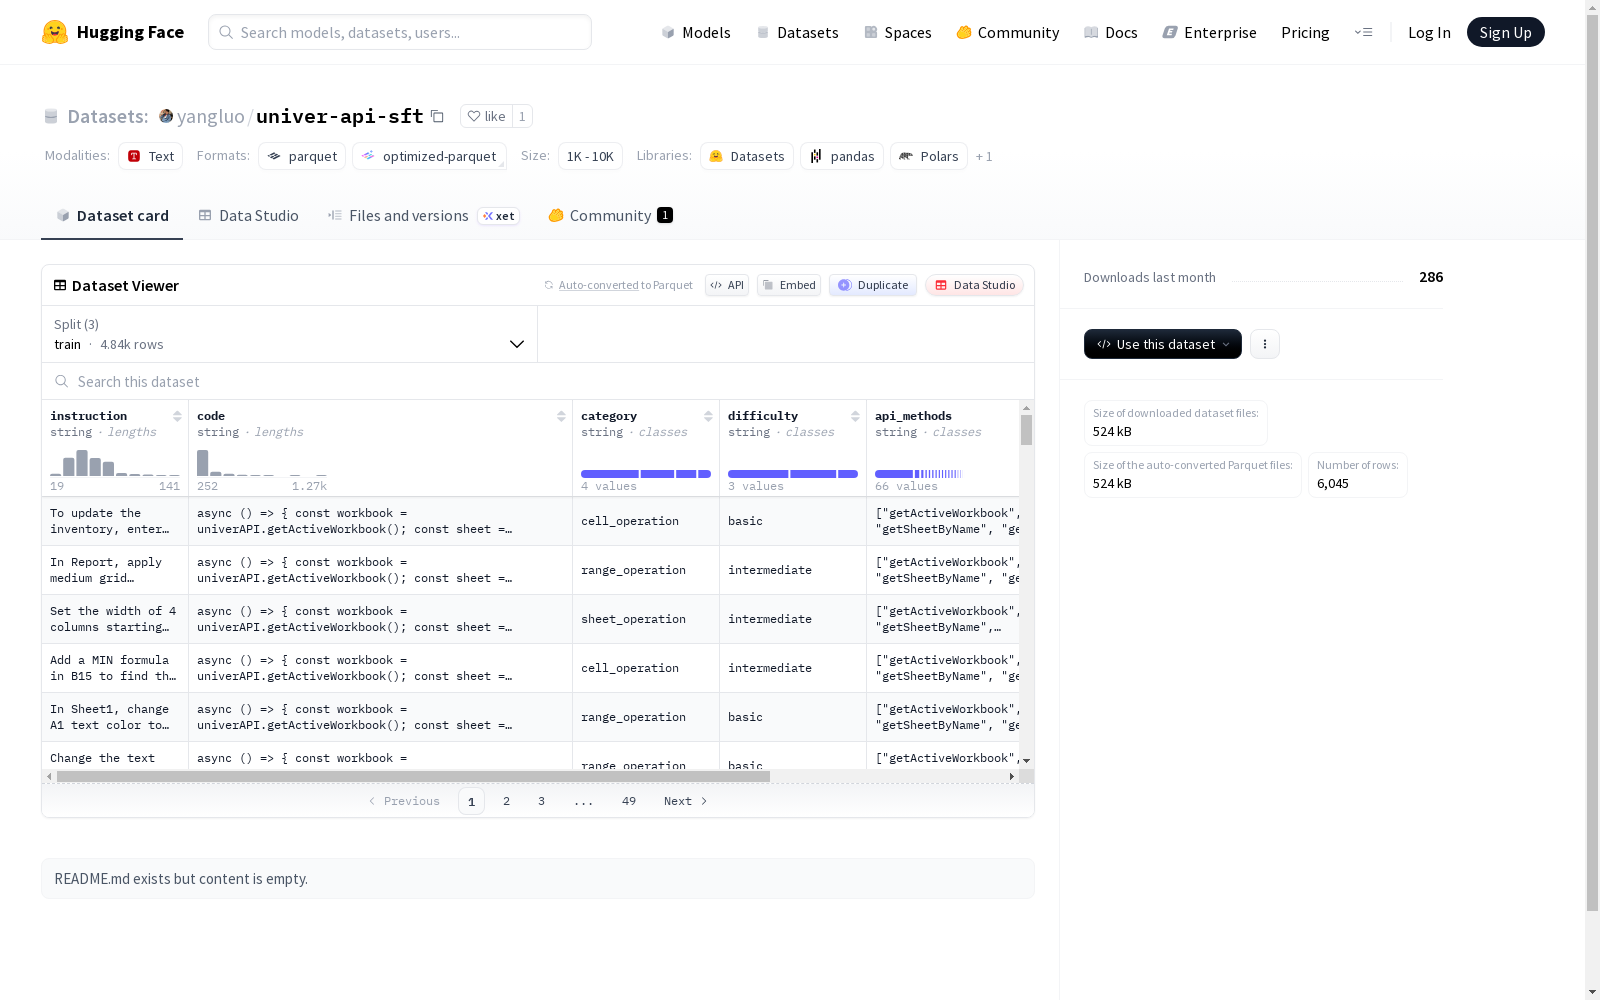
该数据集包含编程相关任务的指令-代码对,共5,685个样本(训练集4,548例,验证集568例,测试集569例)。每条数据包含六个字段:自然语言指令(instruction)、对应代码(code)、任务类别(category)、难度等级(difficulty)、涉及的API方法(api_methods)以及唯一任务ID(task_id)。数据总量约3MB,以纯文本形式存储,按标准机器学习流程划分为训练/验证/测试集。虽然未明确说明应用场景,但数据结构表明其适用于代码生成、程序合成或AI编程助手等NLP任务。

This dataset contains instruction-code pairs for programming-related tasks, with a total of 5,685 samples: 4,548 for the training set, 568 for the validation set, and 569 for the test set. Each sample includes six fields: natural language instruction (`instruction`), corresponding code (`code`), task category (`category`), difficulty level (`difficulty`), involved API methods (`api_methods`), and unique task ID (`task_id`). The total size of the dataset is approximately 3 MB, stored in plain text format, and split into training, validation and test sets following standard machine learning workflows. Although the application scenarios are not explicitly specified, the data structure indicates that it is suitable for NLP tasks such as code generation, program synthesis, or AI programming assistants.
创建时间:
2026-02-02
搜集汇总
数据集介绍
univer-api-sft 数据集图片
构建方式
在人工智能与软件工程交叉领域,univer-api-sft数据集通过系统化采集与标注构建而成。该数据集聚焦于API使用场景,从开源代码库与开发者文档中提取真实编程任务,涵盖多种编程语言与框架。每条数据均包含自然语言指令、对应代码实现、任务类别、难度分级、涉及的API方法及唯一任务标识,确保了数据来源的多样性与任务场景的真实性。数据集按标准划分为训练、验证与测试子集,为模型训练与评估提供了结构化基础。
特点
univer-api-sft数据集展现出多维度特性,其核心在于紧密融合自然语言指令与代码生成。数据集覆盖广泛的任务类别与难度层次,从基础函数调用到复杂API集成,均配有详细的元数据标注,如API方法列表与任务ID,便于细粒度分析与模型调试。数据规模适中,兼顾质量与多样性,为研究代码生成、API理解及指令跟随任务提供了丰富且可靠的语料资源。
使用方法
该数据集适用于代码生成与API理解模型的监督微调。研究人员可加载标准数据分割,利用instruction字段作为输入,code字段作为目标输出,进行端到端训练。类别与难度标签支持分层评估或偏差分析,而api_methods字段有助于探究模型对特定API的掌握程度。验证集与测试集为模型性能提供了客观衡量基准,推动其在真实编程辅助场景中的应用与优化。
背景与挑战
背景概述
随着人工智能技术的迅猛发展,大型语言模型在代码生成与理解领域展现出巨大潜力。univer-api-sft数据集应运而生,专注于API指令微调任务,旨在提升模型对复杂编程接口的响应能力。该数据集由研究团队精心构建,涵盖了多样化的编程场景与难度层次,其核心研究问题在于如何通过结构化数据训练,使模型能够准确理解自然语言指令并生成相应的API调用代码。这一努力不仅推动了代码智能辅助工具的发展,也为自动化软件开发提供了关键的数据支撑,对促进编程教育、软件工程优化及智能开发环境构建产生了深远影响。
当前挑战
在代码生成领域,模型需克服自然语言指令与精确API调用之间的语义鸿沟,确保生成的代码既符合语法规范又能正确实现功能意图。univer-api-sft数据集针对此挑战,要求模型处理多类别、多难度的编程任务,同时准确整合指定的API方法。构建过程中,数据收集面临标注一致性难题,需确保指令与代码对的准确对应,并平衡不同难度与类别的样本分布。此外,API的多样性与快速演进特性,使得数据集需持续更新以保持时效性,这对数据维护与扩展提出了较高要求。
常用场景
经典使用场景
在软件工程与人工智能交叉领域,API(应用程序编程接口)的智能理解与生成已成为提升开发效率的关键。univer-api-sft数据集通过提供涵盖多种编程任务的自然语言指令与对应代码示例,为模型训练提供了丰富的监督信号。该数据集最经典的使用场景在于支持大型语言模型进行指令微调,使其能够准确解析用户需求并生成符合规范的API调用代码,从而在代码补全、自动化编程等任务中展现卓越性能。
实际应用
在实际开发环境中,univer-api-sft数据集能够直接赋能智能编程助手工具的构建。基于该数据集训练的模型可集成至集成开发环境(IDE)或代码管理平台,为开发者提供实时、准确的API使用建议与代码片段生成。这不仅显著降低了编码过程中的记忆负担与手动查找文档的时间成本,还有助于减少因API误用而引发的潜在错误,从而在软件维护、快速原型开发及教育辅助等场景中产生切实的生产力提升。
衍生相关工作
围绕univer-api-sft数据集,学术界与工业界已衍生出一系列经典研究工作。这些工作主要集中于探索更高效的指令微调策略、设计针对代码语义的特定模型架构,以及开发基于检索增强的代码生成框架。部分研究进一步利用该数据集的难度分级与类别标签,深入分析了模型在不同复杂度编程任务上的性能边界,为代码智能领域的评估基准与模型优化方向提供了重要参考依据。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

