
遇见数据集

acqad-rag-cag-subsets

收藏
Hugging Face2026-07-19 更新2026-07-20 收录
官方服务:

资源简介:

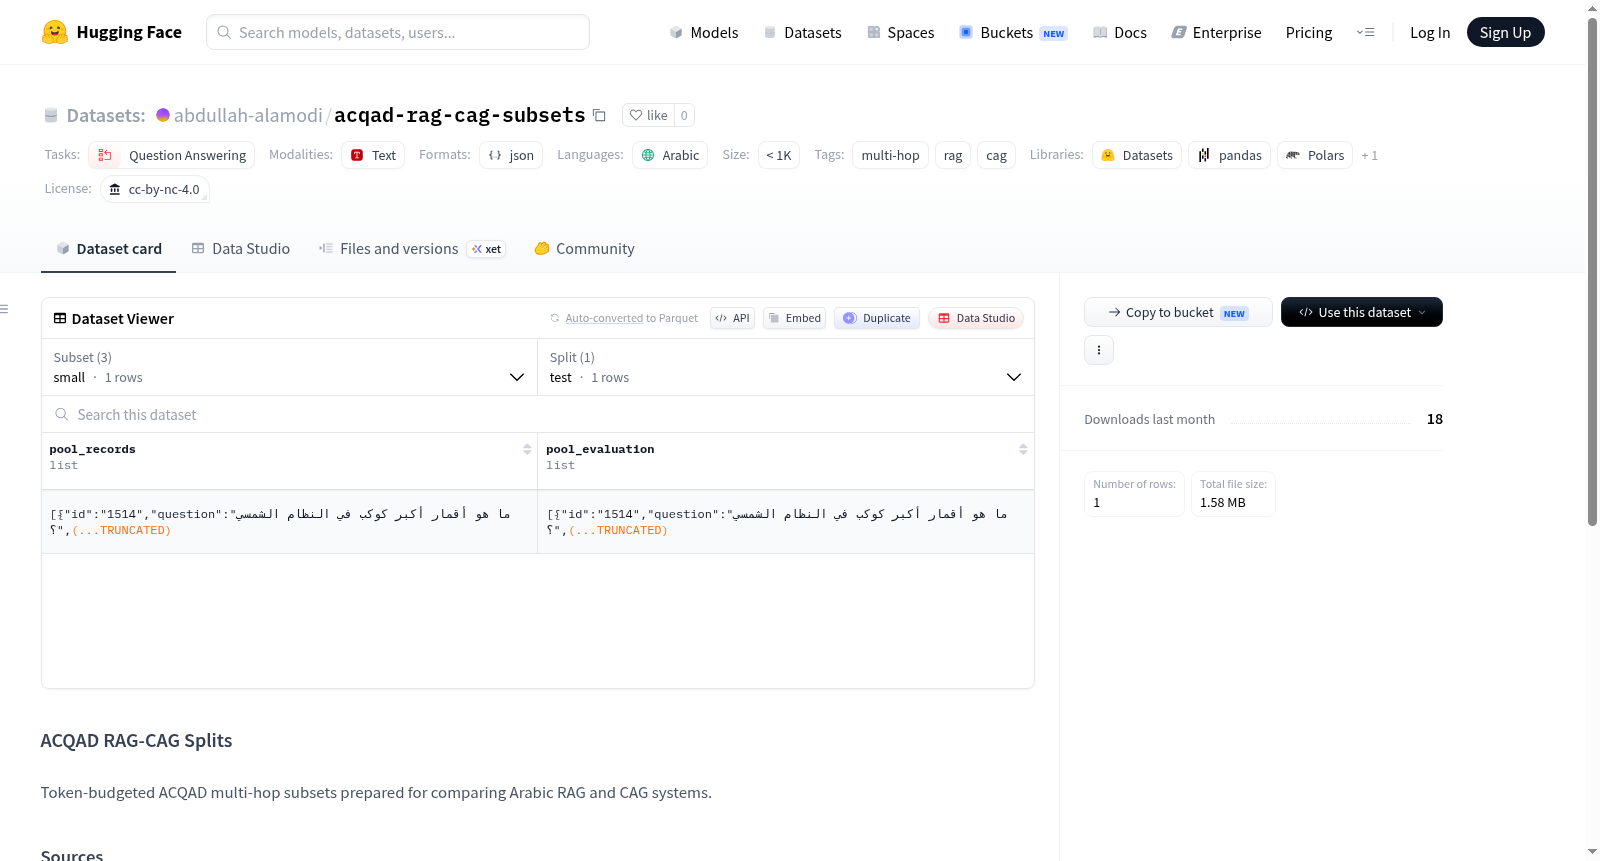
ACQAD RAG-CAG Splits 是一个专门为比较阿拉伯语检索增强生成(RAG)和上下文感知生成(CAG)系统而构建的评估数据集。它基于 ACQAD 原始数据集,经过处理生成了三个不同规模(small, medium, large)的多跳问答(multi-hop QA)子集。这些子集在构建时考虑了 Token 预算限制,旨在用于评估相关系统在阿拉伯语多跳问答任务中的答案生成质量以及在线推理延迟。数据集仅包含测试集,适用于问答任务类别,尤其关注多跳推理场景。

ACQAD RAG-CAG Splits is an evaluation dataset specifically constructed for comparing Arabic Retrieval-Augmented Generation (RAG) and Context-Aware Generation (CAG) systems. It is based on the original ACQAD dataset and has been processed to generate three subsets of different scales (small, medium, large) for multi-hop question answering (multi-hop QA). These subsets are built with consideration of Token budget constraints, aiming to evaluate the answer generation quality and online inference latency of relevant systems in Arabic multi-hop QA tasks. The dataset includes only a test set and is suitable for the question-answering task category, with a particular focus on multi-hop reasoning scenarios.

创建时间:
2026-07-15
原始信息汇总

数据集名称

ACQAD RAG-CAG Splits

语言

  • 阿拉伯语 (ar)

任务类别

  • 问答 (question-answering)

标签

  • 多跳 (multi-hop)
  • 检索增强生成 (RAG)
  • 缓存增强生成 (CAG)

许可协议

  • CC BY-NC 4.0 (非商业使用)

数据集简介

该数据集是基于 ACQAD 多跳问答数据集,按 token 预算划分的子集,专门用于对比阿拉伯语 RAG 与 CAG 系统的性能。

数据集配置与文件

该数据集包含三个配置,每个配置仅包含 test 分割:

配置名称 默认 文件路径
small 是 (default) acqad_multihop_small.json
medium acqad_multihop_medium.json
large acqad_multihop_large.json

来源

用途

用于评估阿拉伯语多跳问答任务中,RAG 和 CAG 系统的答案质量及在线延迟。

相关代码
Abdullah-Alamodi/rag-vs-cag

搜集汇总
数据集介绍
acqad-rag-cag-subsets 数据集图片
构建方式
该数据集基于ACQAD原始语料进行精心筛选与重构,以token预算为约束机制,生成了针对阿拉伯语多跳问答场景的三种子集规模——small、medium与large。每个子集均以JSON格式独立存储,专为对比检索增强生成与缓存增强生成系统的性能而设计,确保评估过程具备可控的实验变量与一致的推理复杂度。
特点
数据集的核心特色在于其多跳推理属性与阿拉伯语特定语言适配性,结合分层预算分配策略实现了从轻量到高负载的渐进式评估。各子集在保持问题-上下文语义完整的前提下,灵活调节文档长度与推理步数,为系统响应质量与在线延迟提供多维度的衡量基准,弥补了该领域阿拉伯语标准化评测数据的稀缺。
使用方法
用户可通过HuggingFace Datasets库直接加载各配置子集,例如指定config_name参数获取small、medium或large版本。数据集预置统一的test分割,便于直接用于模型推理能力的评测实验,并配合配套代码仓库(rag-vs-cag)开展端到端的RAG与CAG性能对比分析,计算准确率与响应时间等关键指标。
背景与挑战
背景概述
ACQAD(Arabic Complex Question Answering Dataset)是一个专为阿拉伯语多跳问答任务设计的数据集,由Abdullah Alamodi等研究者于近期构建并发布,旨在填补阿拉伯语复杂推理问答领域的资源空白。该数据集源于对阿拉伯语自然语言处理中高阶语义理解需求的深刻洞察,尤其在检索增强生成(RAG)与缓存增强生成(CAG)系统的对比评估中扮演关键角色。ACQAD通过集成来自Hugging Face和Kaggle等平台的权威语料,聚焦于需要跨文档推理的多跳问题,为阿拉伯语机器阅读理解和智能问答系统提供了标准化的测试基准,对推动低资源语言在对话式AI和知识图谱领域的深度研究具有显著影响力。
当前挑战
该数据集所解决的领域核心挑战在于阿拉伯语多跳问答中复杂推理与效率的平衡问题。具体而言,阿拉伯语因其形态丰富、语序灵活及歧义性强,使得传统单跳模型难以处理需要跨句子或跨文档整合信息的查询,而RAG和CAG系统在检索噪声过滤、上下文窗口限制与在线延迟之间存在固有矛盾。构建过程中,研究者面临三重挑战:一是从海量阿拉伯语文本中精确标注多跳推理路径,确保问题与证据链的语义一致性;二是设计可扩展的预算化子集划分方案,以适配不同计算资源下的实验需求;三是在保持数据多样性的前提下,避免因简化推理步骤而引入偏见,从而保障评估的公平性与鲁棒性。
常用场景
经典使用场景
在阿拉伯语自然语言处理领域,多跳问答任务因其对复杂推理与信息整合能力的高要求而备受关注。ACQAD-RAG-CAG子集专为评估和比较检索增强生成(RAG)与缓存增强生成(CAG)系统在阿拉伯语多跳问答上的表现而设计,其核心用途在于提供不同token预算下的标准测试集。研究者通过small、medium、large三种规模的数据子集,系统性地衡量各系统在回答质量与在线延迟之间的权衡,从而揭示不同资源配置下生成模型的性能差异。
衍生相关工作
基于ACQAD-RAG-CAG子集,学者们已衍生出多项经典工作,包括面向阿拉伯语的多跳RAG检索器优化,以及针对CAG的缓存策略压缩与动态更新机制。例如,相关研究提出了基于子集规模自适应的延迟感知路由算法,能够根据查询复杂度在RAG与CAG之间动态切换。此外,该数据集还被用于训练轻量级阿拉伯语评分模型,实现无需人工标注的系统自动评估。这些工作共同构建了一个从基准测试到系统优化再到自动评价的完整研究链条,极大地促进了阿拉伯语问答技术的工程落地与社区繁荣。
数据集最近研究
最新研究方向
该数据集专为阿拉伯语多跳问答场景设计,聚焦检索增强生成(RAG)与缓存增强生成(CAG)在token预算约束下的对比研究。当前前沿方向集中于评估不同规模子集在阿拉伯语多跳推理任务中的答案质量与在线延迟权衡,尤其是CAG通过预检索并缓存关键上下文以减少实时检索开销的范式。这一方向与阿拉伯语NLP领域对高效知识密集型系统的迫切需求紧密相关,尤其是在低资源语言环境下,CAG凭借其低延迟特性为实时应用落地提供新路径,其研究对推动多语言、多跳推理系统的实用化具有标杆意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务


