
遇见数据集

x_dataset_178

收藏
Hugging Face2025-03-24 更新2025-03-25 收录
官方服务:

资源简介:

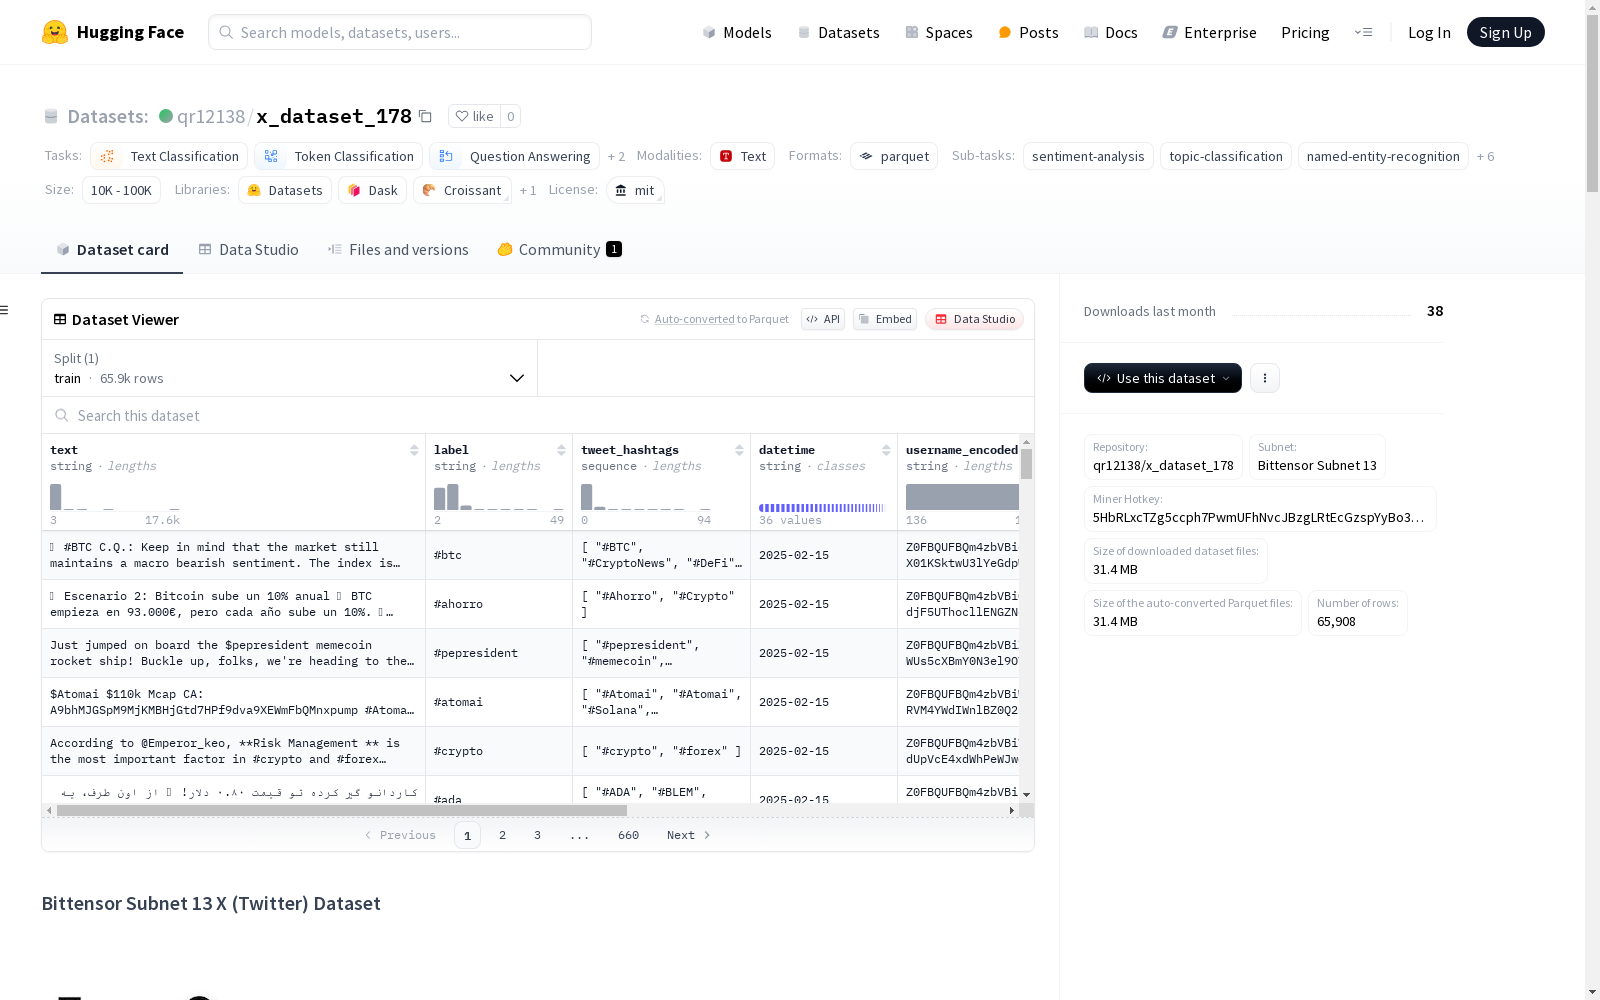
Bittensor Subnet 13 X (Twitter) 数据集是Bittensor Subnet 13去中心化网络的一部分,包含来自X(前Twitter)的预处理后的实时推文数据流。这个数据集适用于多种分析和机器学习任务,如情感分析、趋势检测、内容分析和用户行为建模等。数据集以英语为主,但也可能包含多语言内容。每个数据实例包含推文文本、情感或话题标签、话题标签列表、发布日期、编码后的用户名和URL等。由于数据集持续更新,用户需要根据需求和时间戳自行创建数据拆分。

The Bittensor Subnet 13 X (Twitter) Dataset is part of the decentralized Bittensor Subnet 13 network, comprising preprocessed real-time tweet data streams sourced from X (formerly Twitter). This dataset supports a wide range of analytical and machine learning tasks, including sentiment analysis, trend detection, content analysis, user behavior modeling, and more. The dataset is primarily in English, but may also contain multilingual content. Each data instance includes tweet text, sentiment or topic tags, a list of hashtags, publication date, encoded usernames, URLs, and other relevant fields. As the dataset is continuously updated, users should independently create data splits based on their specific requirements and timestamps.
创建时间:
2025-03-22
搜集汇总
数据集介绍
x_dataset_178 数据集图片
构建方式
在社交媒体分析领域,x_dataset_178数据集通过Bittensor Subnet 13去中心化网络构建,采用实时更新的方式采集X平台(原Twitter)的公开推文数据。数据采集严格遵循平台服务条款与API使用规范,所有用户信息均经过编码处理以保护隐私,确保数据来源的合规性与安全性。该数据集采用动态更新机制,由网络矿工持续维护,形成具有时效性的社交媒体数据流。
特点
作为多任务适配的社交媒体数据集,x_dataset_178涵盖文本分类、实体识别等多样化NLP任务需求。其核心特征体现在动态更新的时间跨度(2021-2025)、多语言混合内容以及完整的元数据结构,包含推文文本、情感标签、时间戳等关键字段。值得注意的是,数据集通过哈希值转换技术处理用户敏感信息,在保持数据可用性的同时满足隐私保护要求,且包含6.93%含标签数据,为研究社交媒体的语义特征提供丰富素材。
使用方法
研究者可通过HuggingFace平台直接加载该数据集,建议根据时间戳字段划分训练验证集以适配时序分析需求。针对不同任务场景,可分别调用text字段进行文本生成研究,利用label字段开展情感分析,或结合tweet_hashtags实现话题检测。使用时应充分考虑社交媒体的固有偏差,建议配合数据统计文件(stats.json)分析数据分布特征,并遵循MIT许可条款及X平台使用规范。对于持续研究需求,可通过Bittensor子网机制获取实时数据更新。
背景与挑战
背景概述
Bittensor Subnet 13 X (Twitter) Dataset是由Bittensor Subnet 13去中心化网络于2025年推出的多语言社交媒体数据集,旨在为研究人员提供实时更新的推特数据流。该数据集由网络矿工持续更新,覆盖了2021年至2025年的推文,包含120余万条实例,主要应用于文本分类、情感分析、命名实体识别等多种自然语言处理任务。作为去中心化数据采集的典型案例,该数据集不仅为社交网络动态研究提供了丰富素材,也为加密货币、国际政治等热点话题的追踪分析奠定了数据基础。其创新性的分布式采集模式,体现了Web3.0时代数据生产范式的转变。
当前挑战
该数据集面临的核心挑战主要体现在两个方面:领域问题层面,社交媒体数据固有的噪声和偏见对情感分析、趋势检测等任务的准确性构成挑战,特别是话题分布的不均衡性(如#bitcoin标签占比6.93%)可能影响模型泛化能力;构建过程层面,去中心化采集机制导致数据质量波动,仅5.45%推文含标签信息,且时间跨度带来的概念漂移现象需要特殊处理。隐私保护要求下的用户名编码策略,虽符合伦理规范,但增加了用户行为连续性研究的难度。实时更新特性虽具时效优势,却使数据分布动态变化,对模型持续学习提出更高要求。
常用场景
经典使用场景
在社交网络分析领域,x_dataset_178数据集以其丰富的文本内容和结构化字段,成为研究社交媒体动态的宝贵资源。该数据集特别适用于情感分析和主题分类任务,能够帮助研究者深入理解公众情绪和社会话题的演变趋势。通过分析推文中的文本内容和标签,研究者可以揭示不同时间点上的舆论走向和热点话题。
解决学术问题
x_dataset_178数据集为学术界提供了解决社交媒体数据稀疏性和时效性问题的有效工具。其覆盖的时间跨度和多语言特性,使得研究者能够探索跨文化传播模式和语言使用差异。数据集中的编码字段设计,既保护了用户隐私,又为行为建模研究提供了可能,填补了社交网络分析中数据可用性与隐私保护之间的空白。
衍生相关工作
基于x_dataset_178数据集,已衍生出多项具有影响力的研究工作。其中包括开发新型的实时情感分析算法、构建跨语言话题检测模型,以及探索去中心化数据采集框架的可行性。这些工作不仅推动了自然语言处理技术的发展,也为社交媒体分析提供了新的方法论。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

