
disco-eth/cineaudiosynth
收藏官方服务:
资源简介:
用于源分离的合成电影音频。包含453个场景,约22.8小时,48 kHz / 16位 / 立体声WAV格式。
Synthetic cinematic audio for source separation. 453 scenes, ~22.8 h, 48 kHz / 16-bit / stereo WAV.
提供机构:
disco-eth搜集汇总
数据集介绍
构建方式
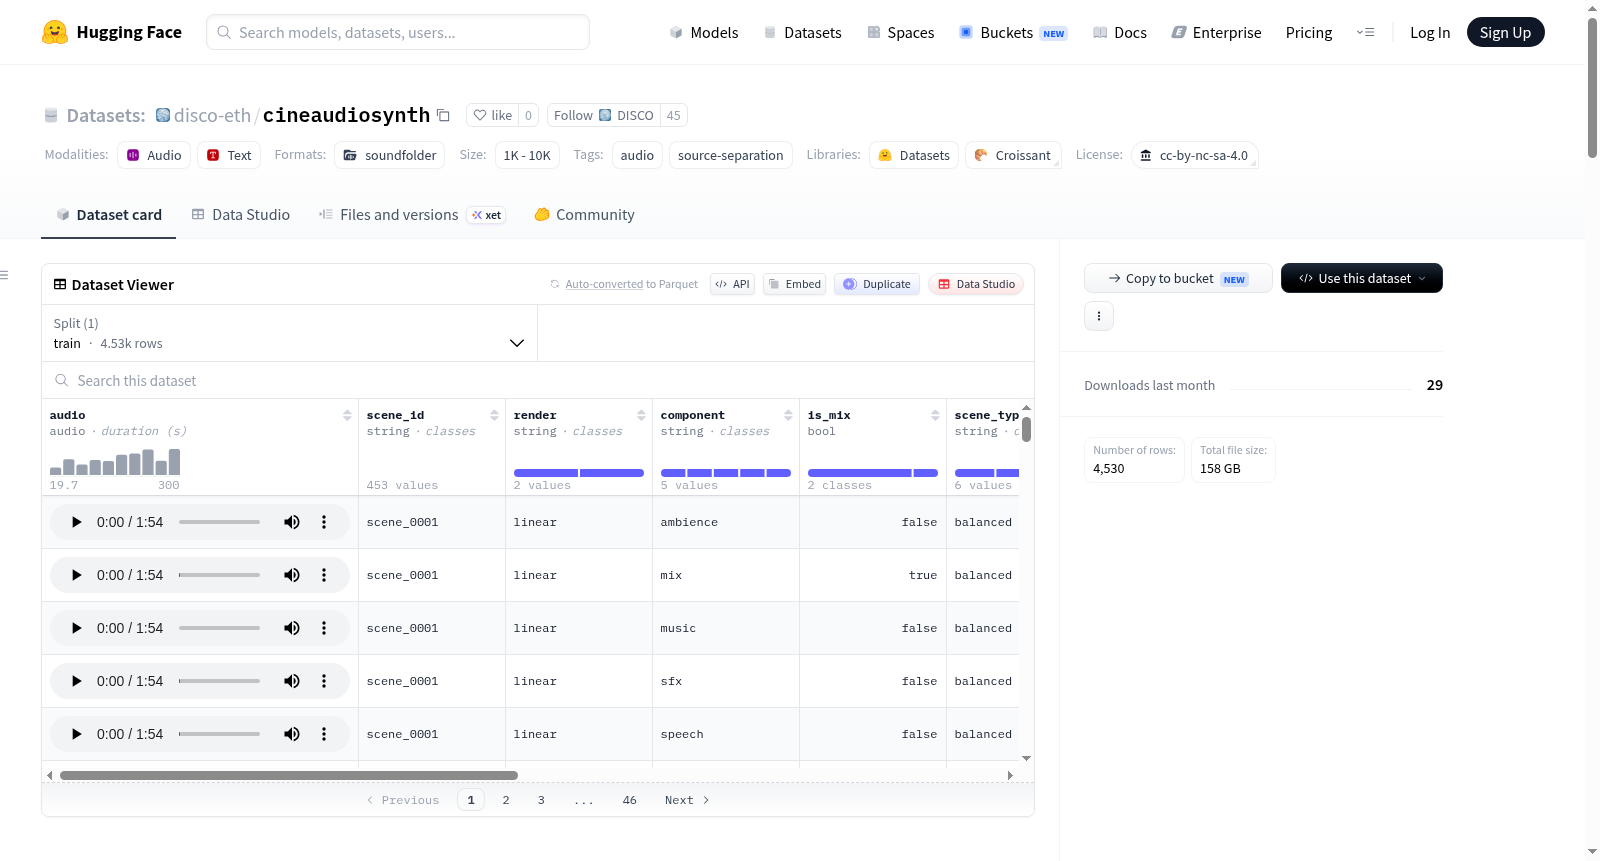
CineAudioSynth是一个面向影视音频源分离任务的高保真合成数据集,基于CineAudioGen管线构建,涵盖453个精心编排的场景,累计约22.8小时,全部以48 kHz采样率、16比特深度和立体声格式存储。每个场景均包含两种渲染形式:线性渲染(linear)确保混合音频为四条独立音轨(对白、音乐、环境音、音效)的逐位精确累加,经严格验证误差为零;母带渲染(release)则在总线上施加压缩、限幅和响度处理,呈现非可加性的影视级成品效果。同时提供侧链压缩包络增益文件(gain_envelope.json)及详尽的场景元数据(场景类型、DSP参数、音效事件时间戳与描述、响度指标、可加性验证结果),为研究者提供了高度可控且具备真实影视混音逻辑的实验素材。
特点
该数据集最显著的特征在于其双轨渲染体系与严格的可加性保障。线性渲染分支中,混合音频与四轨茎信号之间保持数学上的精确可加关系,为监督式源分离算法提供了零误差的理想训练目标。母带渲染则模拟真实后期制作流程,呈现非线性的动态处理结果,适合评测模型在实际制作场景中的泛化能力。元数据体系丰富而结构化,涵盖场景类型(如对话密集、均衡等)、音乐标签、环境音线索及音效事件序列,支持细粒度的条件筛选与场景级实验设计。数据集规模适中,兼顾了模型训练的数据多样性与实验管理的便捷性,且所有音频文件均保持一致的时长与编码参数。
使用方法
研究者可通过Hugging Face Datasets库直接加载数据集,利用内置的audiofolder元数据清单(metadata.csv)实现高效的数据索引与筛选。该清单以每行对应一个音频文件的形式提供场景ID、渲染类型、音频组件、场景类别等列信息,支持基于列值的过滤操作,例如仅提取对话密集型场景的线性渲染茎信号。对于大规模实验,建议采用流式加载模式(streaming=True)以绕过约158 GB的完整下载。也可通过Hugging Face Hub的snapshot_download或hf_hub_download函数选择性获取完整数据集或特定场景文件。加载后,可使用soundfile等库读取WAV音频数组,结合元数据中的响度指标与事件时间戳进行自定义分析与模型评估。
背景与挑战
背景概述
在影视音频处理领域,音源分离(source separation)是提升后期制作效率与质量的关键技术,旨在从混合音频中精准提取语音、音乐、环境声及特效等独立成分。现有数据集多聚焦于音乐或日常环境音,缺乏针对电影场景的专业化、多成分标注资源。CineAudioSynth数据集由瑞士联邦理工学院(ETH Zurich)的研究团队于近年创建,核心研究问题在于为影视级音源分离提供合成但高度拟真的训练与评估基准。该数据集包含453个场景、约22.8小时、48kHz/16-bit立体声录音,创新性地提供线性可加(additive)和母带处理(mastered)两种渲染模式,前者确保混合声与各声轨之和严格一致,后者模拟真实后期制作的动态处理,从而支持对分离算法在理想与真实条件下的对比研究。其发布填补了影视音频合成数据集的空白,对推动音源分离技术在专业影视制作领域的应用具有重要影响力。
当前挑战
该数据集所解决的领域问题在于,现有音源分离方法在影视混合音频中常因复杂的声学场景(如背景音乐与对白的频率重叠、环境声的非平稳特性)而性能受限,CineAudioSynth通过提供多元化的场景类型与精确的标注,为算法鲁棒性评估提供了标准化测试平台。在构建过程中面临的核心挑战包括:确保线性渲染中四个声轨(语音、音乐、环境声、特效)的比特精确可加性,需在16-bit整数域验证每场景最大误差为零;母带渲染需模拟真实的压缩、限幅及响度处理,同时保持场景一致性,这对数字信号处理链的精度与稳定性提出高要求。此外,多源素材(如来自Expresso、FSD50K等库的语音、音效)的版权兼容性管理极为复杂,需在CC BY-NC-SA 4.0协议下保证每段音频的归属标注清晰,且禁止将独立声轨作为单独作品重新发布,这要求数据集构建中严格遵守开源性合规与元数据追踪。
常用场景
经典使用场景
CineAudioSynth作为面向影视音频源分离任务的合成数据集,其经典使用场景集中在监督式多音源分离模型的训练与评估。该数据集提供了453个电影场景、约22.8小时的48kHz/16-bit立体声WAV素材,每个场景包含语音、音乐、环境音和特效音四种独立音轨及其线性混合音频,且混合音频与各音轨之和达到比特级精确相等。研究者可直接利用mix.wav作为输入、四个stem作为目标标签,训练深度神经网络以分离影视音频中的不同成分。线性渲染分支保证了混合与分离过程的可逆性,使得模型能够学习到精确的映射关系。此外,数据集还提供了经过母带处理的release分支,允许研究人员评估模型在真实影视后期处理环境下的鲁棒性。
实际应用
在实际应用层面,CineAudioSynth为影视后期制作、虚拟现实音频处理、辅助听觉设备等前沿领域提供了关键的数据基础设施。电影与电视剧的后期配音、音效替换与混音工作通常需要将原始录音中的不同声音成分分离处理,该数据集训练出的分离模型可以直接应用于影视制作管线,实现智能化音轨编辑。对于虚拟现实与增强现实场景,能够将环境音与对话分离也意味着用户可根据需求调整不同声源的音量比例。此外,在助听器与听觉辅助技术中,从嘈杂影视音频中提取清晰语音的技术可显著改善听障用户的观影体验。这些实际应用场景都高度依赖于基于CineAudioSynth训练的源分离模型所提供的精准分离能力。
衍生相关工作
CineAudioSynth作为标杆性影视音频数据集,已催生了一系列经典学术工作。在源分离领域,研究者基于该数据集开发了针对影视场景优化的一步式分离架构,如CineSepNet利用场景元数据引导分离过程,实现了对语音与音乐信号的高效分离。在弱监督学习方向上,有工作利用线性混合的比特级精确特性设计了解耦表征学习框架,使得模型在没有显式源标签的情况下也能学习到分离能力。此外,该数据集的多维度元数据(场景类型、特效事件时间戳、响度指标)也激发了场景理解与音频事件检测的交叉研究,推动了知识引导型音频分析方向的发展。这些衍生工作共同构筑了以CineAudioSynth为核心的研究生态,持续推动着影视音频智能处理技术的边界。
以上内容由遇见数据集搜集并总结生成


