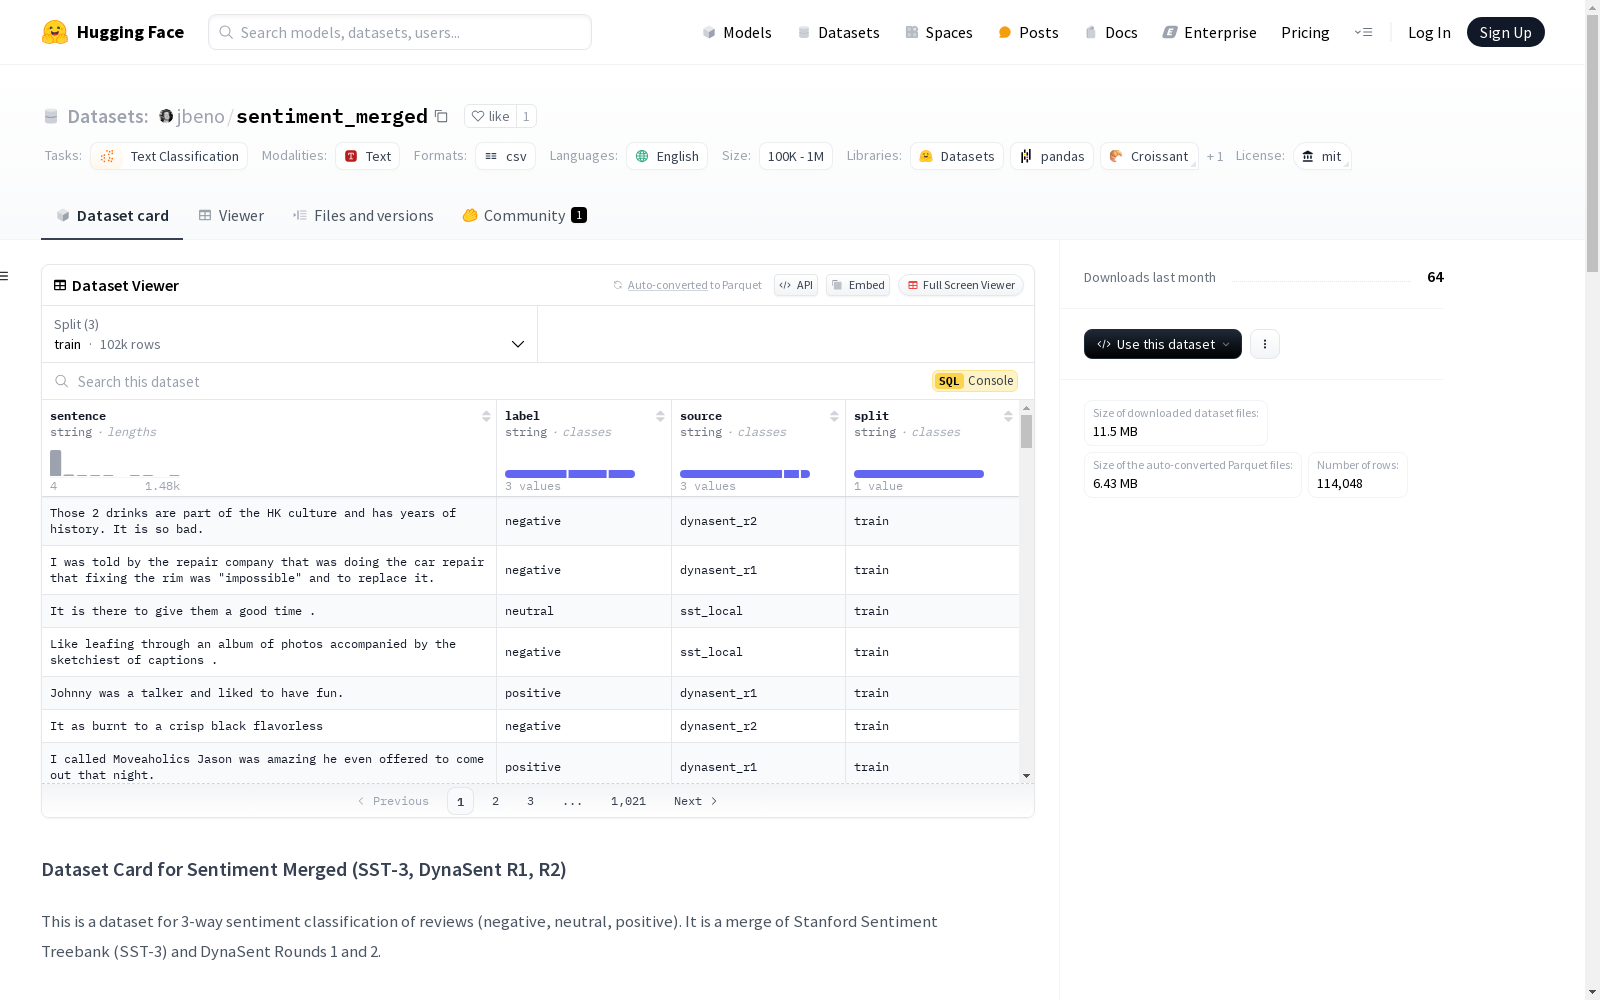
sentiment_merged
收藏资源简介:
这是一个用于3类情感分类的评论数据集(负面、中性、正面),由斯坦福情感树库(SST-3)和DynaSent第一轮和第二轮数据集合并而成。该数据集包含102,097个训练样本、5,421个验证样本和6,530个测试样本。数据集主要使用英语,并采用MIT许可证。数据集的合并有助于缓解源数据集中存在的类别不平衡问题。该数据集旨在用于情感分类模型的微调任务。
This is a comment dataset for 3-class sentiment classification (negative, neutral, positive), which is merged from the Stanford Sentiment Treebank (SST-3) and the first and second rounds of the DynaSent dataset. It contains 102,097 training samples, 5,421 validation samples, and 6,530 test samples. This dataset is primarily in English and released under the MIT License. The merging process helps alleviate the class imbalance issue present in the source datasets. This dataset is designed for fine-tuning sentiment classification models.
数据集卡片:Sentiment Merged (SST-3, DynaSent R1, R2)
概述
该数据集用于3类情感分类(负面、中性、正面)的评论分类任务。它是由斯坦福情感树库(SST-3)和DynaSent第1轮和第2轮数据集合并而成。
数据集详情
- 数据集大小:包含102,097个训练样本,5,421个验证样本,6,530个测试样本。
- 标签分布:
| 分割 | 负面 | 中性 | 正面 |
|---|---|---|---|
| 训练 | 21,910 | 49,148 | 31,039 |
| 验证 | 1,868 | 1,669 | 1,884 |
| 测试 | 2,352 | 1,829 | 2,349 |
- 数据源贡献:
| 数据集 | 样本数 | 百分比 (%) |
|---|---|---|
| DynaSent R1 训练 | 80,488 | 78.83 |
| DynaSent R2 训练 | 13,065 | 12.80 |
| SST-3 训练 | 8,544 | 8.37 |
| 总计 | 102,097 | 100.00 |
数据集描述
SST-3是由SST-5(5类分类:正面、有些正面、中性、有些负面、负面)简化而来,将“有些正面”合并为“正面”,“有些负面”合并为“负面”。
DynaSent是一个情感分析数据集和动态基准,包含正面、负面和中性三类标签。该数据集在两轮中创建,第一轮使用RoBERTa模型在多个数据集上微调,提取挑战性句子并由人工验证。第二轮使用新的RoBERTa模型在类似但不同的数据上训练,并通过DynaBench平台创建新的挑战性句子。
数据集结构
数据集包含三个CSV文件:train_all.csv、val_all.csv、test_all.csv,分别代表合并后的训练、验证和测试集。
| 列 | 描述 |
|---|---|
| sentence | 评论句子 |
| label | 类别标签:负面、中性或正面 |
| source | 数据源:sst_local, dyansent_r1, 或 dynasent_r2 |
| split | 分割:训练、验证或测试 |
数据集创建
创建动机
该数据集的创建旨在为情感分类任务微调模型,目标是创建一个具有挑战性评论的多样化3类情感分类数据集。
数据源
数据集卡片联系人