pinkelephant-llm-48b-sft-tokenized
收藏资源简介:
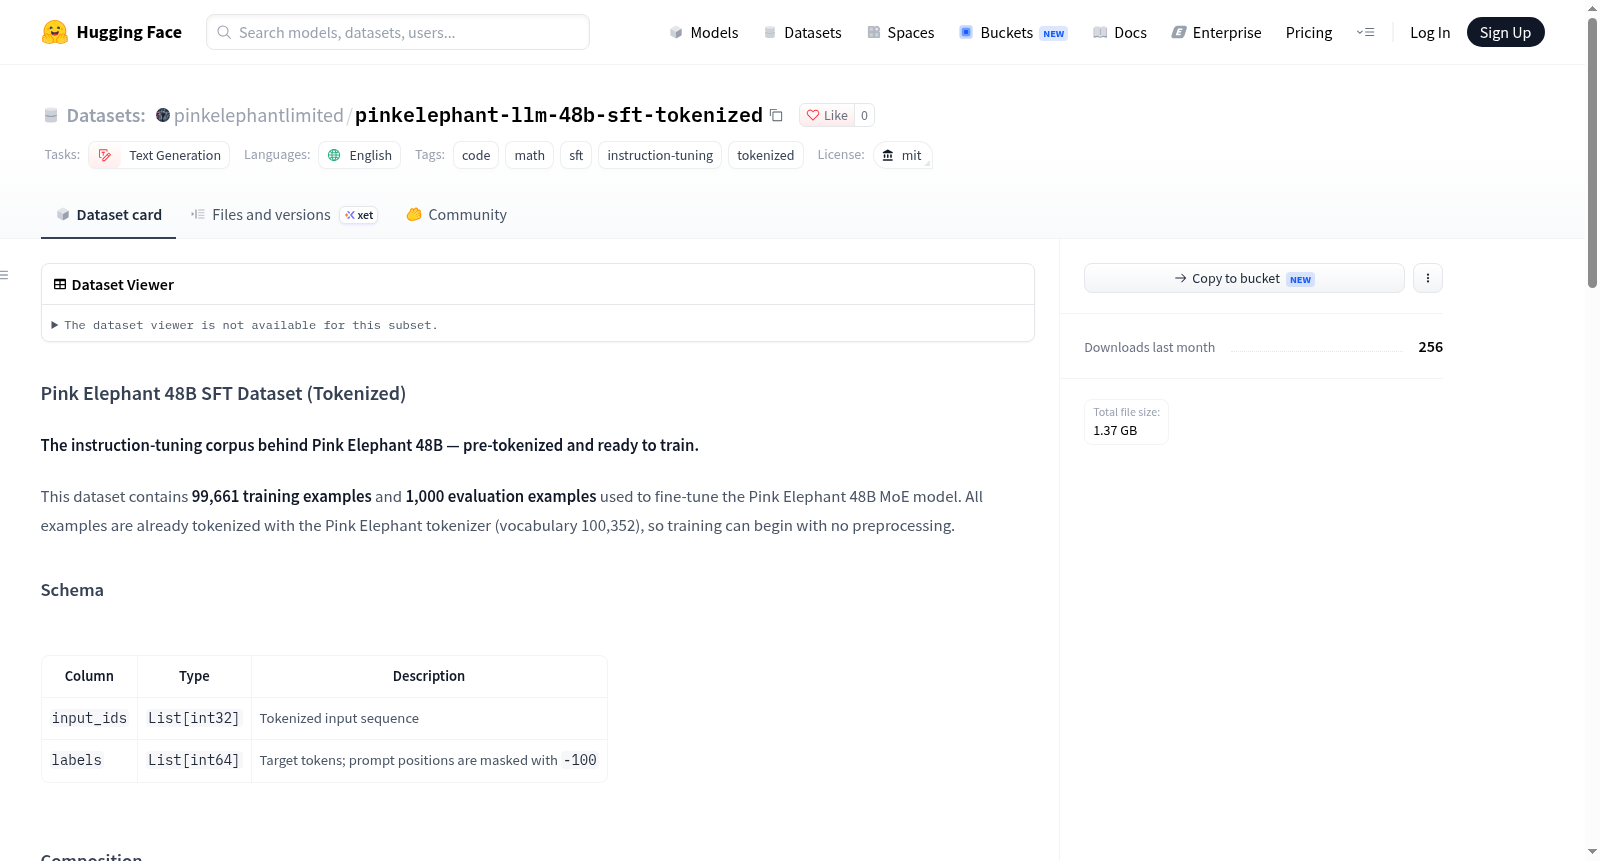
Pink Elephant 48B SFT数据集(Tokenized)是用于微调Pink Elephant 48B MoE模型的指令微调语料库,所有样本均已完成预分词处理,可直接用于训练。数据集包含99,661个训练样本和1,000个评估样本,使用Pink Elephant tokenizer(词表大小100,352)进行分词。每条样本包含两个字段:input_ids(List[int32]类型)为分词后的输入序列,labels(List[int64]类型)为目标标记,其中提示部分的位置被掩码为-100。数据构成来自两个公开许可的语料库:49,661条来自self-oss-instruct(sc2-exec)的可执行代码指令,以及50,000条来自OpenR1 Math的数学推理步骤解。数据集经过去重、固定种子随机打乱,并限制序列长度不超过2,048。数据集分为train(99,661条)和eval(1,000条)两个子集。该数据集适用于代码生成和数学推理等指令微调任务。
The Pink Elephant 48B SFT dataset (Tokenized) is an instruction fine-tuning corpus for fine-tuning the Pink Elephant 48B MoE model. All samples are pre-tokenized and ready for training. The dataset contains 99,661 training samples and 1,000 evaluation samples, tokenized using the Pink Elephant tokenizer (vocabulary size 100,352). Each sample contains two fields: input_ids (List[int32] type) is the tokenized input sequence, and labels (List[int64] type) are the target tokens, where the positions corresponding to the prompt are masked with -100. The data comes from two publicly licensed corpora: 49,661 executable code instructions from self-oss-instruct (sc2-exec) and 50,000 mathematical reasoning step solutions from OpenR1 Math. The dataset has been deduplicated, randomly shuffled with a fixed seed, and the sequence length is limited to no more than 2,048. The dataset is split into train (99,661 samples) and eval (1,000 samples) subsets. This dataset is suitable for instruction fine-tuning tasks such as code generation and mathematical reasoning.
Pink Elephant 48B SFT 数据集(已分词)
数据集概述
该数据集是用于微调 Pink Elephant 48B MoE 模型的指令微调语料库,所有样本已使用 Pink Elephant tokenizer(词表大小 100,352)完成分词处理,可直接用于训练,无需额外预处理。
数据集规模
- 训练样本:99,661 条
- 评估样本:1,000 条
- 数据划分:train(99,661 条)、eval(1,000 条)
数据结构
| 列名 | 类型 | 说明 |
|---|---|---|
input_ids |
List[int32] |
分词后的输入序列 |
labels |
List[int64] |
目标 token;提示部分位置以 -100 掩码 |
数据构成
| 来源 | 领域 | 样本数 |
|---|---|---|
self-oss-instruct (sc2-exec) |
带可执行解决方案的代码指令 | 49,661 |
| OpenR1 Math | 含逐步解答的数学推理 | 50,000 |
| 总计 | 99,661 |
数据来源
数据集基于两个公开、许可宽松的语料库构建,经过去重、固定种子洗牌,并以序列长度 ≤ 2,048 进行分词。原始提示和解答可从 bigcode/self-oss-instruct 和 open-r1/OpenR1-Math 源项目获取。
许可证
MIT 许可证。