kichwa-spanish
收藏资源简介:
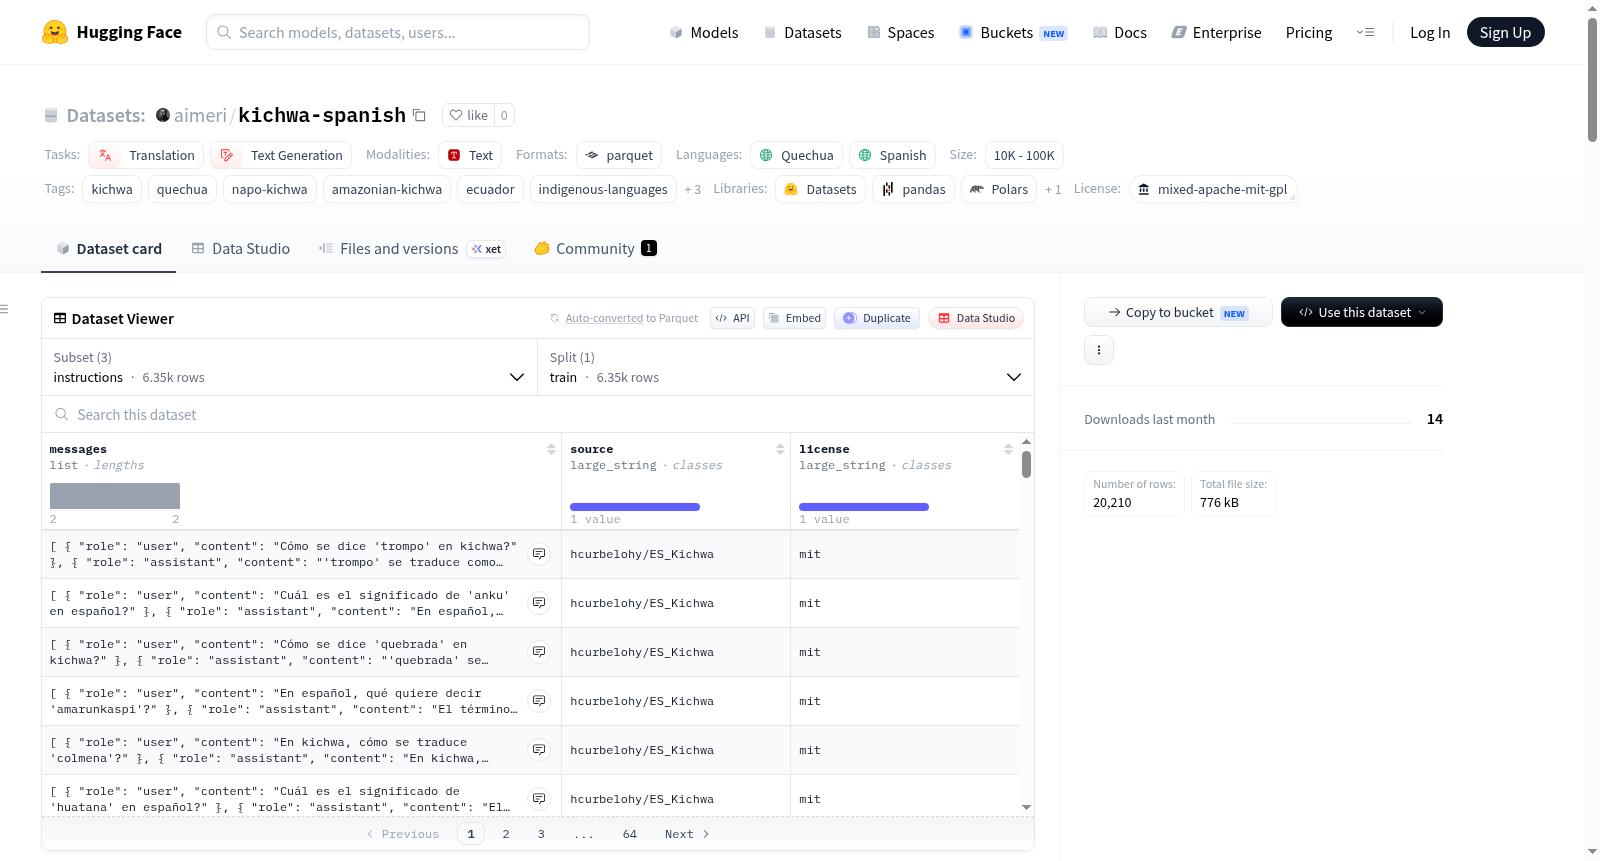
Kichwa–Spanish 平行词典与指令数据集是一个经过清理、去重和结构化的双语资源,专门针对厄瓜多尔纳波低地(亚马逊)基丘瓦语(ISO 639-3 `qvo`;宏观语言 `qu`)与西班牙语。该数据集并非全新创建,而是对Hugging Face Hub上三个源自同一出版词典的现有社区上传数据进行了整合与修复,解决了原始数据中存在的列解析错误、数据集查看器类型转换错误、列方向混乱和格式不一致等问题。数据集包含三个独立配置:1) `lexicon`(默认配置):包含6,313个平行对(词目及例句),采用Apache-2.0与MIT混合许可,其中6,287行标记为`ok`,26行标记为`review`;2) `instructions`:包含6,354个聊天格式的问答对(用于指令微调),源自同一词典,采用MIT许可;3) `lexicon_gpl`:包含7,543个平行对,采用GPL-3.0许可,与`lexicon`配置内容相关但独立存放以遵守许可协议。所有配置总计提供13,856个平行对。数据字段包括基丘瓦语文本、西班牙语文本、条目类型(词目或例句)、质量标记、来源和许可信息。数据源自UNICEF与厄瓜多尔DINEIB出版的《Diccionario Kichwa–Castellano》教育词典,并整合了三个贡献者数据集。数据集经过解析校正、语言方向修复、文本规范化、去重和质量标记等处理。局限性包括:未经流利基丘瓦语使用者验证、西班牙语侧存在OCR导致的错误空格、少量行标记为需审查、条目类型为启发式判定,且内容仅限于纳波低地(亚马逊)方言。适用于基丘瓦语与西班牙语之间的机器翻译、双语词典归纳、低资源语言指令微调以及语言保护与教育工具开发。
数据集概述
数据集名称: Kichwa–Spanish Parallel Lexicon & Instructions (Napo / Amazonian Kichwa)
数据集地址: https://huggingface.co/datasets/aimeri/kichwa-spanish
语言: Kichwa (ISO 639-3 qvo, 厄瓜多尔 Napo Lowland 方言) ↔ 西班牙语
任务类别: 翻译 (translation), 文本生成 (text-generation)
许可协议: 各配置不同,详见下方表格。存储库级许可标记为 other。
数据集构成
该数据集并非全新数据,而是对三个现有社区上传的、源自同一已出版词典的数据进行清理、去重和结构化整理的产物。数据按许可协议分为三个配置(Config):
| 配置名称 | 数据行数 | 许可协议 | 内容描述 |
|---|---|---|---|
lexicon (默认) |
6,313 行 | Apache-2.0 + MIT | 平行语对(包括词条和例句)。其中 6,287 行标记为 ok,26 行标记为 review(需要审查)。 |
instructions |
6,354 行 | MIT | 聊天格式的问答对(指令微调用),从相同的词典数据派生。 |
lexicon_gpl |
7,543 行 | GPL-3.0 | 来自 GPL 许可来源的平行语对,单独存放。其中 7,542 行标记为 ok,1 行标记为 review。 |
两个词表配置 (lexicon 和 lexicon_gpl) 共有 13,856 条平行语对,它们有重叠但内容不完全相同。
数据字段
lexicon 和 lexicon_gpl 配置:
| 字段 | 类型 | 描述 |
|---|---|---|
kichwa |
string | Kichwa 侧文本(词条或例句)。 |
spanish |
string | 西班牙语侧文本(释义或翻译)。 |
entry_type |
string | 条目类型:headword(1-2词术语)或 example(≥3词句子),基于启发式规则。 |
quality_flag |
string | 质量标记:ok(正常)或 review(Kichwa 字段读起来像西班牙语,可能源数据有错位)。 |
source |
string | 来源存储库。如果去重后对出现于多个来源,则用 + 连接。 |
license |
string | 每条数据的许可协议。如果合并自多个来源,则用 + 连接。 |
instructions 配置:
| 字段 | 类型 | 描述 |
|---|---|---|
messages |
list | 对话轮次:[{"role": "user"/"assistant", "content": "..."}]。 |
source |
string | 来源存储库。 |
license |
string | 许可协议 (mit)。 |
数据来源与致谢
- 上游源词典: 数据最终来源于由 UNICEF 和厄瓜多尔 DINEIB 出版的 《Diccionario Kichwa–Castellano》(Napo 方言),ISBN 978-92-806-4082-3,用于免费教育分发。数字版托管在 FLACSO Andes 数字图书馆。
- 贡献的 Hub 数据集:
Carlos89apc/TraductorES_Kichwa(GPL-3.0) → 贡献给lexicon_gpl配置。hcurbelo/Kichwa_ES_001(Apache-2.0) → 贡献给lexicon配置。hcurbelohy/ES_Kichwa(MIT) → 贡献给instructions配置(并挖掘了一部分平行语对到lexicon)。
数据清理与标准化
- 纠正解析错误: 修复了原始数据中列分隔混乱、列类型错误等问题。
- 语言方向修复: 通过一个 Kichwa 与西班牙语的评分器,纠正了约 280 行语言顺序颠倒的数据。
- 标准化: 压缩空白、去除标点伪影、将全大写词条转换为小写。
- 去重: 在每个许可层级内移除精确重复的
(kichwa, spanish)对。 - 质量标记: 对 Kichwa 字段仍读起来像西班牙语的行标记
quality_flag = "review",而不是直接丢弃。
局限性
- 未经验证: 内容未经流利的 Kichwa 母语者验证。
- 西班牙语伪影: 西班牙语文本中存在来自原始数字化的错误中间空格(如
te nía),未被修正。 - 标记为
review的行: 约 0.4% 的行在源数据中存在错位。建议在需要纯净数据时过滤quality_flag == "ok"的行。 - 方言: 内容为 Napo Lowland (Amazonian) 厄瓜多尔 Kichwa 方言 (
qvo),不覆盖其他高地变体。
预期用途
机器翻译(Kichwa↔西班牙语)、双语词表归纳、低资源 Kichwa 的指令微调,以及语言保护和教育工具开发。鉴于上述局限性,建议在面向用户的应用前进行人工审核。