
遇见数据集

EgoPlay数据集

收藏
arXiv2026-07-27 更新2026-07-29 收录
数据链接:
官方服务:

资源简介:

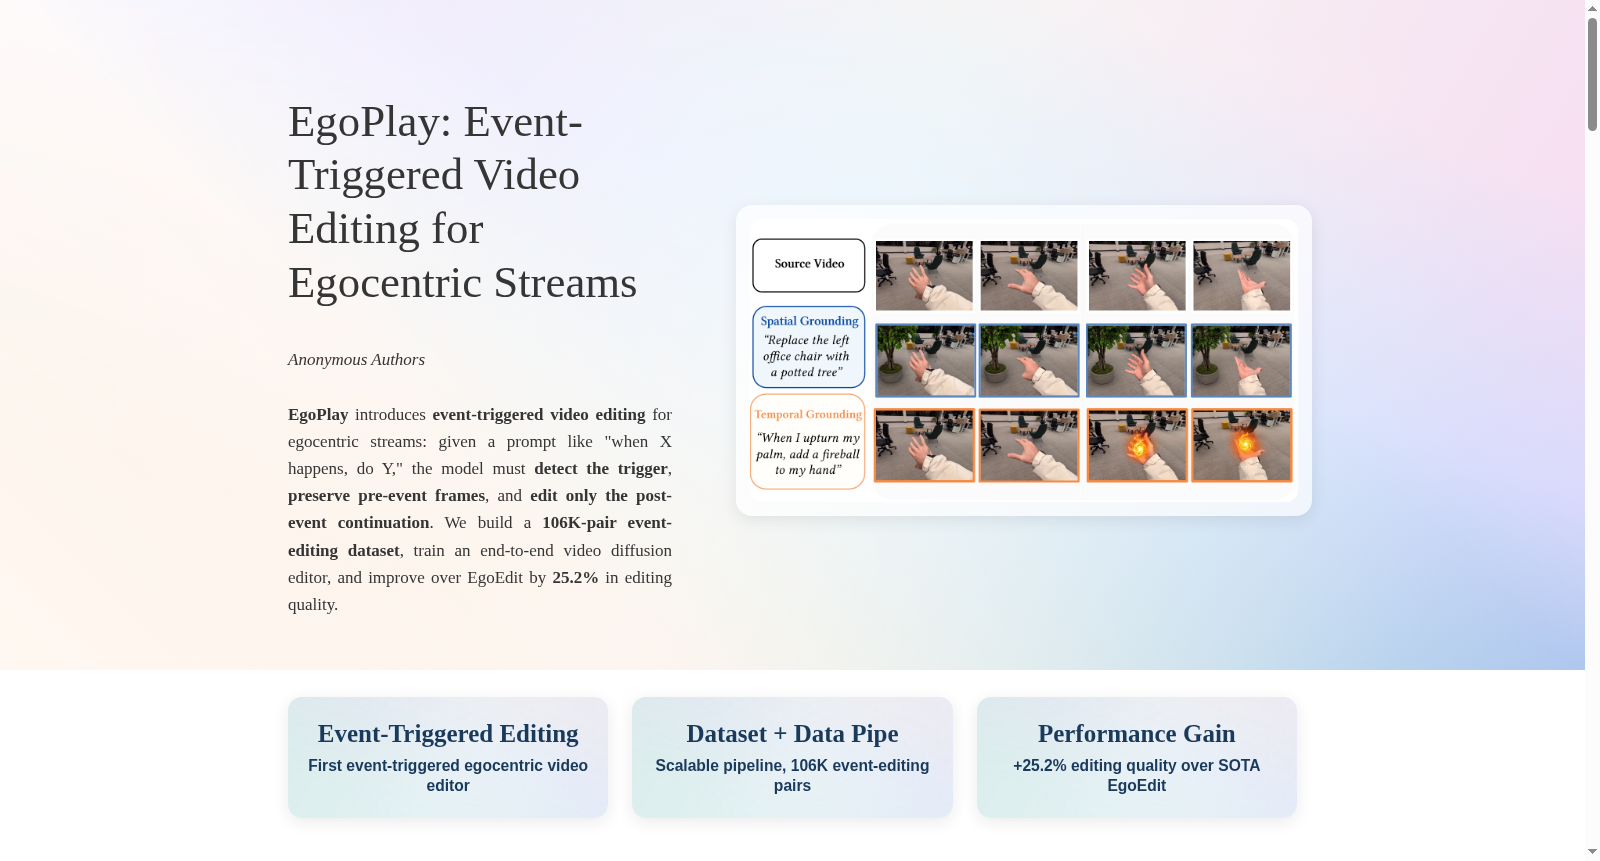
EgoPlay数据集是由Snap公司与阿卜杜拉国王科技大学联合构建的大规模事件触发视频编辑数据集,主要用于训练端到端的自我中心视频编辑模型。该数据集包含10.6万个事件触发剪辑-提示对,数据主要源自公开的Ego4D自我中心视频素材,并辅以少量人工标注的通用领域子集以增强多样性,涵盖正向触发、构造性负向触发及多事件提示等多种编辑模式。数据集通过多阶段视觉语言模型流水线构建,首先生成事件描述和编辑指令,随后在事件后片段应用编辑并融合过渡帧以确保时间连续性。该数据集的核心应用在于推动增强现实和可穿戴设备领域的自主视频编辑技术,旨在实现根据视觉事件自动触发编辑操作,解决传统方法需要手动标注时间边界和掩模的局限性。

The EgoPlay Dataset is a large-scale event-triggered video editing dataset jointly constructed by Snap Inc. and King Abdullah University of Science and Technology (KAUST), primarily used for training end-to-end egocentric video editing models. It contains 106,000 event-triggered clip-prompt pairs, which are mainly sourced from publicly available Ego4D egocentric video materials, supplemented by a small number of manually annotated general-domain subsets to enhance diversity, covering multiple editing modes including positive triggers, constructive negative triggers, and multi-event prompts. The dataset is built via a multi-stage vision-language model pipeline: first, event descriptions and editing instructions are generated, then edits are applied to post-event segments and transition frames are fused to ensure temporal consistency. The core applications of this dataset lie in advancing autonomous video editing technologies in the fields of augmented reality (AR) and wearable devices, aiming to enable automatic triggering of editing operations based on visual events and address the limitations of traditional methods that require manual annotation of temporal boundaries and masks.
创建时间:
2026-07-27
搜集汇总
数据集介绍
EgoPlay数据集 数据集图片
构建方式
EgoPlay数据集的建设依托于公开的Ego4D第一人称视频资源,并结合辅助的通用领域视频以增强视觉与事件多样性。研究团队通过多阶段的视觉语言模型流水线对原始视频进行精细加工:首先利用质量过滤工具剔除模糊、抖动、过亮或过暗的低质片段,再由大语言模型筛选具有明确视觉完成点的离散动作事件,并确保叙述与画面内容高度一致。在此基础上,通过多轮对话生成事件触发的编辑指令,涵盖正触发、虚构负触发及多事件组合三类提示。针对每一正面样本,运用预训练的视频编辑模型对事件后段落实施所需修改,并通过变分自编码器在事件边界处进行潜空间球形插值,生成平滑过渡帧,从而构建出包含10.6万对剪辑-提示对的大规模数据集。
特点
该数据集的核心特色在于其开创性地将事件检测与视频编辑融合为一项端到端学习任务。与传统的级联式检测-编辑流水线不同,EgoPlay数据集中的每一样本均将“何时编辑”的时序判断与“如何编辑”的视觉修改整合于单一条件信号之中。数据集精心设计了正触发、负触发与多事件组合三种模式,使模型既能学习在指定事件发生后精准施加编辑,亦能拒绝对未发生事件做出响应。尤为独特的是,负样本通过虚构不存在的触发事件来模拟用户指令与实际视觉内容不匹配的复杂场景,极大地强化了模型的鲁棒性与判别力。此外,数据集覆盖了21种编辑类型,从风格迁移、物体替换到动态光效,充分支持丰富多样的视觉编辑效果。
使用方法
研究人员可直接利用该数据集对预训练的扩散视频编辑模型进行微调,形成统一的时序条件视频编辑框架。使用过程中,用户仅需提供一段第一人称单目视频与一条自然语言规则,格式如“当X发生时,执行Y编辑”,模型将自动判断事件是否发生并仅在事件后段落施加编辑。数据集内置了正向、负向与多事件提示的训练样本,因此模型无需额外的事件检测器或时序标注。为适应流式推理场景,研究者还可基于双向模型蒸馏出因果变体,采用逐块因果自注意力机制,在无需未来帧信息的情况下实现视频流的实时编辑。配套的事件感知评估协议将视频按真实事件边界拆分为事件前、事件中与事件后三段,分别评测编辑质量、视觉质量与背景一致性,确保对时序精准性的全面考量。
背景与挑战
背景概述
EgoPlay数据集诞生于增强现实(AR)系统对实时、因果驱动的第一人称视频编辑日益增长的需求背景之下。由Snap Inc.与阿卜杜拉国王科技大学(KAUST)的联合研究团队于2026年提出,该数据集旨在解决一个核心研究问题:如何使生成式视频编辑模型能够根据用户指定的自然语言事件触发规则(例如“当我拿起杯子时,将其变为高脚杯”),自动从原始像素中检测事件发生时刻,并仅在事件发生后应用编辑,同时完整保留事件前的视频内容。该数据集以Ego4D中的自我中心视频为主要来源,通过多阶段VLM流程构建了包含106K对事件触发剪辑-提示对的大规模训练数据,涵盖了正触发、虚构负触发及多事件提示等多样化场景。其影响力在于首次将事件检测与像素级编辑统一为端到端学习任务,为始终在线的可穿戴AR系统中的智能视频编辑奠定了数据与模型基础。
当前挑战
EgoPlay数据集所面临的挑战是多维度的。首先,在领域问题层面,事件触发的自我中心视频编辑需要模型同时解决三个相互耦合的子任务:从原始视频帧中隐式检测特定视觉事件是否发生及何时发生,在事件发生前严格保持视频内容不变,并在事件发生后生成时空一致的编辑效果。现有方法要么将事件检测与编辑解耦为独立模块导致延迟和边界不连续,要么只能对整个视频应用单一编辑而缺乏时间条件控制。其次,在数据集构建过程中,研究团队面临了严峻挑战:Ego4D原始视频噪声较大,需要经过美学、模糊度、运动、亮度等多维度自动过滤,并借助VLM筛选出具有清晰完成点的离散可视动作;进一步地,生成高质量的事件触发提示对需要多轮VLM管线以确保正负样本的语义丰富性与视觉可信度;在合成编辑目标时,为避免事件边界处的硬切变,还需通过VAE隐空间球形插值生成平滑过渡帧,这对数据质量提出了极高要求。
常用场景
经典使用场景
在增强现实与可穿戴计算蓬勃发展的背景下,EgoPlay数据集为事件触发的第一人称视频编辑任务提供了核心支撑。该数据集由超过10.6万条事件触发剪辑-提示对构成,其中约8.2万条源自Ego4D的大规模自我中心视频,辅以约2.2万条通用域视频以增强多样性。每条数据均包含源视频、对应的编辑目标视频、条件化提示,以及事件与编辑边界的时间定位信息。经典的使用场景是,给定一段单目第一人称视频和一条形如“当X发生时,执行Y”的自然语言指令,模型需从原始像素中自主检测视觉触发事件,在不借助任何手动掩码或时间戳的情况下,精确保持触发前的所有帧不变,仅对触发后的连续帧施加期望的编辑效果。
解决学术问题
在学术研究层面,EgoPlay数据集填补了事件触发视频编辑这一交叉领域的系统性空白。在此之前,学术界面临的核心困境在于:指令驱动的视频编辑模型缺乏时序触发条件,事件检测与视觉编辑被割裂为独立模块,导致定位误差在级联过程中传播放大,并引入明显的拼接痕迹。该数据集通过精心设计的正触发、伪造负触发及多事件提示三类监督信号,首次使模型能够在单一端到端框架中联合学习事件识别、时序约束与像素级编辑这一三合一的复杂行为。这一突破意义深远——它不仅验证了联合隐式事件定位与编辑的可行性,更为未来构建无需人工干预的自主流式编辑系统奠定了关键的数据基础与训练范式。
衍生相关工作
在衍生工作层面,EgoPlay数据集催生了编辑时序定位分析与因果推理建模两条重要的研究方向。一方面,研究者基于该数据集引入了一种事件感知的评估协议,将每条视频序列按真实事件边界分解为事件前、事件中和事件后三个阶段,分别独立评测编辑质量、视觉质量与背景一致性,并特别关注模型对伪造触发的鲁棒性。另一方面,该数据集推动了从双向离线模型向因果流式模型的关键转变——通过将自注意力机制替换为分块因果自注意力并结合扩散强制训练策略,衍生了EgoPlay-Causal变体,使得模型能够在无需未来帧上下文的情况下逐块进行流式推理,从而在内存占用降低近10%的同时保持了接近双向上限的编辑质量,为实时部署在资源受限的边缘设备上铺平了道路。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

