
abdoelsayed/Open-ArabicaQA
收藏官方服务:
资源简介:
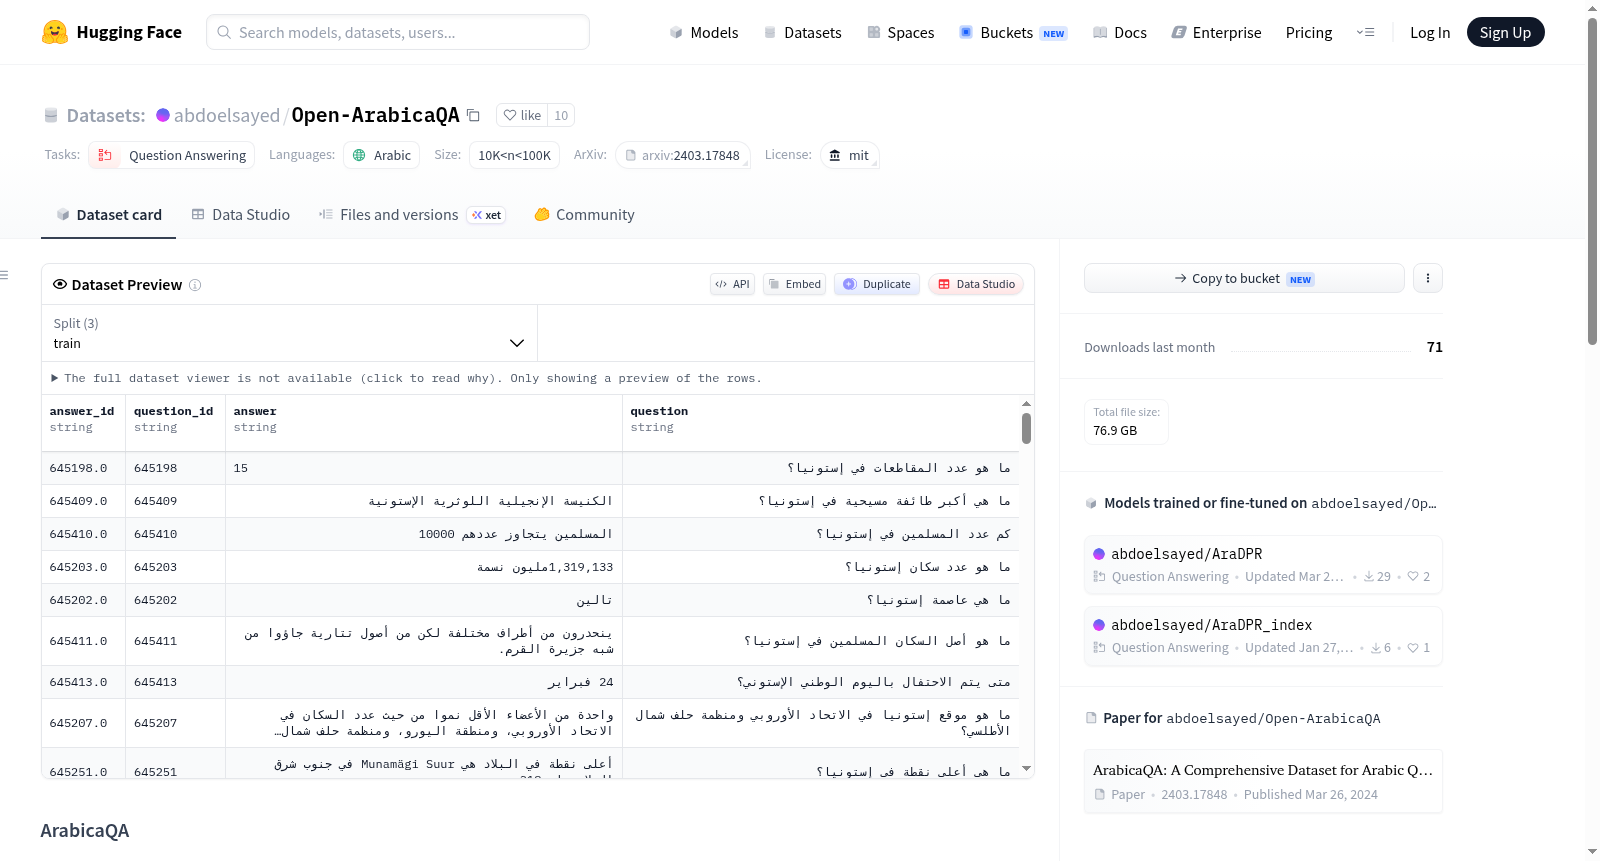
ArabicaQA是一个为支持和发展阿拉伯语问答系统而设计的全面数据集。它涵盖了多种问题类型,包括机器阅读理解(MRC)和开放领域问题,旨在促进阿拉伯语问答模型的训练、验证和测试。数据集包含训练集、验证集和测试集,具体数量如下:MRC(有答案)训练集62,186条,验证集13,483条,测试集13,426条;MRC(无答案)训练集2,596条,验证集561条,测试集544条;开放领域训练集62,057条,验证集13,475条,测试集13,414条;以及另一组开放领域训练集58,528条,验证集12,541条,测试集12,541条。
ArabicaQA是一个为支持和发展阿拉伯语问答系统而设计的全面数据集。它涵盖了多种问题类型,包括机器阅读理解(MRC)和开放领域问题,旨在促进阿拉伯语问答模型的训练、验证和测试。数据集包含训练集、验证集和测试集,具体数量如下:MRC(有答案)训练集62,186条,验证集13,483条,测试集13,426条;MRC(无答案)训练集2,596条,验证集561条,测试集544条;开放领域训练集62,057条,验证集13,475条,测试集13,414条;以及另一组开放领域训练集58,528条,验证集12,541条,测试集12,541条。
提供机构:
abdoelsayed原始信息汇总
ArabicaQA 数据集概述
数据集基本信息
- 数据集名称: ArabicaQA
- 数据集描述: 一个全面的阿拉伯语问答数据集,支持阿拉伯语问答系统的发展。
- 数据集类型: 问答数据集
- 任务类别: 问答(Question Answering)
- 语言: 阿拉伯语(ar)
- 数据集大小: 10K<n<100K
- 许可证: MIT
- 数据创建者: 众包(crowdsourced)和发现(found)
数据集详细信息
- 数据集结构: 包含训练集、验证集和测试集。
- 数据统计:
训练集 验证集 测试集 MRC(有答案) 62,186 13,483 13,426 MRC(不可回答) 2,596 561 544 开放领域(Open-Domain) 62,057 13,475 13,414 开放领域(Open-Domain) 58,528 12,541 12,541
引用信息
- 论文标题: ArabicaQA: A Comprehensive Dataset for Arabic Question Answering
- 作者: Abdelrahman Abdallah, Mahmoud Kasem, Mahmoud Abdalla, Mohamed Mahmoud, Mohamed Elkasaby, Yasser Elbendary, Adam Jatowt
- 年份: 2024
- arXiv编号: 2403.17848
- 主要类别: cs.CL
搜集汇总
数据集介绍
构建方式
在阿拉伯语自然语言处理领域,高质量问答数据集的匮乏长期制约着相关技术的发展。ArabicaQA数据集通过融合众包与自动挖掘两种策略构建而成,旨在为阿拉伯语问答系统提供全面支撑。其构建过程兼顾了机器阅读理解与开放域问答两大任务场景:对于机器阅读理解部分,数据源自阿拉伯语文本段落,由标注人员设计可回答与不可回答的问题;开放域问答部分则通过自动从大规模语料中抽取问题-答案对,并辅以人工验证来确保质量。最终数据集覆盖训练、验证与测试三个子集,总计超过十万条样本。
特点
该数据集的核心特点在于其双轨架构与规模优势。一方面,它同时包含机器阅读理解与开放域问答两类样本,使模型能够同时学习基于上下文的推理与知识检索能力,这在现有阿拉伯语数据集中尚属罕见。另一方面,数据集特别纳入了不可回答的机器阅读理解样本,有效模拟了真实场景中信息缺失的挑战,有助于提升模型的鲁棒性。此外,所有样本均经过众包标注与多重验证,保证了语言地道性与语义准确性,为阿拉伯语问答研究提供了坚实基准。
使用方法
使用ArabicaQA数据集时,研究者可直接加载其提供的训练、验证与测试分片,以适配常见的问答模型训练流程。对于机器阅读理解任务,模型需基于给定的上下文段落输出答案或判定问题不可回答;对于开放域任务,则需结合外部知识库或检索模块进行答案生成。数据集采用标准化格式,便于与HuggingFace Transformers等框架集成。推荐在训练时对两类任务进行联合优化,以充分利用数据集的多样性,同时注意平衡可回答与不可回答样本的比例,防止模型产生偏向性。
背景与挑战
背景概述
随着自然语言处理技术的迅猛发展,问答系统作为人机交互的核心组件,受到了广泛关注。然而,阿拉伯语作为全球使用人数众多的语言之一,其问答系统的研究相对滞后,主要受限于高质量标注语料库的匮乏。在此背景下,由Abdelrahman Abdallah、Mahmoud Kasem等来自DataScienceUIBK的研究人员于2024年发布了ArabicaQA数据集,旨在填补这一空白。该数据集涵盖机器阅读理解与开放域问答两大任务,包含超过12万条样本,为阿拉伯语问答系统的训练与评估提供了坚实的数据基础。ArabicaQA的推出不仅推动了低资源语言问答研究的发展,也为多语言自然语言处理领域注入了新的活力。
当前挑战
ArabicaQA所面对的核心挑战在于阿拉伯语本身的复杂性,包括其丰富的形态变化、方言多样性以及右至左的书写系统,这些因素使得构建鲁棒的问答系统尤为困难。在数据构建过程中,研究者需从多源文档中提取并标注问题-答案对,同时确保覆盖可回答与不可回答两类场景,这增加了标注的一致性与质量控制的难度。此外,开放域问答部分需要处理大规模知识库的检索与推理,而现有阿拉伯语资源相对有限,进一步加剧了模型泛化与性能提升的挑战。这些难点共同构成了ArabicaQA在推动阿拉伯语问答研究前进时必须克服的障碍。
常用场景
经典使用场景
在自然语言处理领域,阿拉伯语因其复杂的形态结构和匮乏的标注资源而长期处于研究洼地。Open-ArabicaQA数据集应运而生,其核心用途在于构建和评估阿拉伯语机器阅读理解(MRC)与开放域问答(Open-Domain QA)系统。该数据集精心划分了训练、验证和测试集,包含超过六万条带答案的MRC样本以及同等规模的开放域问答对,同时引入了数千条不可回答的MRC样本以增强模型对歧义问题的鲁棒性。研究者可基于此数据集训练端到端的抽取式问答模型,或将其作为预训练语言模型微调的标准基准,从而推动阿拉伯语语义理解与信息检索技术的协同发展。
解决学术问题
该数据集有效填补了阿拉伯语问答领域缺乏大规模、高质量标注语料的空白,解决了传统资源在问题类型多样性、领域覆盖度与答案可验证性上的结构性缺陷。通过同时提供MRC与开放域两种任务范式,ArabicaQA首次使研究者能够在统一框架下对比分析模型在上下文依赖型与知识检索型问题上的表现差异。其精心设计的不可回答问题子集挑战了模型对否定性推理与信息缺失的判别能力,为评估问答系统的置信度校准与假阳性抑制提供了关键测试床,推动了阿拉伯语自然语言理解研究从简单匹配向深层语义推理的范式跃迁。
衍生相关工作
基于ArabicaQA的发布,后续涌现出多项衍生研究工作。研究者利用该数据集对多语言预训练模型(如XLM-R、AraBERT)进行微调,系统对比了不同架构在阿拉伯语MRC任务上的性能瓶颈。部分工作进一步扩展了数据集的领域覆盖度,通过引入宗教、法律等专业语料构建子集,验证了跨领域迁移学习的可行性。此外,该数据集促进了阿拉伯语不可回答问题检测专项任务的发展,催生了基于对抗训练与证据推理的拒答机制改进方案。在评估体系层面,有学者借鉴其样本划分策略,重新设计了面向低资源语言的问答基准测试协议,为后续阿拉伯语信息抽取与对话系统的研究奠定了方法论基础。
以上内容由遇见数据集搜集并总结生成


