LDS-retrain-bank-adamw-wikitext2-N4656-bs8-seed1007
收藏资源简介:
该数据集为训练数据归因研究提供了完整的重训练基准。它包含100个GPT-2模型,每个模型在WikiText-2训练集(共4656个文档)的随机50%子集(2328个文档)上微调,训练配置遵循Bae等人2024年论文中的设置(附录B.1)。此外,还提供了一个在完整训练集上微调的基础模型。数据集包含验证集上每个查询的损失变化(ground truth)、子集ID、训练配置文件和EK-FAC LDS摘要。五个种子(1004-1008)共享相同的100个子集,仅训练种子不同,通过平均五个种子的查询损失可得到真实值。该数据集适用于评估和比较不同训练数据归因方法(如影响函数、近似展开微分等)的准确性。
This dataset provides a complete retraining benchmark for training data attribution research. It contains 100 GPT-2 models, each fine-tuned on a random 50% subset (2,328 documents) of the WikiText-2 training set (total 4,656 documents), with training configuration following the settings in Bae et al. 2024 (Appendix B.1). Additionally, a base model fine-tuned on the full training set is provided. The dataset includes per-query loss changes (ground truth) on the validation set, subset IDs, training configuration files, and EK-FAC LDS summaries. Five seeds (1004-1008) share the same 100 subsets, differing only in training seeds, and the ground truth is obtained by averaging query losses across the five seeds. This dataset is suitable for evaluating and comparing the accuracy of different training data attribution methods (e.g., influence functions, approximate unrolled differentials, etc.).
数据集概述:LDS-retrain-bank-adamw-wikitext2-N4656-bs8-seed1007
基本信息
- 数据集名称:LDS-retrain-bank-adamw-wikitext2-N4656-bs8-seed1007
- 许可证:Apache-2.0
- 标签:训练数据归属(training-data-attribution)、影响函数(influence-functions)、可解释性(interpretability)
数据集描述
该数据集包含 100 个完全重新训练的 GPT-2 语言模型,每个模型在 WikiText-2 训练集的不同随机 50% 子集(2,328 篇文档,共 4,656 篇文档)上进行微调,数据来源为 EleutherAI/bergson-wikitext-2-4656-chunks。训练方法遵循 Bae et al. 2024 年论文《Training Data Attribution via Approximate Unrolled Differentiation》附录 B.1 中的方案。基础模型 retrained/base 使用相同种子在完整训练集上训练。
相关仓库
存在 5 个共享相同 100 个子集(subsets.json)但训练种子不同的数据银行,分别是种子 1004、1005、1006、1007 和 1008。将查询损失在五个种子上取平均,即可得到 bergson 复制实验所使用的真实结果。
文件结构
| 路径 | 内容说明 |
|---|---|
retrained/base/ |
在完整训练集上微调的模型 |
retrained/subset_*/ |
100 个模型,每个在不同随机半集上训练 |
validation.csv |
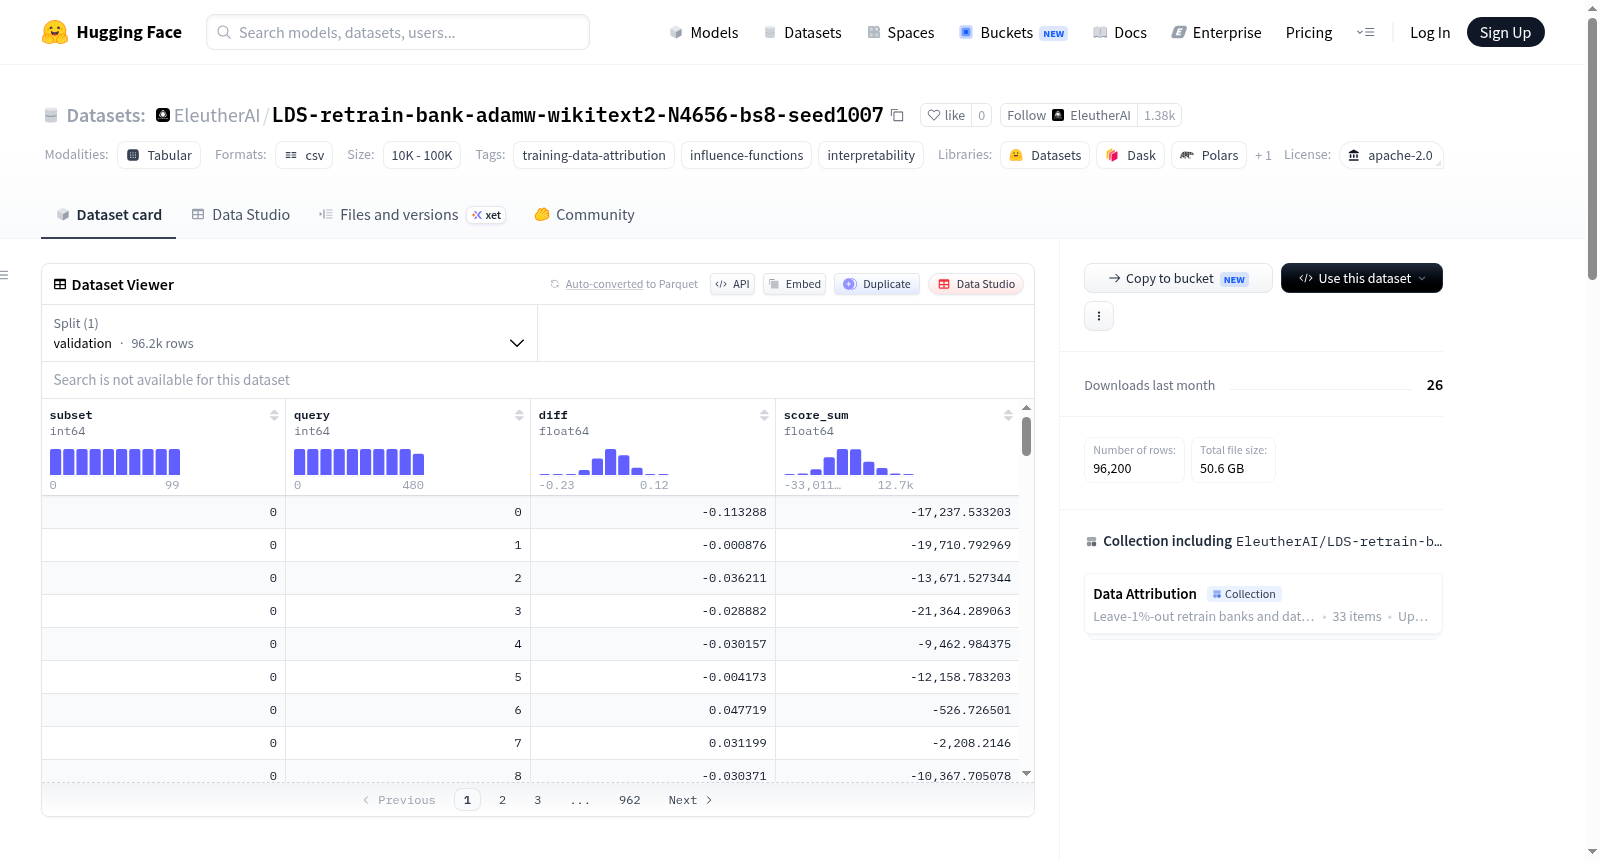
真实结果:481 个验证查询在每个(子集,查询)上的损失变化,以及移除文档的 EK-FAC 影响和 |
subsets.json |
每个子集移除的文档 ID |
config.yaml |
确切的训练配置 |
summary*.csv |
每个查询的 EK-FAC LDS |
使用方法
通过 snapshot_download 下载整个数据集后,可读取 validation.csv 获取每个半集对每个查询损失影响的真实结果,并可将自己的方法预测的影响与 diff 列进行相关分析。LDS 定义为查询间 Spearman 相关系数的平均值。该目录也可直接作为 bergson validate 步骤的 retrained_dir 使用。
性能评估
在五个种子平均后的真实结果上评估:
| 方法 | LDS(481 个查询的平均 Spearman,95% 置信区间) |
|---|---|
| EK-FAC IF | 0.468 ± 0.015 |
| SOURCE | 0.476 ± 0.015 |
模型分数基于 EleutherAI/bergson-wikitext-2-gpt2 中微调运行计算。
训练配置与来源
- 优化器:AdamW(β=(0.9, 0.999),ε=1e-8)
- 学习率:恒定为 3e-5
- 权重衰减:0.01
- 批次大小:8
- 训练轮数:3
- 精度:fp32,启用 dropout
- 种子:1007
- 语料库:WikiText-2,4,656 篇训练文档;481 个验证查询
该数据集由 bergson 工具生成,具体配置文件为 examples/replicate_bae_approx_unrolling_source/wikitext_gpt2_retrain.yaml。