
遇见数据集

LiteFold/MegaScale-Tsuboyama2023

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

MegaScale Tsuboyama 2023 Stability数据集基于cDNA display proteolysis方法,用于大规模测量蛋白质折叠热力学稳定性。该方法在一周实验中可测量多达900,000个蛋白质结构域,总测量量达180万次,最终筛选出约776,000个高质量折叠稳定性数据。数据覆盖331个天然蛋白质结构域和148个从头设计蛋白质结构域的所有单氨基酸变体及部分双突变体,这些结构域长度在40-72个氨基酸之间。该数据集用于量化环境因素对氨基酸适应性的影响、蛋白质位点间的热力学耦合(包括意外相互作用),以及进化氨基酸使用与蛋白质折叠稳定性之间的全局差异。此外,它还用于识别设计蛋白质中的稳定性决定因素和评估设计方法。cDNA display proteolysis方法快速、准确且可扩展性强,有望揭示氨基酸序列编码折叠稳定性的定量规则。

Advances in DNA sequencing and machine learning are providing insights into protein sequences and structures on an enormous scale. However, the energetics driving folding are invisible in these structures and remain largely unknown. The hidden thermodynamics of folding can drive disease, shape protein evolution and guide protein engineering, and new approaches are needed to reveal these thermodynamics for every sequence and structure. Here we present cDNA display proteolysis, a method for measuring thermodynamic folding stability for up to 900,000 protein domains in a one-week experiment. From 1.8 million measurements in total, we curated a set of around 776,000 high-quality folding stabilities covering all single amino acid variants and selected double mutants of 331 natural and 148 de novo designed protein domains 40–72 amino acids in length. Using this extensive dataset, we quantified (1) environmental factors influencing amino acid fitness, (2) thermodynamic couplings (including unexpected interactions) between protein sites, and (3) the global divergence between evolutionary amino acid usage and protein folding stability. We also examined how our approach could identify stability determinants in designed proteins and evaluate design methods. The cDNA display proteolysis method is fast, accurate and uniquely scalable, and promises to reveal the quantitative rules for how amino acid sequences encode folding stability.
提供机构:
LiteFold
搜集汇总
数据集介绍
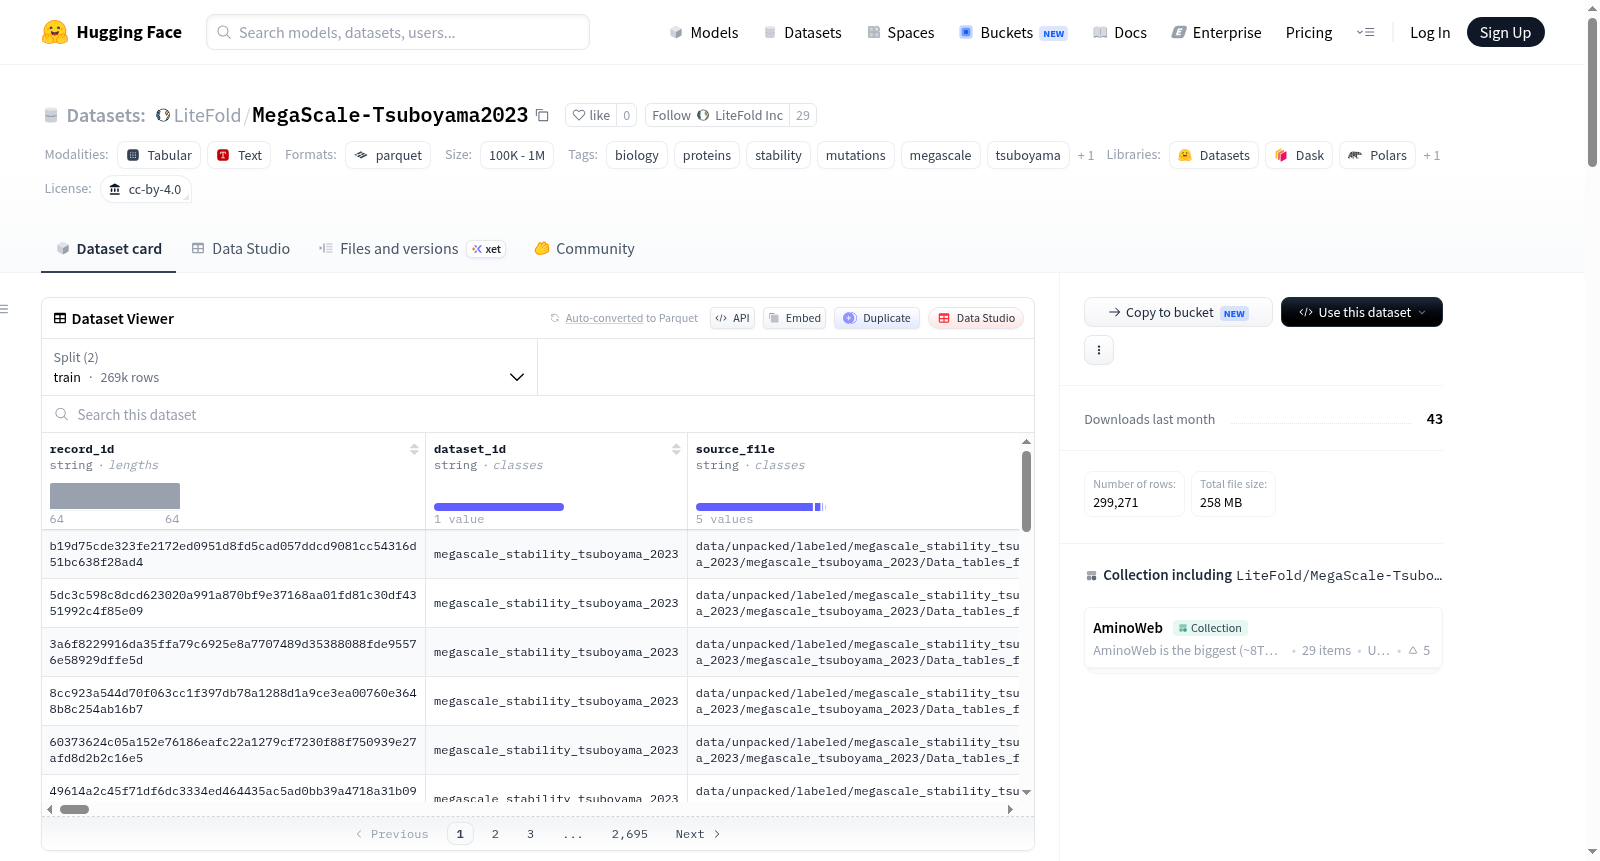
LiteFold/MegaScale-Tsuboyama2023 数据集图片
构建方式
该数据集源自Tsuboyama等人于2023年发表在《自然》杂志的开创性研究,旨在通过大规模实验揭示蛋白质折叠稳定性的热力学基础。研究团队创新性地开发了cDNA展示蛋白质水解方法,能够在单周内对多达90万个蛋白质结构域进行热力学折叠稳定性测量。从总计180万次测量中,经过严格筛选和质控,最终精选出约77.6万个高质量折叠稳定性数据点,覆盖了331个天然蛋白质结构域和148个从头设计蛋白质结构域的全部单氨基酸变异以及部分双突变体,这些结构域长度介于40至72个氨基酸之间。数据集的构建采用了确定性哈希分割策略,将记录按SHA-256哈希值的末位数字分为训练集(桶1-9)和测试集(桶0),确保了数据划分的可复现性。
使用方法
该数据集的使用极为便捷,主要通过HuggingFace Datasets库进行加载。用户可通过一行代码`load_dataset('LiteFold/MegaScale-Tsuboyama2023')`直接加载完整数据集,并支持按需选择特定列,如记录ID、记录类型、蛋白质ID、突变名称、序列和ΔG值等,以构建适合机器学习模型的输入特征。数据集内置了过滤功能,可高效筛选特定记录类型,例如使用`filter`方法提取双突变体数据。对于需要访问原始上游字段的研究,可通过解析JSON载荷的`raw_row_json`列获得。此外,元数据表(如源表统计和列映射)也可直接通过Parquet文件加载,便于数据探索和后续分析。
背景与挑战
背景概述
MegaScale-Tsuboyama2023数据集由Tsuboyama等人于2023年在《Nature》上发布,核心研究单位为华盛顿大学等机构。该数据集聚焦于蛋白质折叠稳定性的热力学测量,旨在揭示氨基酸序列如何编码折叠自由能这一长期未解之谜。通过创新的cDNA展示蛋白水解技术,研究者在单周内实现了对多达90万个蛋白质域的高通量热力学稳定性测量,最终筛选出约77.6万个高质量数据,涵盖331个天然蛋白和148个从头设计蛋白的所有单氨基酸变异及部分双突变体。该数据集不仅量化了环境因素对氨基酸适应性的影响、蛋白质位点间的热力学耦合,还探讨了进化氨基酸偏好与折叠稳定性之间的全局背离,为蛋白质工程、进化生物学和设计方法评估提供了前所未有的数据基础与定量规则。
当前挑战
数据集面临的核心挑战在于:1)蛋白质折叠稳定性的热力学测量长期受限于通量与精度,传统实验方法难以覆盖大规模突变体,MegaScale-Tsuboyama2023虽突破至近百万级别,但仍需在保持高通量的同时确保测量准确性与可重复性;2)构建过程中面临数据异构性难题,包括多源数据格式的统一(如double_mutants、site_features等记录类型)、噪声过滤与质量控制,以及如何从1.8百万初始测量中甄别出高置信度的约77.6万个稳定性值;3)数据集主要覆盖40–72个氨基酸的短蛋白域,对于更长或更复杂蛋白的泛化性尚待验证,且双突变组合的稀疏性限制了高阶相互作用的研究,对计算模型提出了数据平衡与插值能力的挑战。
常用场景
经典使用场景
在蛋白质科学领域,MegaScale-Tsuboyama2023数据集凭借其前所未有的规模与高质量,成为研究蛋白质折叠稳定性的核心资源。该数据集包含了约77.6万个高置信度的折叠稳定性测量值,覆盖了331个天然蛋白质结构域与148个从头设计蛋白质结构域中的所有单氨基酸变异及部分双突变体。经典使用场景包括基于大规模突变实验数据,系统性地分析氨基酸替换对蛋白质热力学稳定性的影响,从而揭示蛋白质序列与折叠自由能之间的定量关系。研究者常利用该数据集中的delta_g与score_value字段,结合机器学习模型预测突变对稳定性的扰动,或评估现有计算方法(如Rosetta、AlphaFold)在稳定性预测上的表现。其标准化的分割方式(基于record_id的哈希划分)确保了训练集与测试集的独立性,为模型泛化能力的客观评估提供了可靠基准。
解决学术问题
该数据集精准回应了蛋白质科学中一个长期悬而未决的核心学术问题:如何大规模、高通量地揭示氨基酸序列编码折叠稳定性的定量规则。传统生物物理学方法难以同时测量数千种突变体的折叠自由能,而该数据集通过cDNA展示蛋白酶解法,实现了对多达90万个蛋白质结构域在一周内的稳定测量,将实验通量提升了数个数量级。基于此,研究者得以量化环境因素对氨基酸适应度的影响、解析蛋白质位点之间的热力学耦合(包括非预期相互作用),并系统比较进化氨基酸使用模式与折叠稳定性之间的全局差异。这些发现不仅深化了对蛋白质折叠能量景观的理解,也揭示了疾病相关突变导致蛋白质失稳的分子机制,为精准医疗提供了重要理论支撑。
实际应用
在实际应用中,MegaScale-Tsuboyama2023数据集直接赋能蛋白质工程与生物技术领域的多个关键环节。在工业酶设计方面,该数据提供的稳定性图谱可指导理性定点突变,提升酶制剂在高温、有机溶剂等极端条件下的活性与耐受性。在抗体与治疗性蛋白的开发中,研究者借助该数据集快速筛选稳定突变体,优化候选药物的表达产量与货架期。此外,该数据集对从头设计蛋白质的稳定性评估,为合成生物学中设计新型功能蛋白(如生物传感器、纳米材料支架)提供了实验验证依据。它与AlphaFold等结构预测工具的结合,正在加速从序列到稳定功能的闭环优化流程,显著降低传统试错实验的成本与周期。
数据集最近研究
最新研究方向
基于MegaScale-Tsuboyama2023数据集的蛋白折叠稳定性研究正引领计算生物学与蛋白质工程的交叉前沿。该数据集通过cDNA展示蛋白质水解技术,在单周内测量了多达90万个蛋白质结构域的热力学折叠稳定性,涵盖33个天然与148个人工设计的蛋白质域中所有单氨基酸变异及部分双突变体。这一大规模实验为量化氨基酸适配性的环境因子、蛋白质位点间的热力学耦合以及进化氨基酸偏好与折叠稳定性之间的全局差异提供了数据基石。当前,该数据集被广泛用于训练和验证蛋白质稳定性预测模型,推动了对蛋白质设计规则的理解,尤其在揭示非天然相互作用与设计蛋白稳定性的决定因素方面展现出巨大潜力,为精准蛋白工程与疾病机制研究开辟了新路径。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

