
Lex MX — Leyes Federales de México en Markdown
收藏官方服务:
资源简介:
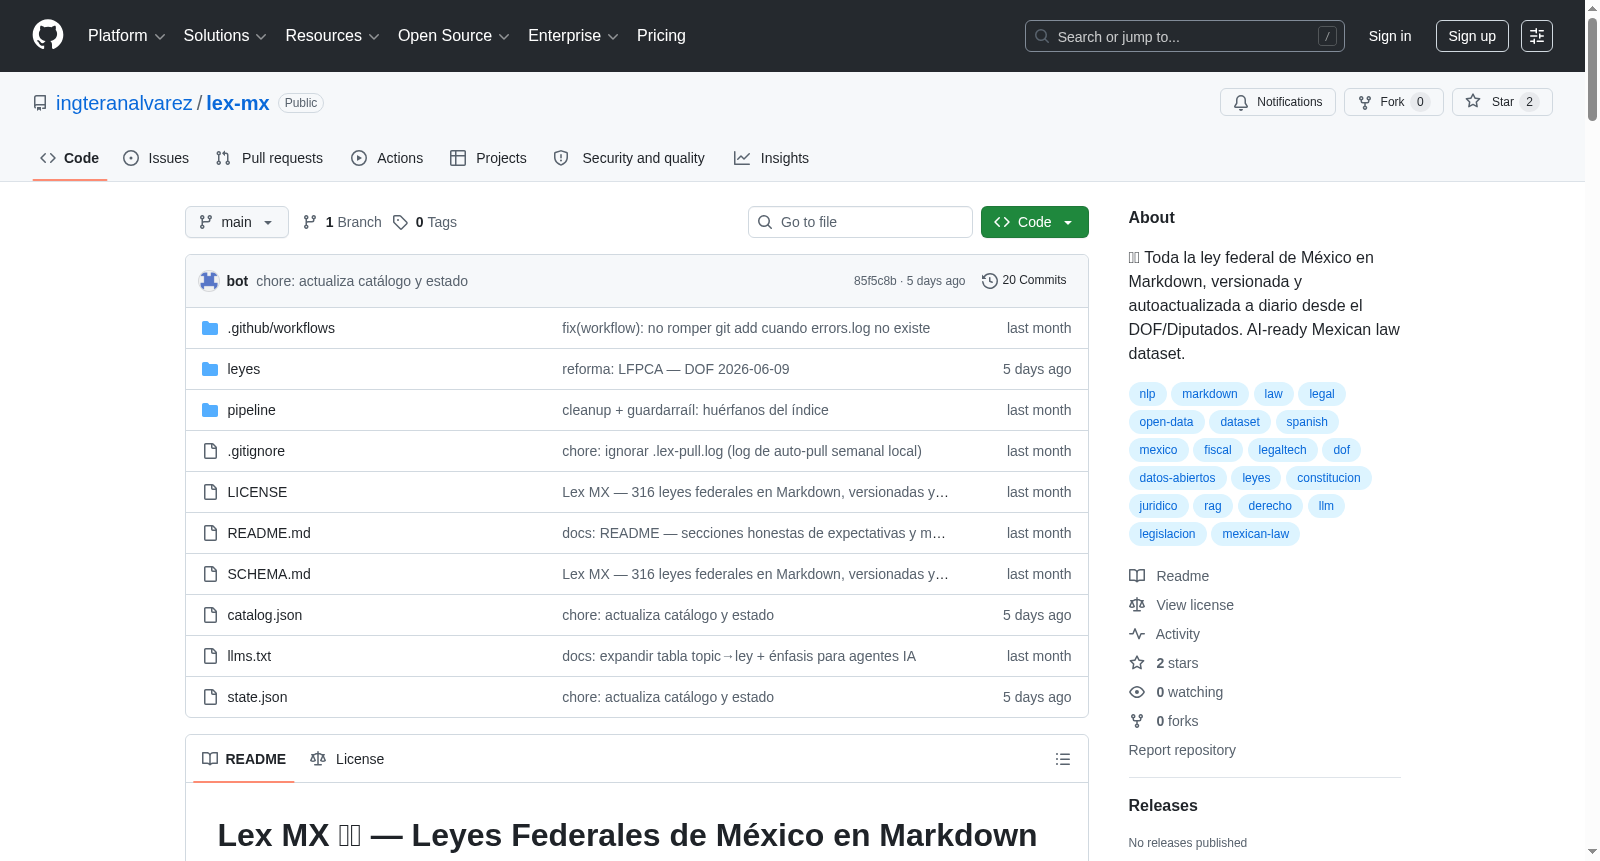
Lex MX 是一个包含墨西哥联邦现行法律的Markdown格式数据集,数据来自官方来源(DOF/Diputados),每日自动更新,并经过版本控制(git)。该数据集旨在为AI和LLM代理提供干净、可引用的法律文本,涵盖宪法、税法、劳动法、刑法等多个领域,以避免AI产生幻觉或引用已废除的法律。
Lex MX is a Markdown-formatted dataset housing the current federal laws of Mexico. The dataset draws from official sources (DOF/Diputados), undergoes automatic daily updates, and employs Git for version control. It is designed to provide clean, citable legal texts for AI and LLM agents, spanning diverse domains such as the Constitution, tax law, labor law, criminal law and more, so as to prevent AI from producing hallucinations or citing repealed laws.
创建时间:
2026-05-16
原始信息汇总
数据集概述:Lex MX 🇲🇽 — 墨西哥联邦法律 Markdown 数据集
1. 数据集内容
- 规模与范围:包含 316 部现行墨西哥联邦法律和法典,涵盖宪法、各类法典、联邦法律及国会条例。
- 格式:每部法律为一个独立的 Markdown 文件(
.md),位于leyes/目录下,文件采用语义化结构(#法律名称,##/###章节标题,**Artículo N.-**标识条款)。 - 更新频率:每日自动更新,通过 GitHub Actions 从官方来源(墨西哥众议院)检测法律修订,并为每部修订的法律生成独立提交记录(
git commit),更新历史即为法律改革日志。
2. 数据来源与法律依据
- 官方来源:墨西哥众议院(Cámara de Diputados)发布的官方 PDF。
- 法律地位:法律文本属于公共领域(依据《联邦版权法》第 14 条),允许再分发。数据集本身为“尽力而为”的自动化转换,非官方来源,法律效力以官方公报(DOF)为准。
3. 核心功能与使用场景
- 精准引用:支持对现行法律条款进行文本级引用,包含每条法律文件的
ultima_reforma(最后修订日期),避免 AI 或人工记忆错误。 - 版本对比:利用 Git 的版本控制功能,可查看每部法律的修订历史(
git log --oneline -- leyes/LIVA.md)及具体变更内容(git diff HEAD~1 -- leyes/CFF.md)。 - AI/LLM 集成:专门为 AI 助手设计的协议使用指南,引导 AI 从原始 Markdown 文件(
raw.githubusercontent.com)中读取并引用法律文本,而非依赖模型记忆,以提高回答的准确性和时效性。
4. 目标用户与适用场景
| 用户类型 | 典型用途 |
|---|---|
| 法律/财税应用开发者 | 为 RAG(检索增强生成)系统提供结构化法律文本,无需解析 PDF |
| AI 助手构建者 | 为 LLM 提供干净、可引用的法律文本,用于法律问答 |
| 会计师、律师、税务专家 | 通过 git diff 追踪法律修订细节,获取可引用的最新文本 |
| 研究人员、数据记者 | 获取可重复、带日期的立法数据集 |
| 模型训练与评估者 | 获取结构化的西班牙语法律语料库 |
5. 使用方式
- 完整克隆:
git clone https://github.com/ingteranalvarez/lex-mx.git - 单部法律下载(免克隆):
curl -O https://raw.githubusercontent.com/ingteranalvarez/lex-mx/main/leyes/LIVA.md - 法律索引:完整法律清单及元数据(
slug,sigla,titulo,ultima_reforma)位于catalog.json:https://raw.githubusercontent.com/ingteranalvarez/lex-mx/main/catalog.json - 本地持续更新:通过
git pull手动更新,或设置每日定时任务自动拉取。
6. 主要法律示例(快速链接)
- Constitución(宪法)
- CFF(联邦财政法典)
- LISR(所得税法)
- LIVA(增值税法)
- LIEPS(特殊产品与服务税法)
- LFT(联邦劳动法)
- CPF(联邦刑法典)
- CCF(联邦民法典)
7. 局限性说明
- 最佳适用场景:需要精确引用法律条款的学术工作、涉及具体数字(税率、期限、金额)的案例、近两年内的法律修订、构建法律 AI 助手或 RAG 系统。
- 不适用场景:通用的法律理论问题、经典教科书级概念、无需引用的摘要总结(模型训练数据已覆盖)。
- 潜在问题:自动化 PDF 转换可能引入提取人工产物(如排版异常),发现后可通过 GitHub Issues 报告。
8. 许可协议
- 法律文本:公共领域
- 数据转换管道代码:MIT 许可证
搜集汇总
数据集介绍
构建方式
在墨西哥联邦法律数字化的浪潮中,Lex MX 数据集应运而生。该数据集由 GitHub Actions 驱动的自动化流水线每日构建,从墨西哥众议院官方索引中获取原始 PDF 文件,检测法律的最新改革日期,仅对发生变动的法律进行重新转换,将其解析为语义清晰的 Markdown 格式。每一部法律独立成文件,并通过 git 进行版本控制,实现了一次提交对应一部法律改革的精细化管理。这种从官方来源直达结构化文本的闭环流程,确保了数据集与联邦官方公报(DOF)所发布文本的即时同步。
使用方法
该数据集为法律科技与人工智能应用提供了便捷的接入路径。用户可通过 `git clone` 完整获取全部法律文本,或使用 `curl` 单独下载特定法律文件。对于大型语言模型(LLM)驱动的智能助手,项目明确了协议:助手的首要操作是打开 `catalog.json` 索引或按主题对照表定位相关法律,随后从 `raw.githubusercontent.com` 读取对应的 `.md` 文件,严格引用原文条款及最近改革日期,拒绝凭记忆虚构法条。用户亦可利用克隆仓库的本地副本,结合 `git pull` 实现持续同步,高效搭建定制的法律检索或司法问答系统。
背景与挑战
背景概述
Lex MX数据集由研究团队于2024年创建,旨在将墨西哥联邦现行法律体系转化为结构化的Markdown格式,以解决法律文本在人工智能时代面临的数字化与可访问性挑战。该数据集涵盖316部联邦法律与法典,包括宪法、税法、劳动法及商法等核心领域,通过每日自动更新的GitHub Action从墨西哥官方来源(众议院与联邦官方公报)同步最新修订版本。其核心研究问题在于构建一个动态、版本化且易于机器解析的法律数据集,以支撑自然语言处理、法律检索增强生成(RAG)系统及学术研究。该数据集已成为墨西哥法律科技领域的重要基础设施,显著降低了法律分析的门槛,并为跨学科研究提供了可复现的语料库。
当前挑战
该数据集面临的挑战具有双重维度。在领域问题层面,其主要挑战在于法律文本的语义完整性维护——法律条款间存在大量交叉引用与依赖关系(如宪法第31条与联邦税收法典第1条的关联),单篇Markdown文件难以捕获这种结构化互联性,可能导致信息孤岛问题。在构建过程中,挑战集中于PDF到Markdown的自动转换质量:官方PDF文件格式不统一,存在表格、脚注、嵌套列表等复杂元素,转换过程可能产生文本错误、标题层级错乱或内容丢失。此外,法律改革具有不可预测性,每日更新的流水线需确保新法规的及时收录与旧版本的准确废止,避免版本冲突与引用失效。
常用场景
经典使用场景
在自然语言处理与法律智能辅助系统的交汇领域,Lex MX数据集凭借其经结构化清洗、每日自动化更新的联邦法律Markdown文本,成为构建墨西哥法律领域检索增强生成系统的核心语料库。研究者与工程师常将其作为语义搜索、法律问答及司法知识图谱构建的标准化数据源,通过索引每一部法律文件中的语义标题与法条锚点,实现精准的法规定位与上下文感知的条款引用,从而有效规避大语言模型在墨西哥法律场景下常见的法条幻觉与时效性偏差。
解决学术问题
该数据集系统性地解决了墨西哥联邦法律研究中的两大长期痛点:一是传统PDF格式法律文本的机器可读性极差,导致文本解析与结构化提取的科研成本居高不下;二是官方法律更新缺乏版本控制与历史差异追踪机制,使得跨版本法律演变分析、改革影响量化研究几乎无法开展。Lex MX通过git版本化与每日自动化同步,为学界提供了首个可复现、可追溯、可差异比较的墨西哥联邦法律时间序列语料,开创了基于代码工程方法研究立法动态的新范式,其影响已辐射至法律语言学、计算法理学及数据驱动型政策评估等前沿领域。
实际应用
在实际产业落地中,Lex MX已被广泛集成至墨西哥本土的财税合规自动化工具、企业法务咨询平台及学术研究辅助系统。典型应用场景包括:为会计师事务所提供即时更新的LIVA、LISR、CFF条文查询与改革对比服务;赋能法律科技初创公司构建面向中小企业的一站式劳动法合规检查机器人,依据LFT条款自动生成解雇补偿金计算报告;同时作为底层数据管道,支撑高校法学院开发面向墨西哥宪法与行政法的智能助教系统,显著提升了法律文书撰写、判例援引复核及法考备考的效率与准确性。
数据集最近研究
最新研究方向
随着大型语言模型在司法与财税领域的广泛应用,墨西哥联邦法律数据集Lex MX的诞生标志着拉丁美洲法律数字化转型的里程碑。该数据集将316部现行联邦法律以结构化Markdown格式每日自动同步,并经由Git版本控制追溯每一次立法修订的精确时间线,直接解决了传统PDF法律文本难以被AI高效调用、版本混乱的关键痛点。当前前沿研究围绕构建可靠的墨西哥法律检索增强生成系统展开,特别聚焦于利用数据集内的层级语义结构(如标题、章节、条款)提升大模型对复杂税法条文(如《所得税法》中扣除条款、《增值税法》中税率计算)的零误差引用能力。同时,研究人员正探索将该数据集与司法判决语料(如联邦司法公报)进行跨模态对齐,以支持自动化的法律推理与合规审查,为墨西哥财税科技、劳动法咨询及立法影响评估提供可复现的基准语料,推动拉丁美洲数字法治迈向标准化、开放化的新阶段。
以上内容由遇见数据集搜集并总结生成


