
遇见数据集

stackexchange-codereview-sandboxes-verified

收藏
Hugging Face2026-07-20 更新2026-07-21 收录
官方服务:

资源简介:

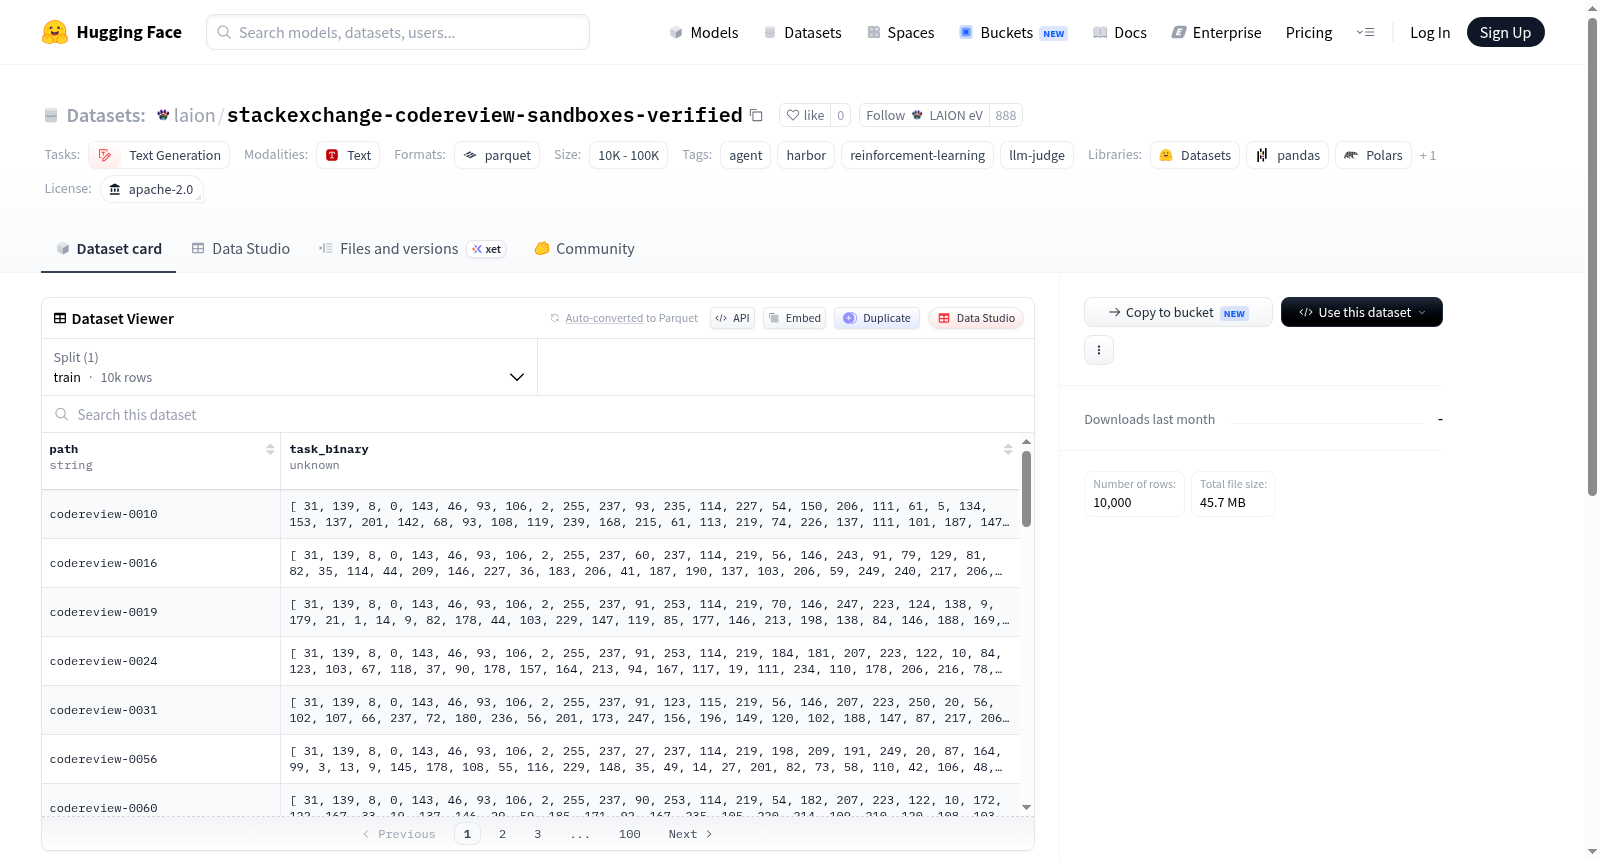
该数据集名为laion/stackexchange-codereview-sandboxes-verified,是一个Harbor任务二进制数据集,专为文本生成和代理任务设计,特别适用于强化学习场景。数据集包含10,000个任务,每个任务由path(字符串类型)和task_binary(gzip压缩的tar格式)两列组成,遵循标准的Harbor/TaskTrove任务模式。数据来源于StackExchange的Code Review板块,其中用户提交工作代码供审查,数据集从DCAgent/stackexchange-codereview-sandboxes-skywork-response重新打包而来,用LLM评判器替换了原有的Skywork验证器,同时保留了任务指令文件instruction.md和共享的ubuntu:24.04环境。每个任务都集成了一个LLM评判验证器,该验证器基于OpenThoughts-Agent框架的verifiers/llm_judge.py实现。在验证过程中,系统会读取代理生成的/app/response.txt文件以及/tests/verifier_data.json(包含任务指令和适配的评分标准),通过litellm调用LLM评判器(默认使用openai/gpt-4o-mini模型)进行评估,并将一个0.0到1.0之间的奖励分数写入/logs/verifier/reward.txt。使用该数据集需要提供OPENAI_API_KEY,该密钥通过task.toml中的环境变量配置传递给验证器容器,用户还可以通过JUDGE_MODEL可选参数覆盖默认的LLM模型。评分标准涵盖代码审查的多个维度,包括正确性、洞察力、可操作性和相关性。该数据集适用于训练和评估强化学习代理、模拟代码审查任务以及开发基于LLM的自动评判系统。

提供机构:
LAION eV
创建时间:
2026-07-20
原始信息汇总

数据集概述

  • 数据集名称: laion/stackexchange-codereview-sandboxes-verified
  • 许可证: Apache-2.0
  • 任务类别: 文本生成 (text-generation)

数据集内容

该数据集包含 10,000 个任务,属于 Harbor 任务二元分类数据集。每个任务包含两列:

  • path (字符串类型)
  • task_binary (gzip tar 格式)

数据来源与构建

  • 任务来自 Code Review StackExchange 帖子,内容为用户提交工作代码以寻求审查。
  • 数据从 DCAgent/stackexchange-codereview-sandboxes-skywork-response 重新打包,将原有的 Skywork 验证器替换为 LLM 法官。
  • 保留了 instruction.md 和共享的 ubuntu:24.04 环境。

验证机制

每个任务的沙箱都附带一个 LLM 法官验证器,该验证器源自 OpenThoughts-Agent 的 data.nemotron_gym 框架(位于 verifiers/llm_judge.py)。

在验证时:

  • tests/test_state.py 读取代理生成的 /app/response.txt 以及 /tests/verifier_data.json(包含任务指令和改编的评分标准)。
  • 通过 litellm 调用 LLM 法官(默认模型为 openai/gpt-4o-mini)。
  • 输出一个 0.0 到 1.0 之间的奖励值,写入 /logs/verifier/reward.txt

注意事项:在试验时需要设置 OPENAI_API_KEY,该密钥通过 task.toml[verifier].env 传递到验证器容器中。也可以通过 JUDGE_MODEL 可选地覆盖默认模型。

评分标准

评分标准涵盖四个维度:正确性 (correctness)、洞察力 (insight)、可操作性 (actionability)、相关性 (relevance)。
搜集汇总
数据集介绍
stackexchange-codereview-sandboxes-verified 数据集图片
构建方式
该数据集源自Code Review StackExchange社区中用户提交的代码审查帖子,原始数据经DCAgent/stackexchange-codereview-sandboxes-skywork-response进行重包装。在构建过程中,原有的Skywork验证器被替换为基于大语言模型的评判机制(LLM judge),并保留了原始的instruction.md与共享的ubuntu:24.04环境。每个任务沙箱内置了从OpenThoughts-Agent框架移植而来的LLM评判验证器,于验证时读取智能体生成的回复文件及验证数据,调用litellm默认的GPT-4o-mini模型进行评判,最终将0.0至1.0的奖励值写入指定日志文件。
特点
该数据集共包含一万个二元任务,遵循Harbor/TaskTrove任务架构,每个任务包含路径与任务文件两列。其核心特色在于采用LLM评判机制替代传统代码验证器,基于正确性、洞察力、可操作性与相关性四项指标对代码审查质量进行评分。模型在推理时需提供OpenAI API密钥,该密钥通过任务配置文件传播至验证容器,并支持通过环境变量自定义评判模型。
使用方法
使用者需首先配置OpenAI API密钥,并在任务配置文件的验证器环境变量区域进行声明,如需更换评判模型,可通过JUDGE_MODEL环境变量覆盖默认的gpt-4o-mini。数据集中的每个任务均以gzip打包的tar文件形式存储,可通过路径列定位并加载。在强化学习或智能体训练场景下,模型生成的回复将与验证数据中的任务指令和评分标准一同送入LLM评判器,获得量化奖励后用于策略优化。
背景与挑战
背景概述
该数据集由LAION团队于近期创建,旨在为代码审查任务提供标准化的强化学习与智能体训练基准。其核心研究问题聚焦于如何利用大型语言模型作为裁判(LLM Judge)自动化评估代码审查质量,从而替代传统人工标注或规则验证。数据来源于Code Review StackExchange社区,原始用户提交的实用代码经过重新包装,并引入OpenThoughts-Agent框架的裁判模型进行验证。该数据集在智能体训练与自动化评估领域具有显著影响力,为构建可复现的代码审查智能系统提供了重要基础。
当前挑战
该数据集面临的挑战主要体现在两个方面:在领域问题层面,代码审查任务依赖对逻辑正确性、可维护性等多维度的综合判断,传统自动化方法难以匹配人类专家的深度评估能力;在构建过程中,数据集需克服裁判模型(LLM Judge)的一致性与公平性难题,依赖如GPT-4o-mini等外部API进行验证,这引入了潜在的成本与延迟风险。此外,Sandbox环境(Ubuntu 24.04)的标准化与测试脚本的通用性也构成工程实现上的挑战,确保不同任务在不同环境下输出可靠奖励信号(0.0-1.0)成为关键难点。
常用场景
经典使用场景
在代码质量评估与自动化审查领域,stackexchange-codereview-sandboxes-verified数据集为研究者提供了一片丰饶的实验沃土。作为源自StackExchange Code Review社区的高质量语料库,该数据集将真实的代码审查对话与可执行的沙箱环境巧妙融合,每个任务均配备LLM评判验证器。其最经典的使用场景在于训练和评估基于强化学习的代码审查智能体,使模型能够学习如何撰写富有洞察力、可操作且切中要害的审查意见,同时通过自动化沙箱对审查结果进行量化的奖励打分。
解决学术问题
该数据集直面代码审查自动化这一长期困扰学术界的核心难题,有效缓解了人工标注成本高昂与审查标准不一致的痛点。通过引入LLM评判框架替代Skywork验证器,数据集解决了传统代码审查研究中奖励信号不准确、反馈鲁棒性差的瓶颈问题。其意义在于为强化学习与代码智能的交叉研究提供了可复现、可扩展的基准,推动了学术界在代码审查质量度量、智能体奖励塑造以及人机协作审查范式等方面的理论探索,影响力辐射至软件工程与自然语言处理的交融地带。
衍生相关工作
基于该数据集已衍生出多项开创性工作,其中最显著的是OpenThoughts-Agent框架中关于Harbor任务架构的构建与验证。研究者利用该数据集的LLM评判机制,进一步探索了多阶段强化学习策略在代码审查任务中的应用,衍生出从单一审查到多轮交互审查的范式跃迁。此外,该数据集的沙箱化设计也催生了TaskTrove任务管理体系的标准化,为后续将代码审查与其他AI智能体任务(如代码修改、缺陷定位)进行协同训练奠定了实验基础,并启发了更多关于LLM作为自主验证器在软件工程中角色的深入探讨。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

