MOLE
收藏资源简介:
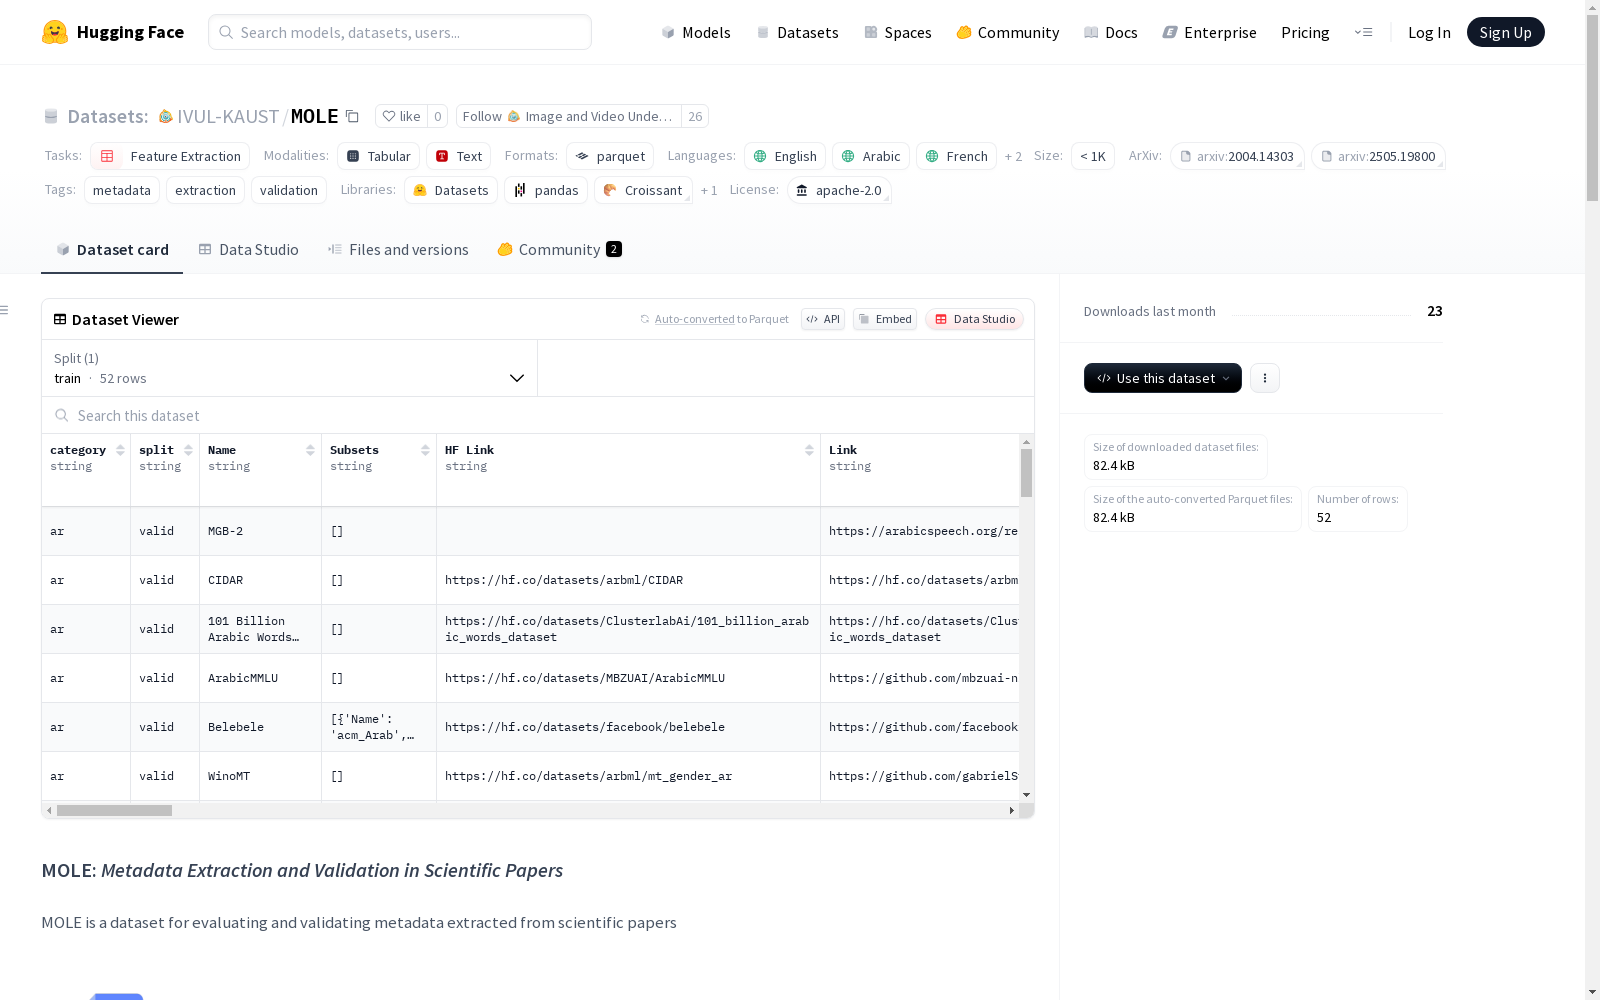
MOLE数据集由KAUST研究机构创建,包含10000个标记的Tokens,用于命名实体识别(NER)和词性标注(PoS)任务。该数据集旨在帮助从科学论文中自动提取元数据属性,支持多语言数据集,包括阿拉伯语、英语、俄语、法语和日语。数据集的创建过程涉及对52篇不同语言的论文进行手动标注,并使用结构化模式进行元数据属性的提取和验证。MOLE数据集的发布旨在促进科学研究的可发现性和可重复性,并推动基于大语言模型的信息提取技术的发展。
The MOLE dataset was developed by King Abdullah University of Science and Technology (KAUST). It contains 10,000 annotated Tokens, and is targeted at Named Entity Recognition (NER) and Part-of-Speech (PoS) tagging tasks. This dataset is designed to facilitate automatic metadata attribute extraction from scientific papers, and is a multilingual resource covering Arabic, English, Russian, French and Japanese. The construction of the dataset entails manual annotation of 52 papers written in different languages, alongside extraction and validation of metadata attributes via structured schemas. The release of the MOLE dataset aims to enhance the discoverability and reproducibility of scientific research, and advance the development of information extraction technologies based on Large Language Models (LLMs).
MOLE数据集概述
📌 基本信息
- 名称: MOLE (Metadata Extraction and Validation in Scientific Papers)
- 用途: 评估和验证从科学论文中提取的元数据
- 语言: 英语(en)、阿拉伯语(ar)、法语(fr)、日语(jp)、俄语(ru)
- 数据规模: <1K样本
- 许可证: Apache 2.0
- 任务类别: 特征提取
📋 数据集结构
主要属性
- Name (str): 数据集名称
- Subsets (List[Dict[Name, Volume, Unit, Dialect]]): 数据集的方言子集
- Link (url): 数据集访问链接
- HF Link (url): Huggingface数据集链接
- License (str): 数据集许可证
- Year (date[year]): 数据集发布年份
- Language (str): 数据集包含的语言
- Dialect (str): 数据集的方言
- Domain (List[str]): 数据集的来源
- Form (str): 数据形式
- Collection Style (List[str]): 数据收集方式
- Description (str): 数据集简要描述
- Volume (float): 数据集大小
- Unit (str): 数据集包含的示例类型
- Ethical Risks (str): 数据集的伦理风险级别
- Provider (List[str]): 数据集提供者
- Derived From (List[str]): 用于创建该数据集的数据集
- Paper Title (str): 论文标题
- Paper Link (url): 论文链接
- Script (str): 数据集脚本
- Tokenized (bool): 数据集是否已分词
- Host (str): 数据集托管仓库名称
- Access (str): 数据集可访问性
- Cost (str): 数据集费用(若非免费)
- Test Split (bool): 是否包含训练/验证和测试分割
- Tasks (List[str]): 数据集适用的NLP任务
- Venue Title (str): 论文发表的会议/期刊标题
- Venue Type (str): 会议/期刊类型
- Venue Name (str): 论文发表的会议/期刊全称
- Authors (List[str]): 论文作者
- Affiliations (List[str]): 作者所属机构
- Abstract (str): 论文摘要
📁 加载数据集
python from datasets import load_dataset dataset = load_dataset(IVUL-KAUST/mole)
⛔️ 局限性
- 数据集包含52篇标注论文,可能不足以全面评估大型语言模型(LLMs)
🔑 许可证
- 许可证类型: Apache 2.0
- 许可证链接: https://www.apache.org/licenses/LICENSE-2.0
引用
bibtex @misc{mole, title={MOLE: Metadata Extraction and Validation in Scientific Papers Using LLMs}, author={Zaid Alyafeai and Maged S. Al-Shaibani and Bernard Ghanem}, year={2025}, eprint={2505.19800}, archivePrefix={arXiv}, primaryClass={cs.CL}, url={https://arxiv.org/abs/2505.19800}, }