
DopeorNope/FFT-naive-50k-mmlupro
收藏官方服务:
资源简介:
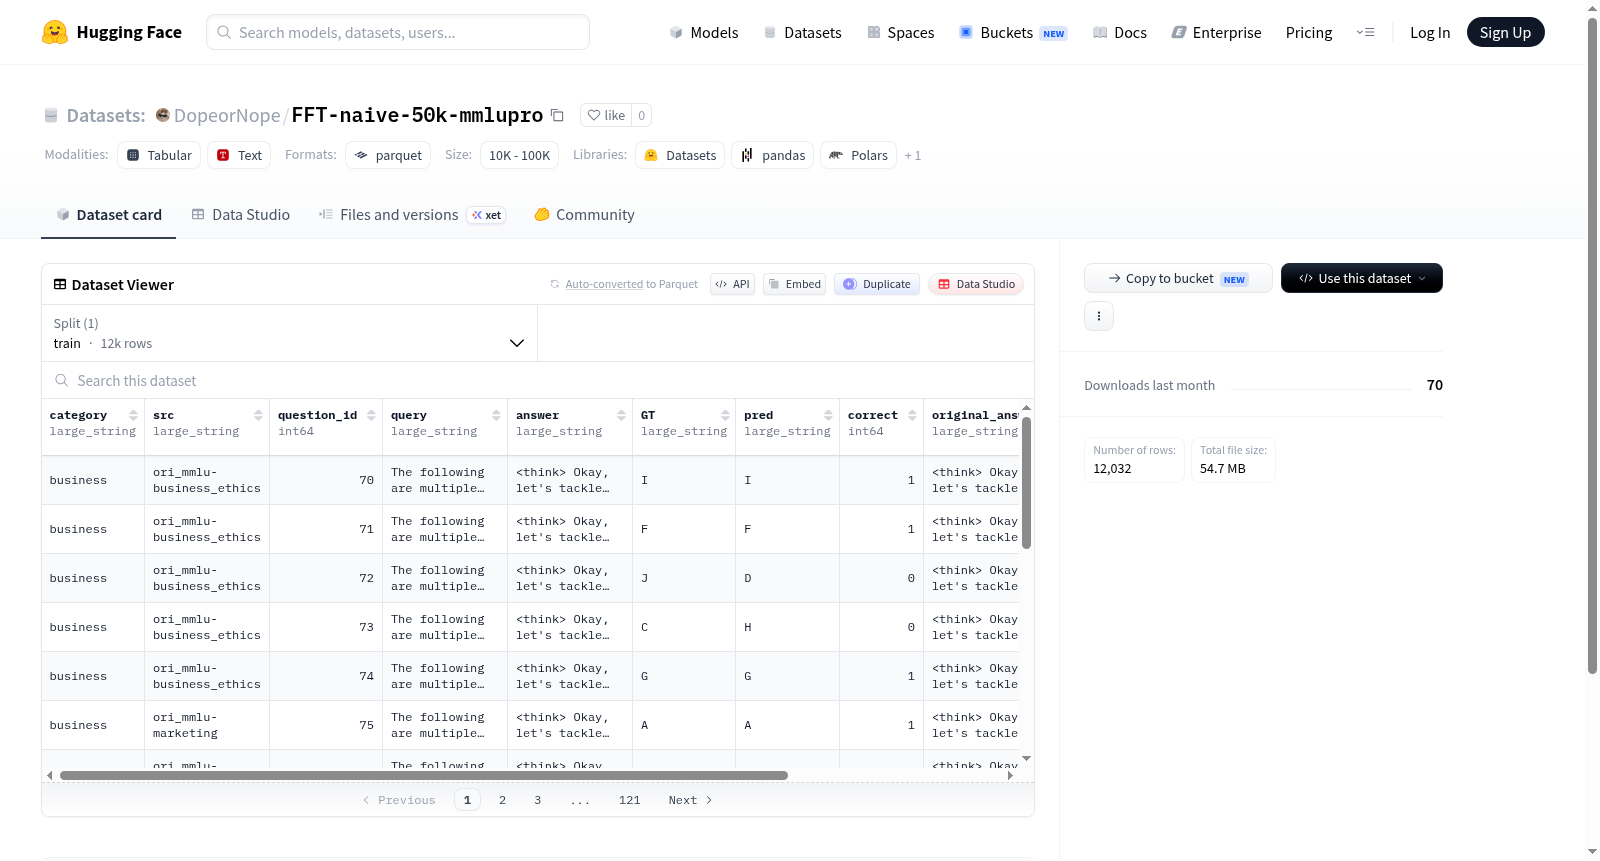
该数据集包含用于问题回答任务评估的数据,特征包括类别、来源、问题ID、查询、答案、正确答案(GT)、预测答案、正确性标志、原始答案、生成答案和解析正确性。数据集共有12032个训练示例,用于训练或测试模型在回答查询时的准确性。
This dataset contains data for evaluating question-answering tasks, with features including category, source, question ID, query, answer, ground truth (GT), predicted answer, correctness flag, original answer, generated answer, and parsed correctness. It consists of 12032 training examples and is used for training or testing model accuracy in responding to queries.
提供机构:
DopeorNope搜集汇总
数据集介绍
构建方式
FFT-naive-50k-mmlupro数据集基于大规模多任务语言理解基准MMLU-Pro构建,旨在评估与提升模型在复杂知识推理任务中的表现。数据集通过从MMLU-Pro原始题库中精选约50,000道题目,并采用朴素微调(FFT)策略进行标注与处理,最终筛选出12,032条高质量训练样本。每条样本包含问题类别、原始问题、标准答案、模型预测结果及正确性标识,兼顾了数据规模与标注准确性。
使用方法
使用本数据集时,可直接通过HuggingFace Datasets库加载默认配置下的训练分片,字段如'query'作为输入文本,'GT'或'original_answer'作为监督标签。用户可根据需要选择'correct'或'correct_parsed'字段筛选正确样本进行训练,或利用'pred'与'gen_answer'字段分析模型错误模式。数据集以parquet格式存储,便于高效读取与分布式处理,适用于LLM微调、评估及对比实验。
背景与挑战
背景概述
在大型语言模型(LLM)飞速演进的浪潮中,如何系统性地评估模型的复杂推理与多任务泛化能力成为研究焦点。FFT-naive-50k-mmlupro数据集应运而生,旨在填补现有基准测试在广度和深度上的空白。该数据集由研究团队精心构建,基于MMLU-Pro框架进行了扩展与细化,涵盖了50,000个问答对,涉及科学、人文、数学等多个领域,并引入了细粒度的生成答案与正确答案对比机制。通过记录模型预测及正确性标记,该数据集不仅服务于传统选择题式评测,更推动了对LLM开放式生成能力的量化研究。其发布为对比不同微调策略(如FFT全参数微调)的效果提供了标准化测试平台,在社区内引起了广泛关注,成为评估模型知识掌握与逻辑推理水平的重要工具。
当前挑战
构建FFT-naive-50k-mmlupro数据集面临双重挑战。首先,在领域问题层面,传统评测多聚焦于封闭式答案匹配,难以捕捉LLM在复杂、多步推理中的真实表现——模型可能正确回答选择题,却在生成解释时暴露逻辑漏洞,因此需要设计兼顾正确性与答案一致性(如original_answer与gen_answer的差异分析)的评估体系。其次,构建过程中需应对大规模数据标注的噪声控制,确保每道题目的答案(GT)和模型预测(pred)对齐,并处理多格式答案的标准化解析(如correct_parsed字段)。此外,如何在50k数量的限制下平衡各学科分布的均衡性,避免对特定领域的过拟合,也是数据策划阶段的核心难点。
常用场景
经典使用场景
FFT-naive-50k-mmlupro数据集是基于大规模多任务语言理解基准(MMLU-Pro)构建的推理轨迹数据集,专为探索和提升大语言模型的逐步推理能力而设计。该数据集收录了约5万条经过傅里叶变换(FFT)增强的问答对,覆盖了广泛的知识领域。其最经典的应用场景在于训练和评估语言模型在复杂推理任务中的表现,尤其适用于需要模型进行多层次逻辑推导、知识整合与精确判断的学术场景。研究者通常利用该数据集对预训练模型进行微调,以强化模型在科学、人文、法律等专业领域的推理准确性,从而推动语言模型向更高层次的认知智能迈进。
解决学术问题
该数据集直面当前大语言模型在推理任务中存在的关键挑战,即模型在简单问答中表现优异,但在面对需要深度推理、多步计算或跨领域知识融合的复杂问题时,往往出现逻辑断层或事实幻觉。FFT-naive-50k-mmlupro通过提供大规模、高质量的逐步推理示例,有效缓解了上述问题。它为学术界提供了一套标准化的评估基准,使得研究者能够量化模型在推理一致性、知识调用准确性和错误纠偏能力等方面的进步。此举不仅推动了推理增强技术的发展,还深化了学界对语言模型认知边界的理解,为构建更加可靠和可解释的人工智能系统奠定了重要基础。
实际应用
在实际应用层面,FFT-naive-50k-mmlupro数据集的影响力远不止于实验室研究。它可直接赋能智能教育系统的开发,例如用于构建自适应学习工具,为学生提供分步解题的个性化辅导,或辅助教师评估学生的逻辑思维水平。此外,在智能客服、法律咨询和医疗辅助诊断等专业领域,该数据集所训练的模型能够提供更具洞察力的结构化答复,而非简单的关键词匹配。金融风控和科学研究中的复杂数据分析场景同样能从该数据集的推理范式中获益,通过模拟人类专家的思考链条,提升自动决策的准确性与可信度。
数据集最近研究
最新研究方向
在大型语言模型(LLM)加速推理的浪潮中,FFT-naive-50k-mmlupro数据集的出现为浮点运算(FFT)在推理效率优化中的性能研究提供了基准。该数据集聚焦于MMLU-Pro的多学科知识推理任务,通过记录模型预测与真实答案的对比,支撑对FFT加速效果与准确率权衡的实证分析。其包含的类别、问题及推理轨迹等字段,为探索Transformer架构下FFT策略的合理性、延迟改进及知识保留度开辟了前沿路径,成为推动低延迟、高语义理解推理系统发展的重要测试床。
以上内容由遇见数据集搜集并总结生成


