
EyeDataHub Ophthalmology Dataset Catalog
收藏官方服务:
资源简介:
一个手动整理的眼科数据集快照,包含451条记录,涵盖18个主要类别,帮助用户从官方来源查找、检查、引用和获取眼科数据集。
A manually curated snapshot of ophthalmology datasets containing 451 records across 18 major categories, which assists users in searching, reviewing, citing, and accessing such datasets from official sources.
创建时间:
2026-07-27
原始信息汇总
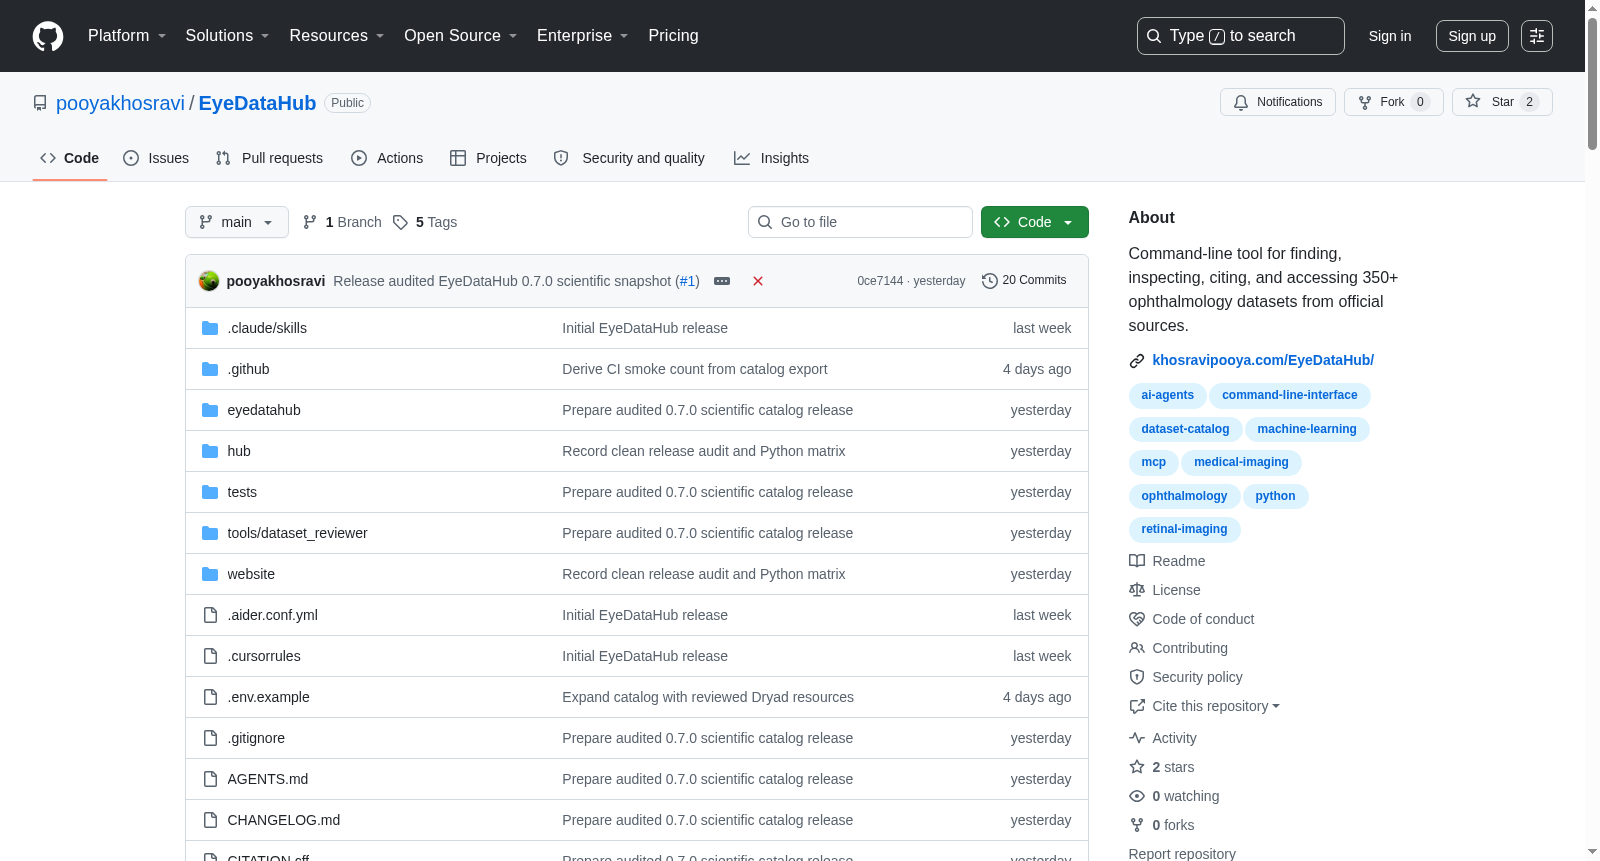
EyeDataHub是一个眼科数据集索引与获取工具,不托管或重新分发第三方数据集,而是帮助用户发现、检查、引用、预检和从官方来源获取受支持的数据资源。
基本特性
- 版本化命令行工具:支持社区扩展,对来源条款和访问方式敏感
- 当前版本:0.7.0版本,包含451条人工来源核查记录
- 技术栈:Python 3.10+,测试覆盖Python 3.10至3.14
- 代码许可:MIT许可证,目录元数据采用CC BY 4.0
- 科学归档:可通过doi:10.5281/zenodo.21798623获取不可变的目录状态
目录内容
- 记录范围:451条记录分布在18个主要类别,涵盖446个精确定义的数据集族
- 来源方式分布(截至2026年8月2日):
- 33条使用来源托管文件、Google Drive或GitHub
- 350条使用仓库或挑战平台API/客户端
- 68条使用手动、受控、机构或作者联系程序
- 访问要求分布:
- 47条无需账户或手动审批
- 356条需要即时自助认证
- 11条需要用户点击确认
- 29条需要受控或手动访问
- 8条需要联系作者
数据关系审计
- 包含145条有向断言,涉及96条记录
- 33条记录有文档化的派生关系,包括17个注释层中的16个
- 3条记录作为独立组件单独索引
- 保留2个早期版本和2个未修改的仓库副本作为链接
数量信息
- 324条记录有主要报告数量
- 保留396条数量证据行
- 总量仅在精确单位内报告,因为相关资源可能重叠且不同模态使用不同计数单位
检索来源
- 在Dryad、Mendeley Data、Kaggle、Figshare和Hugging Face中检索到18,737条记录
- 识别出288条符合条件的仓库记录,163条来自其他文档化检索路径
- 145条Dryad候选记录中保留82条,排除63条
获取功能
- 预检:下载前展示原始来源条款、证据URL、适用范围、注册/认证/令牌/点击确认等限制
- 安全机制:阻止手动授权路线,不接受协议,成功传输后写入来源清单
- 支持后端:Figshare、Zenodo、Mendeley Data、Dryad、Kaggle、Hugging Face、PhysioNet、Dataverse、Synapse、GitHub、Google Drive和来源托管文件链接
使用方式
- 命令行:支持搜索、显示、引用、预检和下载等只读操作
- Python API:提供
REGISTRY、acquire_dataset和preflight_dataset接口 - 可选客户端:通过
.[kaggle]、.[huggingface]、.[synapse]或.[full]扩展
注意事项
- 不包含第三方数据集文件
- 不代替用户确定法律许可、伦理可接受性、数据质量、临床有效性或科学适宜性
- 自动认证类别和平台支持因记录而异,通过
acquisition_support和loader_test_scope暴露
搜集汇总
数据集介绍
构建方式
眼底数据仓库(EyeDataHub)是一个基于命令行、面向眼科医学影像领域的版本化数据目录工具,其背后依托的是人工精选与源审查相结合的数据集快照。该目录包含了451条经过人工源核查的记录,覆盖18个主要类别,并映射至446个狭义数据集家族。构建过程严格遵循来源可追溯原则,通过多源检索(如Dryad、Mendeley Data、Kaggle、Figshare和Hugging Face)获取了18,737条候选记录,经过人工与模型联合筛查、去重及源验证,最终保留了288条来自仓库的记录,另有163条源自其他途径。此外,系统还详细审查了数据集间的派生、版本、镜像及队列重叠关系,构建了包含145条有向断言的图谱,并针对资源身份与数量进行了独立审计,确保了目录的完整性与准确性。
使用方法
EyeDataHub的使用方式便捷且安全。用户可通过命令行工具执行只读的搜索、查看、引用与预检操作,例如`eyehub search --modality oct`可筛选特定模态的数据集,`eyehub show fives --json`用于查看详情,`eyehub cite fives --format bibtex`生成引用格式。下载操作通过`eyehub download`显式执行,且支持干运行模式进行预检,确保数据获取的透明性。同时,系统提供了Python API,允许开发者集成`preflight_dataset`与`acquire_dataset`函数,实现自动化工作流。此外,该工具还支持多种后端平台(如Zenodo、Kaggle、Hugging Face等),并可通过环境变量管理凭证,但绝不存储敏感信息。对于需要手动或受控访问的资源,系统会返回结构化状态与指引,而非模拟成功,从而保障了使用的合规性与可靠性。
背景与挑战
背景概述
EyeDataHub眼科学数据集目录是一个由社区可扩展、基于版本控制的命令行工具,其背后是一个人工精选的眼科学数据集快照,旨在帮助用户查找、检查、引用、预检并从官方来源获取受支持的资源。该工具由Pooyakhosravi等人于2026年创建,截至2026年8月2日,目录包含451条经过人工源验证的记录,涵盖18个主要类别,代表446个狭义定义的数据集族。EyeDataHub的核心研究问题在于为眼科领域的研究人员提供一个统一、透明且可审计的数据集发现与获取通道,以应对眼科数据分散、来源多样、访问条件复杂等挑战。该工具通过记录源条款、访问方式和数据关系,促进了数据引用的规范性和可复现性,对眼科人工智能研究社区产生了显著影响,尤其是推动了数据共享的标准化实践。
当前挑战
EyeDataHub面临的核心挑战包括领域问题和构建过程两方面。领域问题方面,眼科数据集分散于多个平台(如Dryad、Mendeley Data、Kaggle等),且存在重复、版本混乱、派生关系复杂等问题,导致研究人员难以高效定位合适数据并确保合规使用。构建过程中,团队需处理大量候选记录(如Dryad搜索返回18,737条),通过人工筛选、去重和源审查,但面临非人类数据、分析性存储的排除,以及部分记录访问需手动审批或作者联系等障碍。此外,数据集数量统计因单位不同而难以统一,且需区分当前版本与历史版本,确保目录的准确性和时效性。这些挑战促使EyeDataHub采用严格的人工审查流程和结构化审计,但仍需持续维护以跟踪新数据和更新源条款。
常用场景
经典使用场景
EyeDataHub作为一项精心策划的眼科学数据集目录工具,其核心应用场景在于为研究者提供一站式的数据集检索、审查与获取服务。凭借其收录的451条经人工核验的数据集记录,覆盖18个主要类别,该工具支持基于模态、任务及访问权限等条件的精细查询,配合命令行界面,极大简化了从海量眼科数据资源中定位合适数据集的过程,成为连接数据生产者与使用者的关键桥梁。
解决学术问题
该目录有效解决了眼科学领域数据资源分散、标准不一、获取路径复杂的系统性难题。通过提供统一的元数据描述、来源合法性校验及获取前预检,EyeDataHub显著降低了数据集寻址与合规使用的门槛,促进了研究的可复现性。其数据来源与使用条款的透明化记录,也助力科研人员规避知识产权风险,提升了学术研究的严谨性与数据共享的效率。
实际应用
在实际应用中,EyeDataHub可服务于临床研究、医学影像人工智能模型开发等多元场景。研究人员能够快速筛选出符合伦理与授权要求的德克萨斯数据集,用于训练眼底图像分类或分割模型。此外,该工具支持从官方源直接获取数据,并生成来源清单,为多中心研究中的数据集溯源与审计提供了便利,进而加速了从数据到临床决策支持工具的转化进程。
数据集最近研究
最新研究方向
随着眼科影像大数据在人工智能辅助诊疗中的深度应用,数据资源的可发现性与可获取性成为制约研究转化的重要瓶颈。EyeDataHub作为一款具备版本控制、社区可扩展且对源条款与访问方式高度敏感的目录工具,其最新研究方向聚焦于构建一个经人工严格核验的眼科数据集快照,以命令行方式支持用户对451项已审阅记录进行查找、检视、引用与预检。该目录系统不仅细致区分了数据集的派生、子集、镜像及队列重叠等复杂关系,还通过量化证据审查与多平台检索整合,显著提升了数据集的透明度和可复现性。其前沿意义在于,通过将访问需求与后台来源解耦,并明确标识非商业及衍生限制,为眼科领域的数据共享与合规使用树立了新的标准,从而推动多中心、跨模态的眼科AI模型训练与验证,加速精准眼科医学的循证进程。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


