
遇见数据集

Mattysmittttt/camonet-synthetic

收藏
Hugging Face2026-04-30 更新2026-05-03 收录
官方服务:

资源简介:

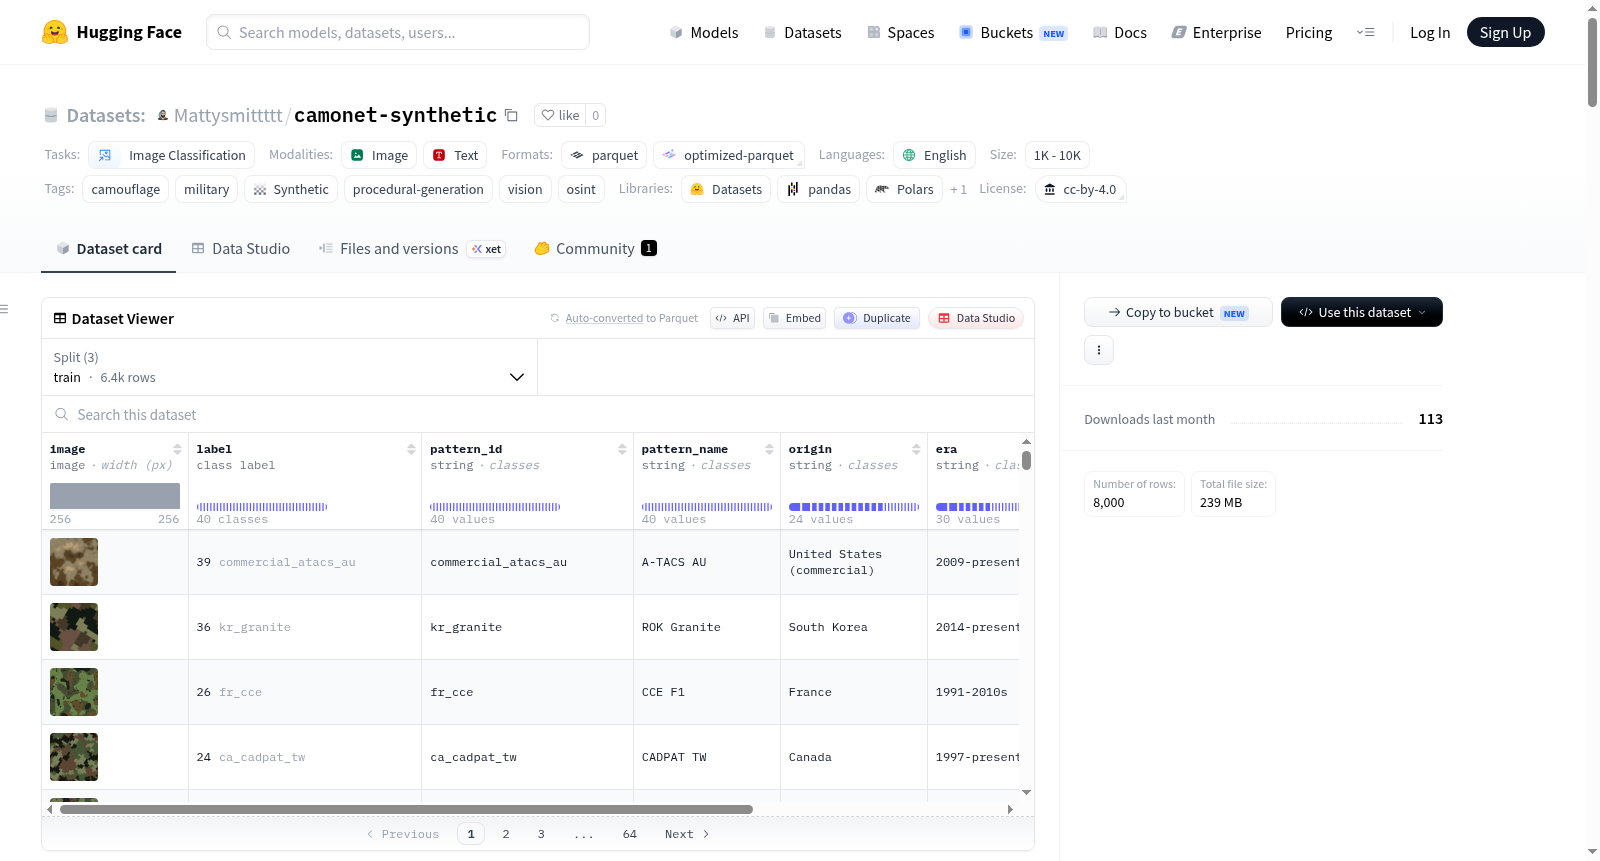
CamoNet Synthetic是一个程序生成的军事伪装图案数据集,包含40种历史和当代的伪装图案,每种图案有200个样本,总计8,000张256×256的RGB图像。每张图像都标注了来源、时代和视觉家族。数据集完全由合成图像组成,通过小型Python脚本生成,确保了数据的可重复性和自由再分发性。数据集适用于图像分类任务,主要用于增强现实照片数据集、预训练视觉模型、调试管道和进行类别平衡实验。然而,它不适合用于生产级OSINT分类器的独立训练或需要色彩保真度的法医/法律图案归属工作。

CamoNet Synthetic is a procedurally-generated military camouflage pattern dataset containing 40 historical and contemporary patterns with 200 samples each, totaling 8,000 256×256 RGB images. Each image is tagged with origin, era, and visual family. The dataset is fully synthetic, generated from small Python recipes per pattern family, ensuring reproducibility and free redistribution. It is suitable for image classification tasks, primarily for augmenting real photo datasets, pre-training vision models, debugging pipelines, and conducting class-balance experiments. However, it is not suitable for standalone training of production OSINT classifiers or forensic/legal pattern attribution work requiring colorimetric fidelity.
提供机构:
Mattysmittttt
搜集汇总
数据集介绍
Mattysmittttt/camonet-synthetic 数据集图片
构建方式
CamoNet-Synthetic数据集通过程序化生成技术构建,涵盖40种历史及现代军用迷彩图案。每种图案由七类生成器(如数字、斑点、笔触、多地形、林地、沙漠、干旱)根据图案的十六进制调色板和确定性种子参数化渲染。随后,每张图像经过随机角度旋转、中心裁剪至256×256像素,并对亮度、对比度及色调进行微调以增强多样性。调色板本身每样本扰动±8 RGB值,确保同图案的不同样本色彩略有差异。数据集包含8,000张图像,按类别分层划分为80%训练集、10%验证集和10%测试集。
特点
该数据集具备高度可控性和可复现性,每张图像由图案ID和种子唯一确定,支持从源代码重新生成。其覆盖广泛的迷彩家族——数字、斑点、笔触、多地形、林地、沙漠及干旱——共12类。生成过程引入随机旋转和色彩抖动,模拟真实世界变化。数据集非真实感渲染,不捕捉织物纹理、光照或磨损,但提供完美标注,适用于数据增强、预训练预热、管道测试和类别平衡实验,而非生产级OSINT分类或法医鉴定。
使用方法
用户可通过HuggingFace Datasets库轻松加载,命令为`load_dataset("Mattysmittttt/camonet-synthetic")`。加载后即可访问训练、验证、测试分片,每样本包含图像、标签、图案ID、名称、起源、年代、家族及种子信息。对于复现需求,可使用`camonet_synth.pipeline.render`函数基于图案ID和种子生成图像。完整数据集构建命令为`python scripts/build_dataset.py --per-pattern 200`,在消费级CPU上约需1分钟。数据集遵循CC-BY-4.0许可,可自由使用、再分发和修改。
背景与挑战
背景概述
军用伪装图案的识别在视觉情报分析与军事目标检测中具有重要价值,然而真实世界的伪装图案数据因受限于军事保密性、图像采集的伦理争议以及环境多样性稀少,导致公开可用的标注数据集极为匮乏。为弥合这一鸿沟,研究者Matt Smith于2026年发布了CamoNet Synthetic数据集,该数据集由程序化生成技术构建,涵盖40种历史与现代军用伪装图案,每类包含200个256×256 RGB图像样本,总计8000幅。数据集基于七类视觉家族(数码斑点、晕染斑点、笔触纹、多地形融合、林地纹、沙漠纹及干旱纹)进行精细化生成,并为每张图像标注了图案来源国家、所属年代与视觉家族标签,旨在为伪装图案分类研究提供大规模、可复现且无版权争议的基准训练资源。作为CamoNet模型的补充合成版本,该数据集已在HuggingFace平台开源,遵循CC-BY-4.0许可,为计算机视觉领域解决军事伪装识别这一长尾问题注入了可控且可扩展的数据供给。
当前挑战
当前伪装图案识别研究面临的核心挑战在于:真实场景中伪装图案极易受光照、阴影、布料褶皱、磨损褪色及人体姿态等环境因素干扰,导致基于合成图案训练的模型在野外图像上的泛化能力显著下降。CamoNet Synthetic虽通过随机旋转、中心裁剪及色彩微调等方式模拟部分视觉变化,但其合成图像缺乏真实织物质感、光泽与缝合线等细微特征,难以捕捉实际伪装服饰在物理环境中的表现。此外,数据构建过程中面临图案生成算法对每种伪装家族需单独调参的复杂性,例如数码斑点的像素化网格分辨率、斑点族的斑块尺寸与形状控制、笔触纹的各向异性方向设定等参数均需手工调整以保证视觉逼真度,这限制了数据集的规模化扩展。同时,伪真颜色仅为公共参考近似值,而非光谱测量结果,无法支持需要色度精确性的法医级图案归因任务。
常用场景
经典使用场景
在军事视觉智能研究领域,CamoNet-Synthetic数据集以程序化生成技术,精心构建了涵盖40种经典与当代迷彩图案的8000张256×256 RGB图像。作为Camopedia知识库与计算机视觉的桥梁,该数据集最经典的使用场景是作为迷彩图案分类任务的基准测试平台——研究者可基于其完整的层级化标签体系(包括图案家族、历史年代、起源国别等多维标注),系统性地评估不同深度学习模型在迷彩纹理识别上的表现。其完全确定的生成流程与随机种子机制,确保了实验的可复现性,为迷彩视觉特征分析提供了干净、可控的标准化测试环境。
衍生相关工作
作为开源社区的重要基础资源,CamoNet-Synthetic已催生了一系列衍生工作。其配套的CamoNet模型基于该合成数据与真实照片的混合训练,探索了合成数据对实拍图像分类的迁移学习增益,成为军事视觉领域域适应方法的典型范例。在数据生成方法论层面,该项目对不同迷彩家族(如斑点式、数字式、笔触式)的独立渲染算法被多项研究引用,用于构建更大规模的纹理生成框架。此外,该数据集也启发了伪装检测领域中的对抗攻击研究——研究者利用其已知标签的纯净特性,设计针对迷彩分类系统的鲁棒性测试方案。在工业界,部分测绘和安防公司已采用其生成管线作为内部仿真数据的制作原型,推动了合成数据在军事视觉工程中的标准化应用。
数据集最近研究
最新研究方向
在军事伪装模式识别的前沿探索中,CamoNet Synthetic数据集通过程序化生成技术,系统性地覆盖了数字、斑点、丛林等7大视觉家族的40种历史与现代迷彩图案,为计算机视觉在军事侦察与敌对目标识别领域开辟了新的数据支撑路径。该数据集基于确定性种子与参数化渲染管线,实现了高保真的纹理复现与可复现性,结合随机旋转、裁剪与色彩扰动策略模拟了战场环境的多样性,显著提升了伪装分类任务的鲁棒性。当前研究热点聚焦于将其与真实照片联合训练,通过预训练预热与数据增强手段,有效增强了模型对迷彩图案家族结构与色板特征的感知能力,为开源情报分析、军事装备识别及自动化监视系统提供了可扩展的基准测试与类平衡实验平台,推动了伪装对抗与视觉伪装检测技术的双向演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

