遇见数据集

Juzzy88/science_dict_full

收藏
Hugging Face2023-08-05 更新2024-03-04 收录
官方服务:

资源简介:

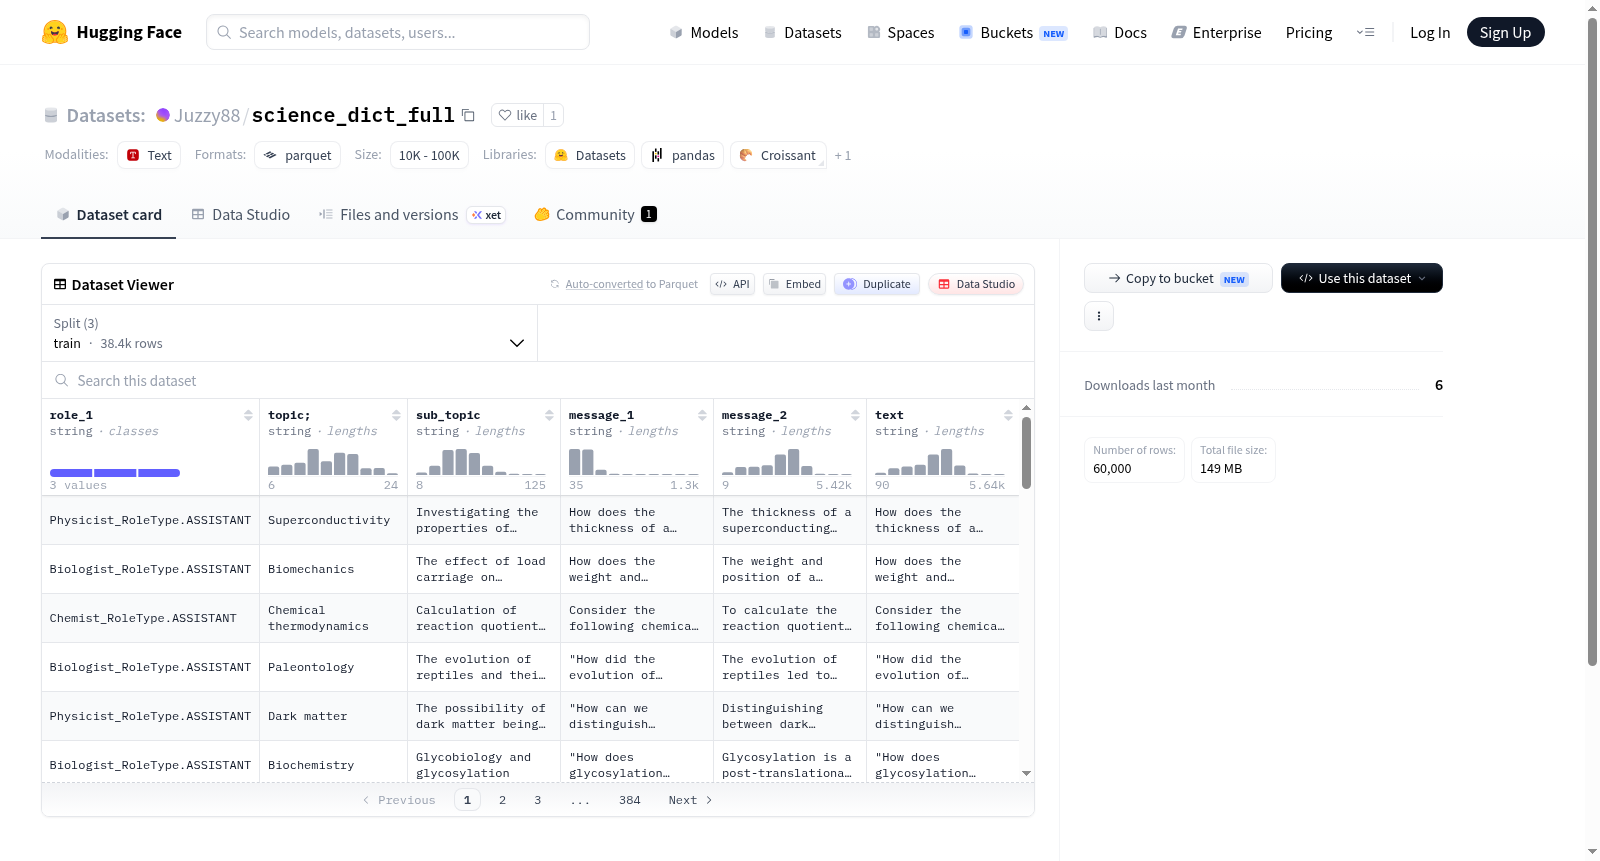
--- dataset_info: features: - name: role_1 dtype: string - name: topic; dtype: string - name: sub_topic dtype: string - name: message_1 dtype: string - name: message_2 dtype: string - name: text dtype: string splits: - name: train num_bytes: 200646759 num_examples: 38400 - name: val num_bytes: 50121062 num_examples: 9600 - name: test num_bytes: 62653743 num_examples: 12000 download_size: 148930334 dataset_size: 313421564 --- # Dataset Card for "science_dict_full" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

数据集信息: 特征字段: - 字段名:role_1 数据类型:字符串(string) - 字段名:topic; 数据类型:字符串(string) - 字段名:sub_topic 数据类型:字符串(string) - 字段名:message_1 数据类型:字符串(string) - 字段名:message_2 数据类型:字符串(string) - 字段名:text 数据类型:字符串(string) 数据集拆分: - 拆分名称:训练集(train) 字节数:200646759 样本数量:38400 - 拆分名称:验证集(val) 字节数:50121062 样本数量:9600 - 拆分名称:测试集(test) 字节数:62653743 样本数量:12000 下载大小:148930334 数据集总大小:313421564 # 数据集卡片:science_dict_full [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

提供机构:
Juzzy88
原始信息汇总

数据集概述

数据集名称

  • 名称: science_dict_full

数据结构

  • 特征信息:
    • role_1: 数据类型 - string
    • topic: 数据类型 - string
    • sub_topic: 数据类型 - string
    • message_1: 数据类型 - string
    • message_2: 数据类型 - string
    • text: 数据类型 - string

数据分割

  • 训练集:
    • 样本数: 38400
    • 数据大小: 200646759 bytes
  • 验证集:
    • 样本数: 9600
    • 数据大小: 50121062 bytes
  • 测试集:
    • 样本数: 12000
    • 数据大小: 62653743 bytes

数据集大小

  • 下载大小: 148930334 bytes
  • 总数据大小: 313421564 bytes
搜集汇总
数据集介绍
Juzzy88/science_dict_full 数据集图片
构建方式
在科学知识图谱构建与自然语言处理交汇的背景下,Juzzy88/science_dict_full数据集应运而生。该数据集通过系统化的多角色对话结构进行构建,每条样本包含role_1、topic、sub_topic、message_1、message_2及text六个字段,其中role_1标识对话发起方的角色,topic与sub_topic共同界定科学主题的层级分类,而message_1、message_2与text则构成对话内容的三元组。数据被划分为训练集(38400条)、验证集(9600条)和测试集(12000条),总样本量达60000条,确保了模型训练、调优与评估的完整性。
特点
该数据集的核心特征在于其精细化的科学领域知识结构化设计。通过topic与sub_topic的双层分类体系,数据覆盖了广泛的科学主题,为跨学科研究提供了丰富的语义线索。每条样本以角色驱动的方式呈现对话逻辑,使得数据不仅包含静态知识,还蕴含交互推理过程。此外,数据集的规模适中,各分片大小均衡(训练集约200MB,验证与测试集合计约112MB),既避免了过大的计算负担,又保证了统计有效性,特别适合用于科学问答、对话生成及知识图谱推理等任务。
使用方法
使用时,可通过HuggingFace的datasets库直接加载该数据集,例如使用load_dataset('Juzzy88/science_dict_full')命令。加载后,用户可根据任务需求灵活提取字段:对于科学对话建模,可组合role_1、message_1和message_2构建输入输出对;对于知识分类任务,可利用topic和sub_topic作为标签。建议在训练前对text字段进行分词与清洗,并利用预置的数据划分(train/val/test)进行标准化的模型评估。数据集的轻量级特性使其适合在单GPU或CPU环境下快速迭代实验。
背景与挑战
背景概述
在科学教育与大语言模型交叉融合的浪潮中,高质量、结构化的科学对话数据成为提升模型专业推理能力的关键资源。Juzzy88/science_dict_full数据集应运而生,由研究团队于近期构建并发布,旨在弥补现有科学语料库在对话角色、主题分层及教学互动方面的不足。该数据集以角色化对话为核心,涵盖广泛科学主题与子主题,精心设计了38400条训练样本、9600条验证样本及12000条测试样本,为科学问答、知识蒸馏及多轮对话系统提供了标准化基准。其影响力在于推动模型从泛化语言理解向领域化、可解释的科学知识传递转型,为AI辅助科学教育研究注入了新的数据动力。
当前挑战
该数据集面临多重挑战。首先,在领域问题层面,科学对话的准确性要求极高,模型需克服知识幻觉与逻辑断裂,确保回答与真实科学原理一致,这超越了传统文本分类或生成任务的难度。其次,构建过程中,角色化对话的多样性难以把控,不同角色(如教师与学生)的语言风格、知识深度及引导策略需精确模拟,以避免语料同质化。此外,主题与子主题的层级划分需兼顾科学体系的严谨性与教学场景的实用性,稍有不慎便会导致知识覆盖偏差。数据规模虽达3亿余字节,但面对科学分支的无限扩展性,仍存在长尾主题稀疏的挑战,影响模型泛化能力。
常用场景
经典使用场景
Juzzy88/science_dict_full数据集以科学对话为核心构建,覆盖多学科主题与子主题,广泛应用于科学文本理解与生成领域。其经典使用场景包括科学问答系统训练、科普内容自动摘要、以及跨学科知识图谱的构建。通过角色化对话结构(role_1、message_1、message_2),该数据集为模型提供了丰富的上下文交互范式,尤其适合微调大型语言模型以提升其在科学领域的事实准确性与逻辑连贯性。
解决学术问题
该数据集有效解决了科学领域语料稀缺与结构化不足的学术难题。传统科学数据集往往聚焦单一学科或缺乏对话形态,而science_dict_full通过层级化主题标签与角色对话设计,为研究提供了多粒度语义对齐的基准。它助力学者探索科学知识的多轮传递机制,并支撑了诸如科学推理、概念解释生成等关键问题的实证分析,显著推动了自然语言处理在专业教育场景中的理论进展。
衍生相关工作
基于Juzzy88/science_dict_full,衍生出多项经典工作,包括科学对话中的知识蒸馏方法、面向多主题的检索增强生成框架,以及跨子主题的迁移学习模型。这些工作进一步探索了角色化对话中的信息压缩与语义保持,并推动了科学领域少样本学习技术的发展。该数据集亦成为评估科学文本生成质量的标准基准之一,促进了可解释性研究在专业语料上的深化。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务