
遇见数据集

sensenova/SenseNova-SI-8M

收藏
Hugging Face2026-05-13 更新2026-05-31 收录
官方服务:

资源简介:

SenseNova-SI-8M是一个用于空间智能研究的官方大规模训练数据集,包含约816万个精心策划的训练样本,覆盖约272万张唯一图像,基于严格的空间能力分类法组织。该数据集用于训练推荐发布的模型SenseNova-SI-1.1-InternVL3-8B,并作为SenseNova-SI系列中空间智能研究的规范训练语料库。数据以JSONL格式存储,每个条目包含唯一标识符id、对话列表conversations和图像路径列表image,其中conversations中的<image>占位符指示图像插入位置。数据集旨在通过多样化数据训练提升多模态基础模型的空间智能能力,支持评估和下游应用。

SenseNova-SI-8M is the official full-scale training dataset for spatial intelligence research, containing approximately 8.16 million carefully curated training samples spanning about 2.72 million unique images, organized under a rigorous taxonomy of spatial capabilities. It is used to train the recommended released model SenseNova-SI-1.1-InternVL3-8B and serves as the canonical training corpus for the SenseNova-SI series in spatial intelligence studies. The data is stored in JSONL format, with each entry including a unique identifier id, a conversations list of dialogue turns, and an image list of file paths, where <image> placeholders in conversations indicate image insertion points. The dataset aims to enhance spatial intelligence in multimodal foundation models through diverse data training, supporting evaluation and downstream applications.
提供机构:
sensenova
搜集汇总
数据集介绍
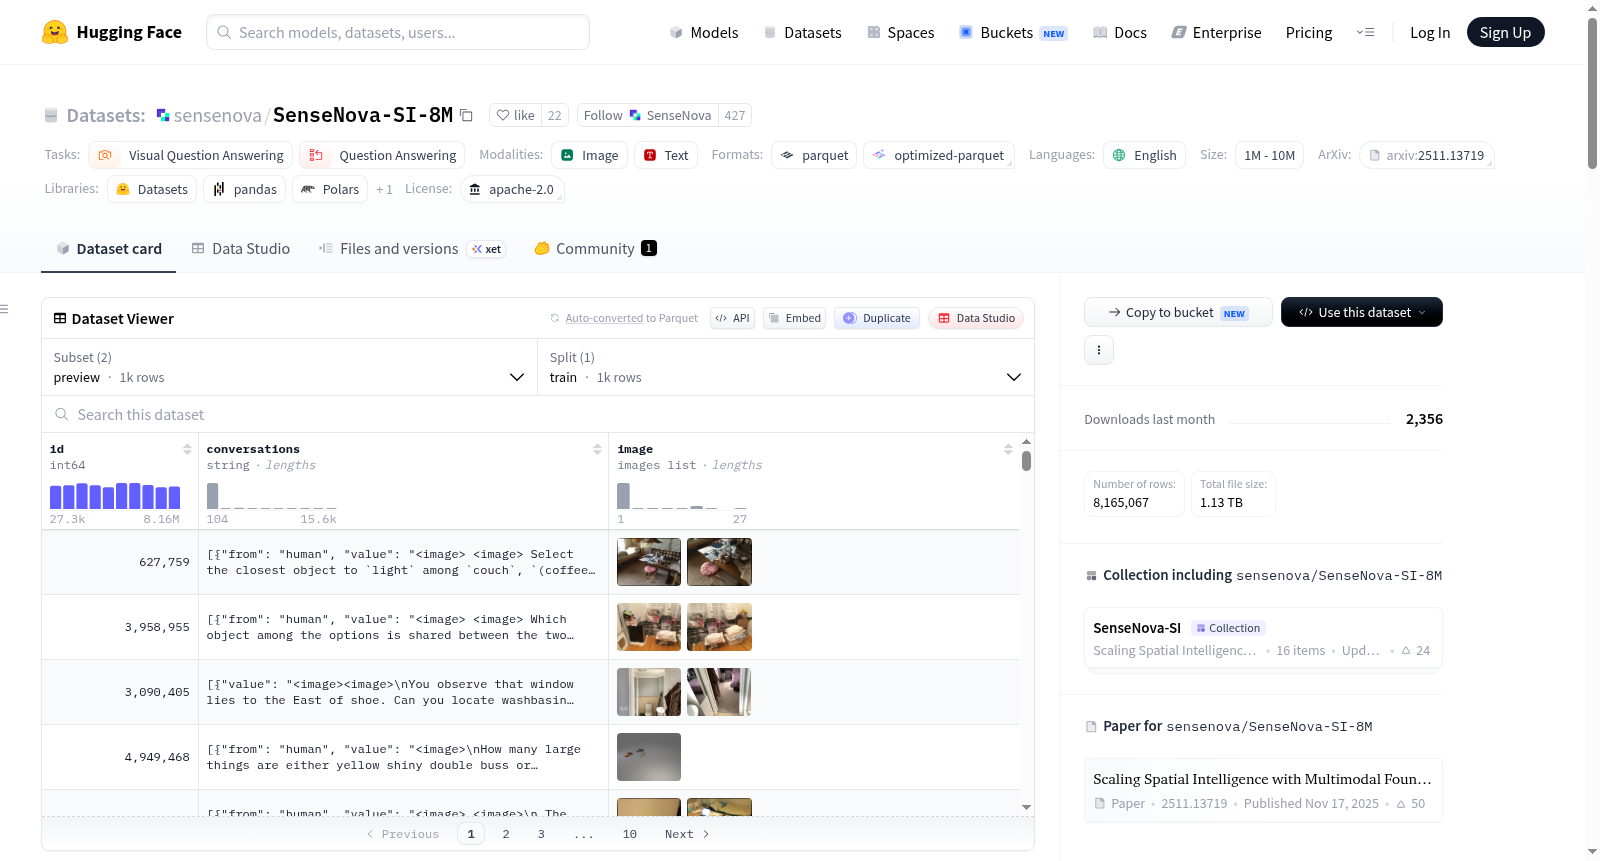
sensenova/SenseNova-SI-8M 数据集图片
构建方式
在空间智能研究领域,多模态基础模型虽已取得显著进展,但在空间感知与推理方面仍存在明显短板。为系统性地攻克这一挑战,研究团队以严谨的层次化空间能力分类法为骨架,精心构建了SenseNova-SI-8M数据集。该数据集涵盖了约816万条经过严格筛选的训练样本,这些样本源自约272万张独立图像,确保了数据的多样性与广度。其构建过程遵循从基础视觉理解模型(如Qwen3-VL和InternVL3)到统一理解与生成模型(如Bagel)的递进式融合路径,旨在通过数据规模与质量的协同提升,孕育出卓越的空间智能。最终,该数据集被用于训练官方推荐模型SenseNova-SI-1.1-InternVL3-8B。
特点
SenseNova-SI-8M数据集以其庞大的规模与严密的组织结构脱颖而出,与之前的参考子集(SenseNova-SI-800K)相比,其训练样本量扩大了近十倍。该数据集的核心特征在于其基于空间能力分类法的系统性编排,确保了覆盖从简单空间关系到复杂空间推理的广泛能力谱。所有图像数据被打包成53个独立且完整的ZIP压缩包,总存储容量约1.1 TB,便于按需加载。此外,数据集采用JSONL格式存储标注文件,每个条目均包含唯一的ID、对多轮对话的结构化记录以及明确的图像路径引用,为模型训练提供了清晰、灵活的数据接口。
使用方法
使用SenseNova-SI-8M数据集进行模型训练与评估时,研究人员应首先根据指南下载全部53个独立的ZIP压缩包,并通过附带的脚本一键解压至同一目录,以重建完整的图像文件树。数据集提供了预览配置(preview),内含1000条样本的parquet文件,便于快速验证数据流。对于完整训练,则需加载full配置对应的主文件SenseNova-SI-8M.parquet或原始的SenseNova-SI-8M.jsonl标注文件。训练完成后,可借助EASI这一开源评估框架,在超过10个主流的空间智能基准测试上对模型的性能进行系统评测,以验证模型的空间智能水平。
背景与挑战
背景概述
空间智能(Spatial Intelligence)是多模态大模型理解物理世界的关键能力,涵盖物体相对位置、空间关系、运动轨迹及三维结构等精细化感知维度。现有视觉语言模型虽在通用问答与识别任务上表现惊艳,却在涉及空间推理的基准测试中暴露出系统性短板。为此,商汤科技研究团队于2025年创造性发布SenseNova-SI系列,并于同年11月经由arXiv公开其核心训练数据集SenseNova-SI-8M。该数据集由中国科学院与商汤科技联合团队主导构建,包含逾816万精心筛选的训练样本,覆盖约272万张独立图像,严格遵循一套细致的能力分类体系。这一资源使小参数模型在多项空间感知指标上实现显著跃升,推动多模态基础模型向具身智能与空间理解深度演进。
当前挑战
当前多模态基础模型在空间智能领域面临的核心挑战在于,传统数据集往往偏向语义理解与物体识别,缺乏对方向、距离、遮挡与深度等空间维度的系统覆盖,导致模型在面对“左侧物体是否比右侧更远”或“两个物体是否处于同一平面”等精细问题时表现脆弱。此外,构建SenseNova-SI-8M本身亦面临艰巨挑战:需在约1.1 TB的庞大数据量中保证样本多样性以规避过拟合风险,同时避免语言捷径(language shortcuts)造成的虚假性能提升;注释过程须跨图像、对话与空间标签统一格式并保证准确性;数据的分布式存储与下载解压亦需设计独立压缩包策略,兼顾可复现性与访问效率。
常用场景
经典使用场景
在视觉与语言交叉领域,SenseNova-SI-8M被设计为空间智能训练的核心语料库,经典使用场景涵盖视觉问答与多模态对话任务。该数据集包含约816万精心筛选的训练样本,覆盖约272万张独特图像,并基于严格的空间能力分类体系组织。研究者通常利用其多轮对话格式,将图像中的空间关系、物体位置与方向等信号融入模型训练,从而显著提升模型对三维空间布局的理解与推理能力,成为培育基础模型空间智能的基准性训练资源。
衍生相关工作
围绕SenseNova-SI-8M已衍生出一系列卓有影响的经典工作。其姊妹数据集SenseNova-SI-800K被广泛用于研究数据规模与模型性能之间的缩放规律,揭示了空间智能随训练数据量增长而涌现的非线性提升趋势。此外,基于该数据集训练的推荐模型SenseNova-SI-1.1-InternVL3-8B在VSI、MMSI等多项空间智能基准上刷新了纪录,成为后续空间感知多模态模型比较的标杆,并推动了EASI评测框架的发展,为空间智能研究的标准化评估提供了重要支撑。
数据集最近研究
最新研究方向
当前,空间智能已成为多模态基础模型研究的核心前沿方向,然而现有模型在空间理解与推理方面仍存在显著不足。SenseNova-SI-8M的提出,正是为了系统性地攻克这一难题。该数据集以严谨的空间能力分类体系为基石,汇聚约816万条精心筛选的训练样本,覆盖逾272万张独特图像,为培育鲁棒且高性能的空间智能提供了大规模、高质量的训练语料。基于该数据集训练的SenseNova-SI-1.1-InternVL3-8B模型,在VSI、MMSI、MindCube-Tiny等多项空间智能基准测试中取得了突破性成绩,平均性能较基线提升超过15个百分点。此外,研究工作还深入探讨了数据规模缩放效应、新兴泛化能力的涌现迹象、过拟合与语言捷径风险、空间思维链推理的初步探索等前沿议题,为空间智能的理论深化与下游应用验证铺平了道路,标志着多模态基础模型在空间认知能力上迈出了关键一步。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

