
ArXivSignals-DeepSummaries
收藏官方服务:
资源简介:
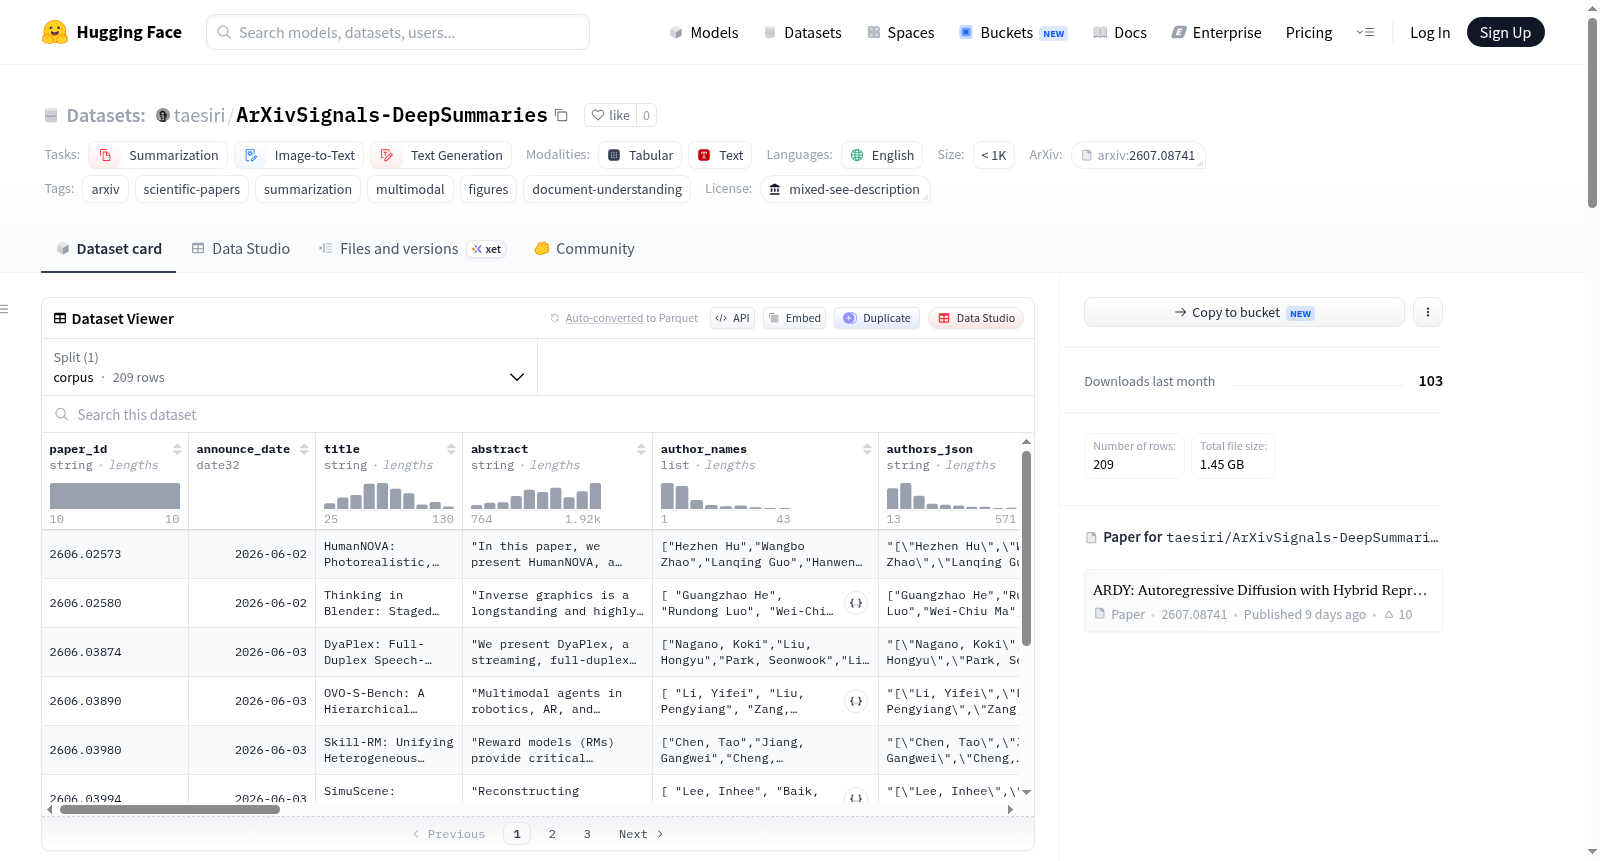
ArXivSignals DeepSummaries是一个持续更新、按天分区的多模态数据集,包含由编码代理构建的arXiv论文深度视觉摘要。每个摘要由代理在论文的LaTeX源码环境中工作生成,它阅读全文并撰写结构化的编辑叙事(称为内容规范spec_json),同时嵌入从LaTeX中提取并优化过的真实图表作为可变长度的图像数组。数据集规模较小(少于1000个样本),每个数据行包含:arXiv元数据(如论文ID、标题、摘要、作者、类别)、主题和研究实验室标签、结构化的摘要规范(包含编辑标题、副标题、简要总结、统计带以及包含文本、数学公式、图表引用等的类型化章节)、论文图表列表(嵌入为图像字节,格式为JPEG/PNG,宽度不超过1500像素)、构建溯源信息(使用的后端、模型、令牌数、耗时等)以及指向自包含归档HTML页面的路径。该数据集适用于摘要生成、图像到文本和文本生成等任务,可用于研究科学文档理解、多模态摘要生成和代理生成内容。数据集的摘要文本为机器生成,图表提取自原始arXiv论文(许可证各异),仅供研究索引使用,并附有完整的论文归属信息。
创建时间:
2026-07-10
原始信息汇总
数据集概述:ArXivSignals DeepSummaries
ArXivSignals DeepSummaries 是一个持续更新的、按天分区的数据集,包含由代码智能体基于 arXiv 论文的 LaTeX 源码自动生成的深度视觉摘要。
核心内容
- 摘要生成方式:一个编码智能体阅读论文全文,编写结构化的“内容规格”(content spec)作为编辑叙事,并将论文中真实的图表(从 LaTeX 中提取并渲染为网络优化版本)作为可嵌入的可变长度图像数组一同提供。
- 关联数据集:该数据集是
taesiri/ArXivSignals(目录:元数据+信号)和taesiri/ArXivSignals-FullText(OCR 全文)的深度摘要伴侣,三者通过paper_id关联。 - 在线预览:每行数据可在 ArXivSignals 网站
https://arxivsignals.io/papers/<paper_id>上实时渲染查看(例如2607.08741)。
数据构成(summaries 配置)
每行数据包含以下字段:
- arXiv 元数据:
paper_id、announce_date、title、abstract、author_names(+带 affiliation 的authors_json)、categories、primary_category、page_count - 标签:
keyword_slugs/keyword_labels(主题分类)和lab_slugs/lab_labels(研究实验室归属) - 摘要内容:
spec_json(完整的 Tier-1 内容规格 JSON),包括:编辑标题/副标题、tl;dr、统计栏,以及带类型的章节(heading、prose[含$math$]、figure/figrow、table、callout、stat)。图表引用与figures[].file匹配。 - 图表:
figures(list<struct{file, width, height, image}>):论文中被摘要使用的图表,字节嵌入(JPEG/PNG,宽度 ≤1500 px),每行数量可变(0–~40 个)。 - 构建来源:
backend(codex/claude)、model、tokens_in、tokens_out、duration_s、built_at - 离线页面路径:
html_path:该论文的自包含存档页面在仓库中的路径(位于pages/YYYY/MM/DD/<id>.html,所有图片内联,无需网络即可在浏览器中打开)。
使用与渲染
- 加载:使用 Hugging Face
datasets库加载"taesiri/ArXivSignals-DeepSummaries"数据集,并可通过cast_column将图表字节解码为 PIL 图像。 - 离线渲染:利用
html_path下载自包含 HTML 页面(图片内联为 data URI,数学公式预排版为内联 SVG),无需网络和 JavaScript 即可在浏览器中打开(唯一外部引用 Google Fonts 可优雅降级)。 - 图像提取:在
cast_column后,每个图表为 PIL 图像,可按file名称保存为文件。 - 自定义渲染:
spec_json是机器可读的真相来源,包含完整的内容结构(标题、tl;dr、统计栏、有序章节列表),可通过 Markdown + TeX 渲染器(MathJax/KaTeX)重新渲染摘要。
构建方式
- 叙事:智能体(默认:Codex / GPT-5.6 Luna,低推理模式;部分行由 Claude 构建)在包含论文 LaTeX 源码和 PDF 的工作区中工作,编写规格并通过确定性布局/忠实度审计。
- 图像:从论文 LaTeX 图形中提取;表格为论文排版渲染为 PNG。经确定性后处理(内容哈希、缩小至 ≤1500 px、大文件重新编码为 JPEG)。
- 组装确定性:智能体从不编写 HTML;
spec_json是真相来源,存档页面由其确定性渲染生成。
分区与更新
- 按天分区:基于
announce_date(Hivedate=文件夹),每日刷新——重建的摘要会重新发布在其所属日期的分区中。
来源、许可与删除
- 摘要文本:由 ArXivSignals 机器生成的分析,请对照论文验证重要声明。
- 图表许可:图表和表格从底层 arXiv 论文中提取,其各自许可各异。为研究和索引目的重新分发,并通过
paper_id(https://arxiv.org/abs/<paper_id>)提供完整归属。作者如需移除论文的摘要或图表,可在该数据集上发起讨论。
搜集汇总
数据集介绍
构建方式
ArXivSignals-DeepSummaries数据集汇聚了arXiv论文的深度视觉摘要,每篇摘要均由编码代理在论文原始的LaTeX源代码中构建而成。该代理首先通读全文,生成结构化的内容规格说明书,随后从LaTeX中提取论文中真实的图表元素,并将其渲染为网络优化后的嵌入式图像数组。叙事内容由Agent(默认使用Codex/GPT-5.6 Luna模型)在包含论文LaTeX源码与PDF的工作空间中撰写,并通过确定性布局与忠实度审核。图像从LaTeX图形中提取,表格以论文自身排版渲染为PNG格式,经过内容哈希、尺寸压缩及JPEG重编码等后处理步骤。整个组装过程无需Agent编写HTML,而是以规格说明书为唯一真理源,最终确定性生成档案页面。数据集按公告日期进行天级分区,每日刷新,重建的摘要会重新归档至其对应日期下。
使用方法
用户可通过HuggingFace datasets库便捷加载数据集,调用load_dataset('taesiri/ArXivSignals-DeepSummaries', 'summaries', split='corpus')即可获取。随后可利用cast_column方法将嵌入的图表字节解码为PIL图像。每篇摘要均提供了一个指向该论文独立档案页面的html_path,该页面内嵌了所有图像与预排版为SVG格式的数学公式,无需网络与JavaScript即可在浏览器中直接打开。用户亦可自行渲染:规格说明书(spec_json)作为机器可读的真值来源,其内部的表格与图表引用与figures列表中的file字段一一对应,通过字典查找即可解析。将散文文本输入任何支持Markdown与TeX的渲染器(如MathJax或KaTeX),便可自定义布局重新呈现摘要内容。
背景与挑战
背景概述
ArXivSignals-DeepSummaries数据集由研究者taesiri等人创建,旨在应对科学文献日益增长的阅读需求与信息过载之间的矛盾。该数据集于2024年首次发布,聚焦于arXiv预印本平台的论文,通过自动化代理深入解析LaTeX源码,生成结构化的视觉化摘要,涵盖全文叙事、图表与表格。其核心研究问题在于如何利用多模态技术提升学术论文的可理解性与可访问性,从而推动科学知识传播的民主化。该数据集在摘要生成、文档理解及多模态学习领域具有开创性意义,为后续研究提供了高质量基准,并促进了自动化科学交流工具的发展。
当前挑战
数据集面临多重挑战。首先,在领域问题层面,传统摘要方法难以兼顾论文的视觉元素(如图表)与文本内容的深度融合,而ArXivSignals-DeepSummaries通过代理生成的叙事性摘要需确保逻辑严谨性与图表引用的准确性,这对模型的语言理解与视觉推理能力提出了极高要求。其次,在构建过程中,从LaTeX源码中可靠提取并优化图表面临格式多样性与版权归属的挑战;同时,代理需通过严格的布局与忠实度审核,以避免生成误导性内容。此外,数据集持续更新与多版本维护(如模型后台切换)增加了标准化难度,而图表再分发涉及的法律合规问题也需谨慎处理。
常用场景
经典使用场景
ArXivSignals-DeepSummaries数据集的核心应用在于为科研论文提供结构化的深度摘要与可视化解释。该数据集通过编码智能体深入处理每篇论文的LaTeX源码,自动生成包含编辑性叙述、统计信息带及原版图表的多模态摘要。典型使用场景包括学术文献的快速理解与浏览,研究者可直接通过该数据集获取论文的核心贡献、实验设置与关键图表,大幅提升文献调研效率。其独特之处在于摘要内容与原始论文的图表、表格精确对应,形成了一种机器生成的、具备可验证性的论文解读范式。
解决学术问题
该数据集系统性地解决了学术文献数量激增背景下研究者信息过载的难题。传统论文阅读需投入大量时间解析全文结构与图表细节,而ArXivSignals-DeepSummaries通过构建结构化的视觉摘要,将一篇论文精炼为包含标题、副标题、TL;DR(太长不看)、统计信息带以及分节叙述的紧凑格式,显著降低了认知负荷。更为关键的是,它解决了跨学科文献理解的障碍,使得非专业领域的研究者也能快速把握论文精髓,促进了交叉学科的知识流动与创新。此外,该数据集为计算语言学领域的自动摘要、多模态理解等提供了大规模、高质量的训练与评估基准。
实际应用
在实际应用层面,该数据集为学术搜索引擎、文献管理工具以及科学传播平台提供了底层能力支撑。例如,在ArXivSignals网站中,每篇论文的深度摘要页面正是基于该数据集渲染而成,用户无需下载或解析LaTeX源码即可直观浏览论文要点与图像。这一数据形态也赋能了学术推荐系统,通过对摘要内容的语义分析,可以实现更为精准的论文相关性匹配与个性化推荐。在科研教育场景中,该数据集可作为教学辅助材料,帮助研究生快速入门前沿领域。同时,其自包含的HTML归档页面无需网络即可离线查看,极大便利了在无互联网环境下的文献研读。
数据集最近研究
最新研究方向
ArXivSignals-DeepSummaries数据集的前沿研究方向聚焦于利用智能编码代理对arXiv科学论文进行深度多模态摘要生成,通过嵌入论文原生的图表、表格与数学公式,构建结构化且视觉化的可解释摘要。该方向与当前学术界对科学文献自动化理解与多模态交互的热点紧密相连,尤其在大型语言模型与代理系统快速演进的浪潮中,它突破了传统文本摘要的局限,实现了从纯文本到图文混排的语义跃迁。该数据集的意义在于为科学传播、文献检索及跨学科研究提供了可复现的高质量基准,其日更特性和确定性组装流程确保了数据的时效性与透明度,对推动学术信息压缩、知识图谱构建及智能科研辅助系统的落地具有深远影响。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


