
遇见数据集

ilsp/MMBench_Greek

收藏
Hugging Face2026-07-20 更新2026-07-22 收录
官方服务:

资源简介:

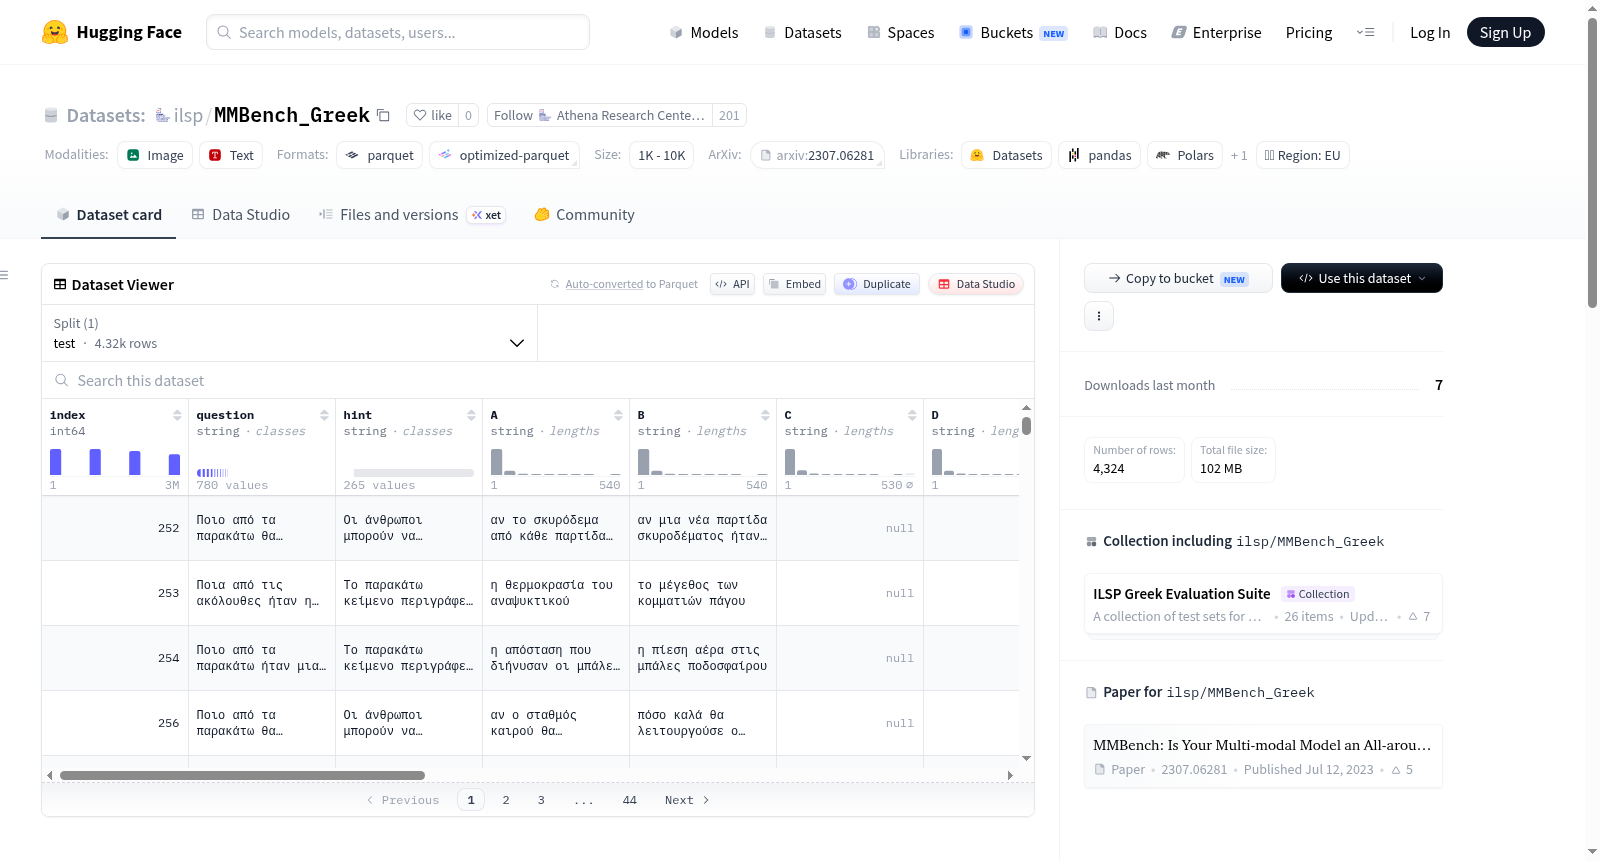
该数据集是MMBench的希腊语翻译版本,MMBench是一个用于评估多模态和视觉语言模型的多项选择基准。此版本的目标是使MMBench可作为评估希腊语能力视觉语言模型的基准。数据集保持了与原始MMBench_dev数据集相同的结构和列名,文本字段已翻译成希腊语,而元数据字段保持不变。每个示例包含一个图像、一个问题、可选提示文本、多项选择答案选项、正确答案标签以及类别/来源元数据。

This dataset is a Greek translation of MMBench, a multiple-choice benchmark for evaluating multimodal and Vision-Language Models. The goal of this version is to make MMBench usable as an evaluation benchmark for Greek-capable VLMs. The dataset keeps the same structure and column names as the original MMBench_dev dataset. The text fields have been translated into Greek, while metadata fields are kept unchanged. Each example contains an image, a question, optional hint text, multiple-choice answer options, the correct answer label, and category/source metadata.
提供机构:
ilsp
搜集汇总
数据集介绍
ilsp/MMBench_Greek 数据集图片
构建方式
MMBench_Greek是源自国际通用多模态评估基准MMBench的希腊语译本,旨在为具备希腊语能力的视觉-语言模型提供本地化的评测工具。数据集完整保留了原版MMBench_dev的结构与列名,仅将问题、提示与选项等文本字段翻译为希腊语,而元数据字段(如图像路径、来源、类别标签)则保持原样。每一条样本均由图像、问题、可选提示、四个候选答案、正确答案标注以及类别与来源元数据构成,确保评测逻辑与原始基准一致。
特点
该数据集包含4324条测试样本,覆盖多类别、多模态的视觉问答场景,具备丰富的图像-文本对齐信息。希腊语翻译保障了语言层面的文化适配性,同时保留原版基准的精细分类体系(如12类上层类别),便于研究者针对不同能力维度进行细粒度评估。此外,数据集中带有可选的提示文本与注释字段,为模型推理提供更多上下文支持。
使用方法
该数据集专为评估希腊语视觉-语言模型在多项选择问答任务上的表现而设计。典型的使用方式为构建推理提示,要求模型在观察图像后阅读希腊语问题与选项,并输出唯一正确的标签(如A/B/C/D)。研究者可直接从HuggingFace加载test分割数据,配合原始MMBench的评估脚本和度量标准,实现与原始基准一致的可比评估流程。
背景与挑战
背景概述
MMBench_Greek数据集诞生于多模态与视觉语言模型(VLM)评估需求日益增长的背景下,其原始版本MMBench由香港中文大学、商汤科技等机构的研究人员于2023年创建,旨在系统性地评测多模态模型的综合能力。该数据集通过涵盖多个视觉-语言任务的多项选择题形式,为模型在细粒度理解与推理上的表现提供了标准化基准。MMBench_Greek在保持原始结构的基础上,将文本字段翻译为希腊语,填补了希腊语视觉语言模型评估领域的空白,推动了多语言多模态研究的进展,对促进低资源语言环境下视觉语言模型的发展具有重要影响力。
当前挑战
MMBench_Greek所应对的领域挑战在于解决希腊语视觉语言模型缺乏高质量、标准化评估基准的问题。现有主流数据集多集中于英语,导致模型在希腊语多模态任务上的性能难以可靠衡量。在构建过程中,挑战包含对原始MMBench中大量复杂视觉-语言问题的精确翻译,需确保语义等价性与文化适应性,同时需维持题目原有的判别难度以避免信息丢失。此外,评估过程需设计适用于希腊语的提示,促使模型理解语言与图像的关联,并输出正确的答案选项,从而真实反映模型在跨语言场景下的多模态能力。
常用场景
经典使用场景
MMBench_Greek作为MMBench的希腊语翻译版本,沿袭了原版基准测试的核心结构,旨在评估多模态视觉-语言模型在希腊语环境下的综合能力。该数据集涵盖4324个测试样本,每个样本包含图像、问题、可选提示、四个候选答案及正确答案标签,适用于多模态选择题问答的标准化评估。研究者通过让模型观察图像、阅读希腊语问题并输出正确选项标号,来衡量模型在跨语言多模态理解任务中的表现。
解决学术问题
MMBench_Greek解决了多模态视觉-语言模型在非英语、尤其是希腊语场景下评估标准缺失的学术难题。原版MMBench主要面向英语环境,而希腊语作为小语种在视觉-语言模型评测领域长期处于空白。该数据集通过系统翻译与严格对齐,为研究者提供了衡量模型在希腊语多模态推理、跨语言视觉问答及文化特定场景理解能力的可靠基准。其意义在于推动多模态模型从英语中心向语言多样性拓展,促进包容性人工智能的发展。
衍生相关工作
MMBench_Greek的发布催生了一系列相关研究工作。一方面,它直接衍生出其他小语种版本的MMBench,如阿拉伯语、印地语等,形成多语言多模态评估体系。另一方面,研究者基于该数据集提出针对希腊语视觉-语言模型的微调策略、跨语言迁移学习方法以及低资源多模态模型的涌现能力分析。经典工作如X-VLM的多语言扩展、希腊语多模态预训练模型的基准测试,以及跨文化视觉推理的对比研究,均以MMBench_Greek为重要评估平台。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

